初稿;2026/09/21(月)
はじめに
いつもこのpivot_wider()とpivot_longer()は全部忘れていて、必要になる度に大混乱してしまう。ということで、ここにメモっておくことにする。
library(tidyverse)使用するデータ
オリジナルのデータとして、以下の画像のような形のデータフレームを使用する。これは、使った動物の数を6匹とし、それらに各濃度(列dose)の薬剤CPDと対照となるDMSO(列drug)を投与し、その24及び48時間後(列time)の腫瘍、血液、肝臓、肺、脾臓、脳中の薬剤濃度(列concentration)を測定して得られた結果を想定した。
統計処理を考える場合、得られるデータは縦型(longer)になっているはずである。なので、ここで設定したオリジナルのデータフレームも縦型とする。データベースってのは、基本的に1変数(列)に対して1種類の値が入っている。そうしなければすぐに解析を始めることが出来ず、データクリーニングに膨大な時間を費やす羽目になる。
以下が上記のデータを生成するコードである。値はrnorm()を使用する。最後に、24時間後と48時間後毎の各組織中濃度として、データフレームanalysis_24とanalysis_48hを作成する。ここでのポイントは列order_tissueである。これは、各マウスで、tumor、blood、liver、lung、screen、brainにそれぞれ1から6までの番号を付けた列である。他に重要なものとしては、列orderである。これを昇順に並べれば、必ず元のデータの並びに戻ることが出来る。そういった、言わばメインキーになる番号は、どんなデータでも付けておかなければならない。以下のコードを流せば、表が得られる。
# Original data probably longer format.
# tumor, blood, liver, lung, spleen, brain, 6 tissues
# 1, 3, 10, 30, 100, 5 doses
# N = 6 in each group

original_24h <- data.frame(
  drug = c(rep("CPD", each = 6*6, times = 5), rep("DMSO", each = 6*6, times = 1)),
  dose = c(
    rep(c("1mg/kg", "3mg/kg", "10mg/kg", "30mg/kg", "100mg/kg"),
        each = 6*6,
        times = 1),
    rep("0mg/kg",
        each = 6*6,
        times = 1)),
  tissue = c(
    rep(c("tumor", "blood", "liver", "lung", "spleen", "brain"),
        each = 1,
        times = 6*5),
    rep(c("tumor", "blood", "liver", "lung", "spleen", "brain"),
        each = 1,
        times = 6*1)),
  concentration = c(
    rnorm(6*5*6, mean = 20, sd = 4),
    rnorm(6*1*6, mean = 0.5, sd = 0.1)),
  time = "24h"
)

original_48h <- data.frame(
  drug = c(rep("CPD", each = 6*6, times = 5), rep("DMSO", each = 6*6, times = 1)),
  dose = c(
    rep(c("1mg/kg", "3mg/kg", "10mg/kg", "30mg/kg", "100mg/kg"),
        each = 6*6,
        times = 1),
    rep("0mg/kg",
        each = 6*6,
        times = 1)),
  tissue = c(
    rep(c("tumor", "blood", "liver", "lung", "spleen", "brain"),
        each = 1,
        times = 6*5),
    rep(c("tumor", "blood", "liver", "lung", "spleen", "brain"),
        each = 1,
        times = 6*1)),
  concentration = c(
    rnorm(6*5*6, mean = 20, sd = 4),
    rnorm(6*1*6, mean = 0.5, sd = 0.1)),
  time = "48h"
)

original <- rbind(original_24h, original_48h)

table(original$tissue)
# blood  brain  liver   lung spleen  tumor
#     72     72     72     72     72     72
table(original$drug)
 # CPD DMSO
 # 360   72
table(original$dose)
  # 0mg/kg 100mg/kg  10mg/kg   1mg/kg  30mg/kg   3mg/kg
  #     72       72       72       72       72       72

original <- original %>% mutate(order = 1:nrow(original),
                                animal = "Ms",
                                order_tissue = rep(c(1:6), times = 72),
                                order_animal = rep(c(1:6), each =6, times=12))


original <- original %>% unite(col = sample_id, sep="_", animal, order, remove = FALSE)
original <- original %>% unite(col = tissue_id, sep="_", tissue, order_animal, remove = FALSE)
original <- original %>% unite(col = drug_dose, sep="_", drug, dose, remove=FALSE)

analysis_24h <- original %>% filter(time == "24h")
analysis_48h <- original %>% filter(time == "48h")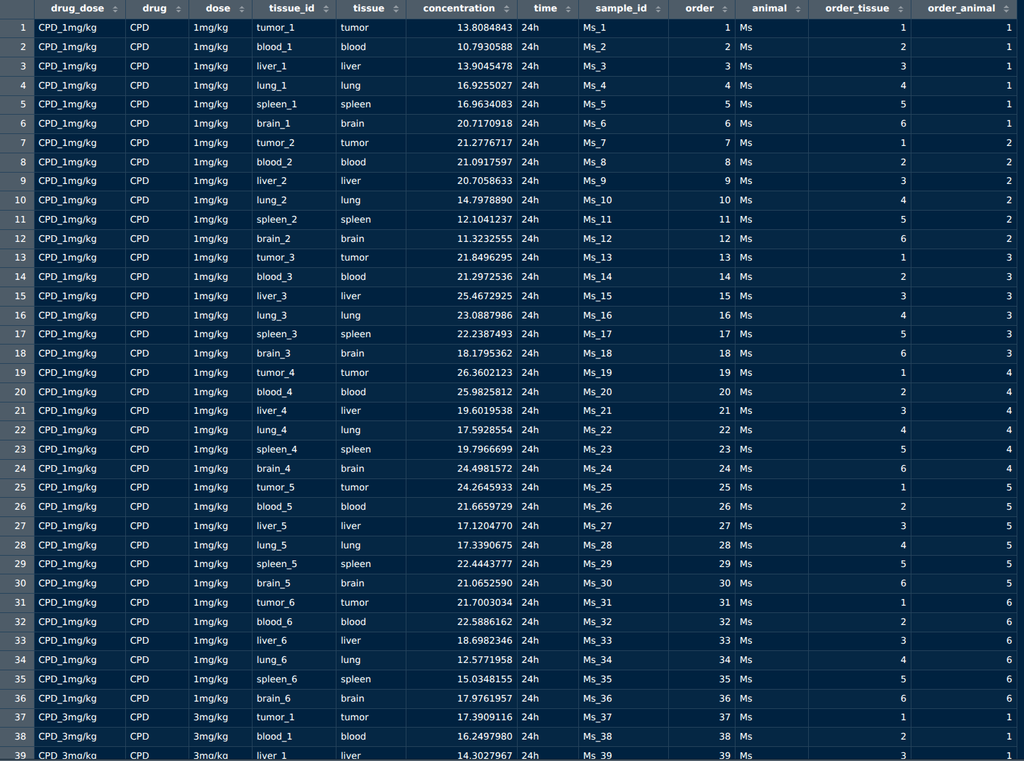
pivot_wider
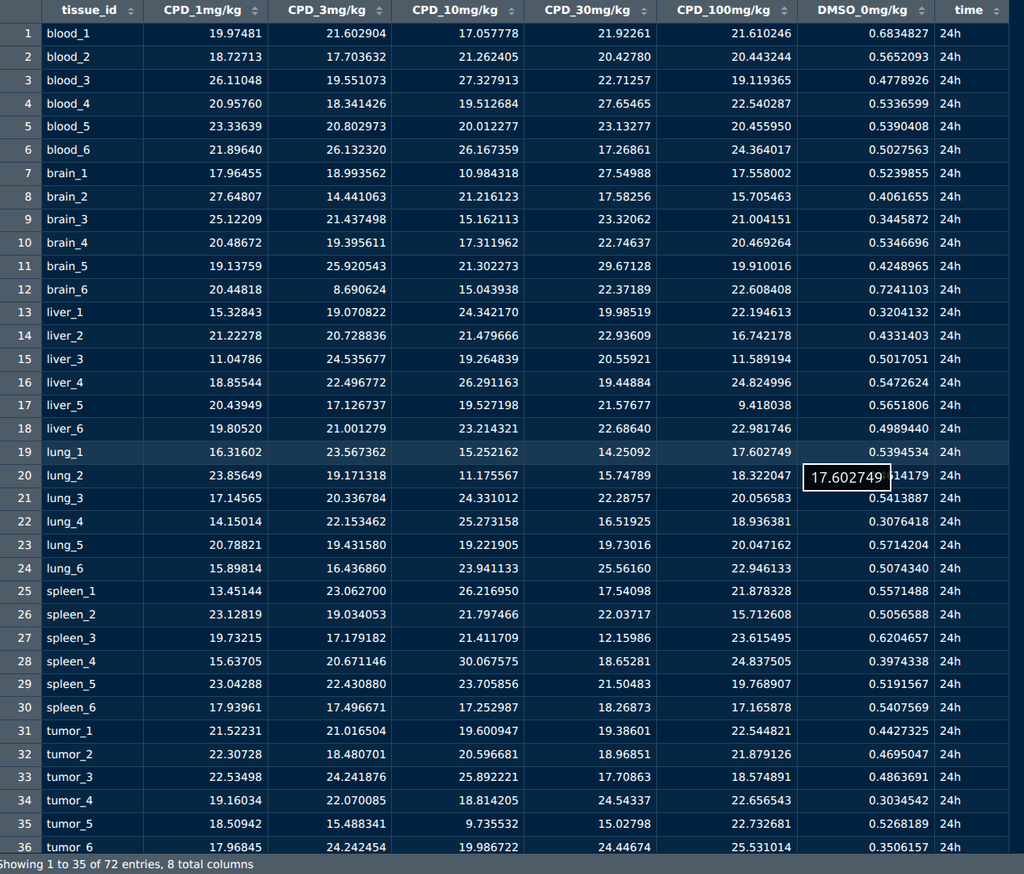
ここでは、最初に列tissueにある値、すなわち、tumor、blood、liver、lung、spleen、brainの値をリストwider_24hの各要素に入れ、それらに対してpivot_wider()を使っていく。pivot_wider()でよく使う引数は以下の表の通りである。
| 引数 | 説明 |
|---|---|
| id_cols = | 残す列。ここでは列tissue_idを使用した。値は全部異なっている必要がある。 |
| names_from= | 横方向に伸ばす列。ここでは列drug_doseを使用した。 |
| value_from= | 横方向に伸ばした列に入れる値を保持した列。ここは列concentrationを使用した。 |
リストwider_24hの各要素はbind_rows()で結合し、最後に、24時間後と48時間後のデータをさらにbind_rows()で結合する。
# longer to Wider

#24h
wider_24h <- list()
tissue_name <- names(table(analysis_24h$tissue))
for(i in 1:length(tissue_name)){
  wider_24h[[i]] <- analysis_24h %>% filter(tissue == tissue_name[i]) %>%
    pivot_wider(id_cols = tissue_id,
                names_from = drug_dose,
                values_from = concentration)

}

wider_24h_df <- bind_rows(wider_24h) %>% mutate(time = "24h")

# 48h
wider_48h <- list()
tissue_name <- names(table(analysis_48h$tissue))
for(i in 1:length(tissue_name)){
  wider_48h[[i]] <- analysis_48h %>% filter(tissue == tissue_name[i]) %>%
    pivot_wider(id_cols = tissue_id,
                names_from = drug_dose,
                values_from = concentration)

}
wider_48h_df <- bind_rows(wider_48h) %>% mutate(time = "48h")

wider <- bind_rows(wider_24h_df, wider_48h_df)以下のデータフレームが出来上がる。
pivot_widerでついでに平均値と標準偏差を計算する
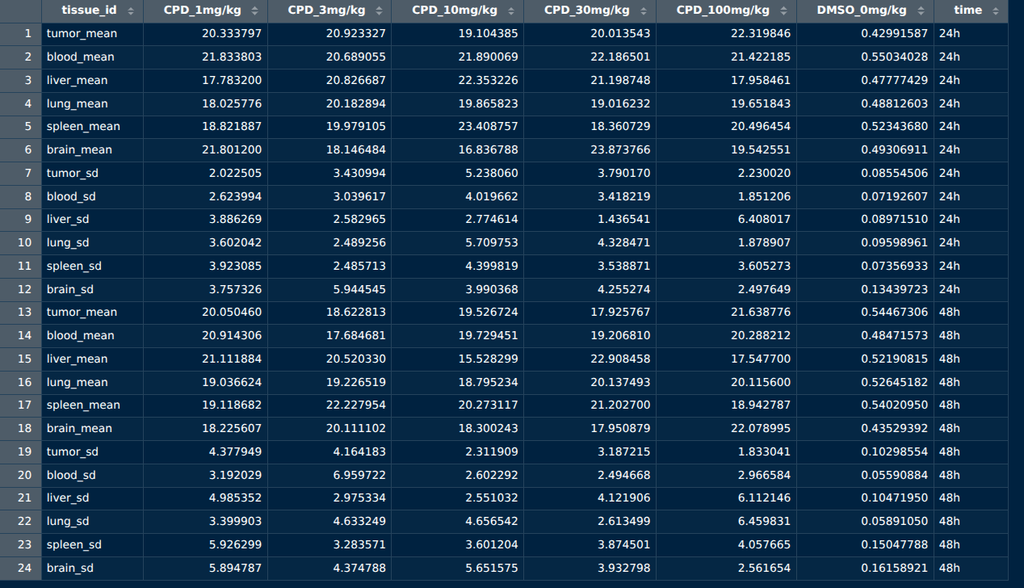
pivot_wider()の引数values_fnには関数を入れることが出来る。この場合、mean()とsd()を入れてしまえば、マウス毎の各臓器の平均値と標準偏差が計算出来る。上記のpivot_wider()との違いは、引数id_colsに入れる列が違うことである。平均値や標準偏差、もしくは他の関数で複数の値をまとめてしまう場合、引数id_cols=の値は重複していても大丈夫である。代表値や統計量の一つにまとまってしまうためである。
| 引数 | 説明 |
|---|---|
| id_cols = | 残す列。ここでは列tissueを使用した。引数values_fnを使って代表値にしてしまう場合、各臓器毎に番号を振ったるする必要がない。 |
| names_from= | 横方向に伸ばす列。ここでは列drug_doseを使用した。 |
| value_from= | 横方向に伸ばした列に入れる値を保持した列。ここは列concentrationを使用した。 |
| values_fn= | Rに組み込まれている関数や自作の関数名を入れることが出来る。ここではmean()とsd()を使用した。 |
# calculate mean and sd
wider_24h_mean <- analysis_24h %>% pivot_wider(id_cols = tissue,
                                  names_from = dose,
                                  values_from = concentration,
                                  values_fn = mean) %>% mutate(stats = "mean", time = "24h")
wider_24h_mean <- wider_24h_mean %>% unite(col = tissue_id, sep="_", tissue, stats)

wider_24h_sd <- analysis_24h %>% pivot_wider(id_cols = tissue,
                                  names_from = dose,
                                  values_from = concentration,
                                  values_fn = sd) %>% mutate(stats = "sd", time = "24h")
wider_24h_sd <- wider_24h_sd %>% unite(col = tissue_id, sep="_", tissue, stats)


wider_48h_mean <- analysis_48h %>% pivot_wider(id_cols = tissue,
                                  names_from = dose,
                                  values_from = concentration,
                                  values_fn = mean) %>% mutate(stats = "mean", time = "48h")
wider_48h_mean <- wider_48h_mean %>% unite(col = tissue_id, sep="_", tissue, stats)


wider_48h_sd <- analysis_48h %>% pivot_wider(id_cols = tissue,
                                  names_from = dose,
                                  values_from = concentration,
                                  values_fn = sd) %>% mutate(stats = "sd", time = "48h")
wider_48h_sd <- wider_48h_sd %>% unite(col = tissue_id, sep="_", tissue, stats)

wider_stats <- bind_rows(wider_24h_mean, wider_24h_sd, wider_48h_mean, wider_48h_sd)以下のデータフレームが出来上がる。
pivot_longer
基本的に、1変数(列)に入る値は1種類とすれば、縦型になる。ただし、エクセルしか使ってこなかった輩は、大抵自由フォーマットで、自分しかわからないような、汎用性の全くないフォーマットを作成してくる。この場合は、最初にpivot_longer()を使ったり、pivit_wider()を使ったりしながら作業を進める必要がある。
特に数十列くらいのデータだったら別にエクセルでもいいのだが、これが数百、数千列あったらどうするつもりだろうか。絶対手作業は無理である。
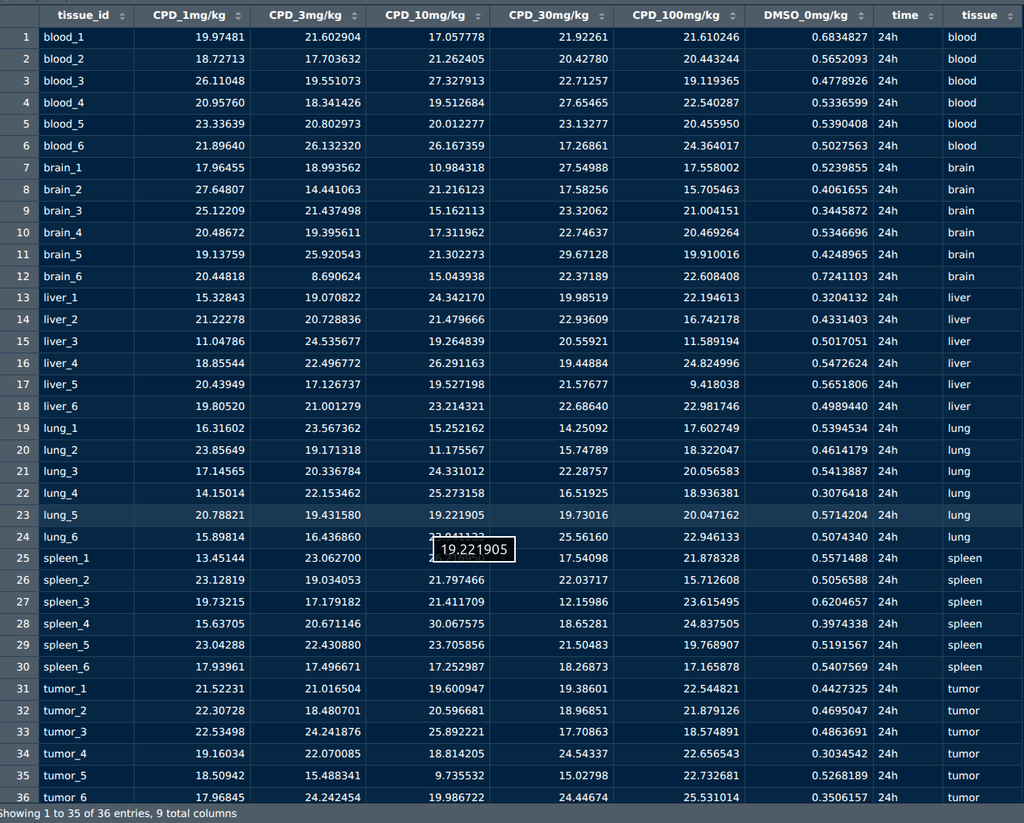
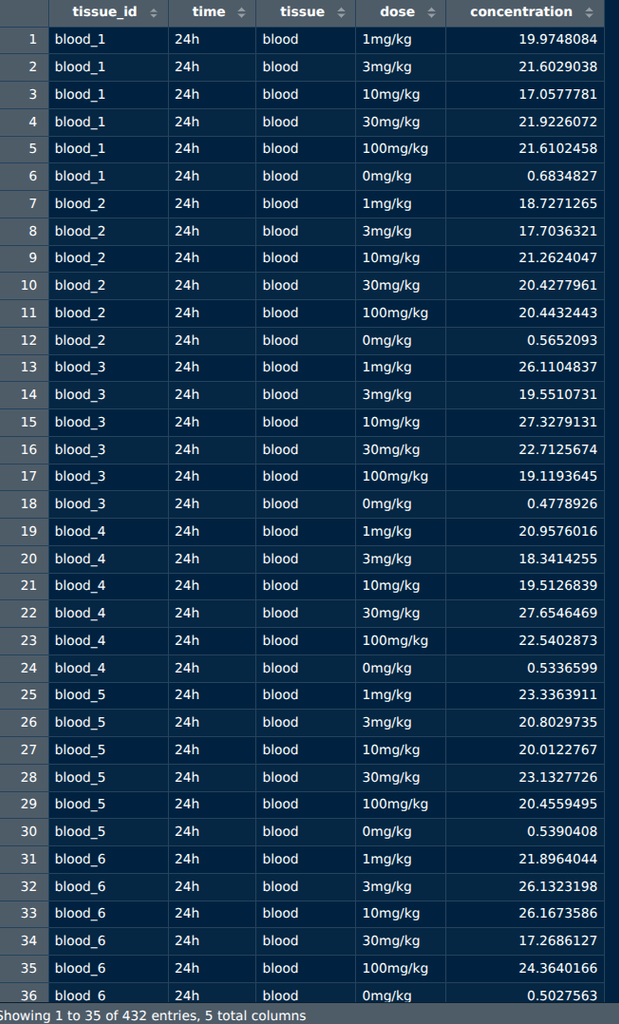
以下の表にpivot_longer()の引数をまとめる。ここで最初に使用するデータフレームwider_24h_2は、pivot_wider()で作成したデータフレームwiderから、24時間後の値を抽出したデータフレームである。
| 引数 | 説明 |
|---|---|
| cols = | 縦にする値の範囲(基本的に列)。ここでは2:7、すなわち、データフレームwider_24h_2の、2列目から7列目を指定した。 |
| names_to = | 新しく作成する列。ここでは列doseを新しく作成する。 |
| values_to = | 新しく作成する列に入れる値が入っている列。ここでは列concentrationを入れる。 |
以下の表がデータフレームwider_24h_2である。データフレームwider_48h_2はデータフレームwiderから、列timeが48hのものを抽出して作成したものである。
# Wider to longer

# 24h

wider_24h_2 <- wider %>% filter(time == "24h")
wider_24h_2 <- wider_24h_2 %>% mutate(tissue = gsub(pattern = "_\\d+$", replacement = "", x = tissue_id))
wider_24h_2[,2:7] <- wider_24h_2[,2:7]  %>% apply(MARGIN = 2, FUN = as.numeric)
wider_24h_2 <- wider_24h_2 %>% as_tibble()

longer_24h <- wider_24h_2 %>% pivot_longer(cols = 2:7, names_to = "dose", values_to = "concentration")
longer_24h <- longer_24h %>% mutate(dose = gsub(pattern = "^.*_", replacement = "", x=dose))


# 48h

wider_48h_2 <- wider %>% filter(time == "48h")
wider_48h_2 <- wider_48h_2 %>% mutate(tissue = gsub(pattern = "_\\d+$", replacement = "", x = tissue_id))
wider_48h_2[,2:7] <- wider_48h_2[,2:7]  %>% apply(MARGIN = 2, FUN = as.numeric)
wider_48h_2 <- wider_48h_2 %>% as_tibble()

longer_48h <- wider_48h_2 %>% pivot_longer(cols = 2:7, names_to = "dose", values_to = "concentration")
longer_48h <- longer_48h %>% mutate(dose = gsub(pattern = "^.*_", replacement = "", x=dose))

longer <- bind_rows(longer_24h, longer_48h)
まとめ
これで、必要になったときにこの記事を見れば、データフレームを整えるのも多少は捗るに違いない。多分。