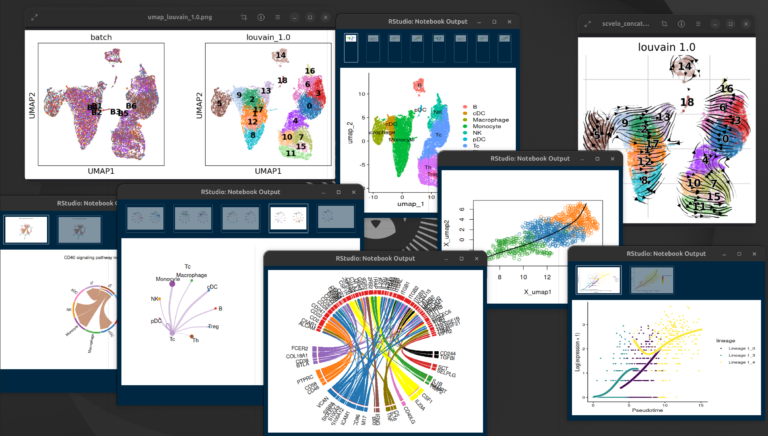
2026/09/19(日);初稿
- 1 はじめに
- 2 公開データのダウンロード
- 3 CellRangerによるカウントマトリックスの作成
- 4 Scanpyによるプロセッシング、次元削減、クラスタリング、UMAPによる可視化
- 5 velocyteとscVeloによるRNA velocity解析
- 6 StreamとStream2によるTrajectory inference(疑似系譜解析)
- 7 使用するRパッケージ
- 8 h5adからSeuratオブジェクト(V5)への変換
- 9 escape、GSVA、fgsea、ssGSEA2によるPsudoblukのエンリッチメント解析
- 10 Cellchat、nichenetr、CellPhoneDB、Liana+による細胞-細胞コミュニケーション解析
- 11 SlingshotとtradeSeqによるpseudotime analysis(疑似時間解析)
- 12 まとめ
- 13 まとめ2
はじめに
最近はシングルセルRNAシークエンスも一般的な解析技術になってきた。それ単発の解析では、もうFigureを一つしか作れないような状態であり、空間トランスクリプトームや他のモダリティー(技術や手法)と合わせて、マルチオミクスという形で着目する現象を解明していく、というストラテジーが必要と言える。
逆に言えば、シングルセルRNAシークエンスの解析は、もはやスタンダードな方法を使用することが出来るということである。さらに、昨今では公開データも充実してきており、もうこの技術も普通のものとなってきている。
技術が安定してきたところで、公開データを使って、一連のシングルセルRNAシークエンスの解析方法(ただし、この解析にはDEG;Differentially Expressed Gene解析は含んでいない)を述べる。ダウンロードした公開データは対照群と処置群を比較は行っていなかった。この解析ではDEG解析は行っていない。よって、ここで述べるのはシングルセルRNAシークエンス解析による細胞の同定方法とその性質についての解析方法となり、シングルセルRNAシークエンスとしては若干物足りない、言ってみれば50%くらいしか網羅していない解析になってしまった。DEG解析を含んだ解析方法については別の記事にまとめようと思う。
ここで書いたコードは、ここで販売している(https://kts-research-blog.stores.jp/items/6aaf64caac00181cc4d8a089)
公開データのダウンロード
データとして、この論文(https://www.frontiersin.org/journals/immunology/articles/10.3389/fimmu.2023.1150985/full、https://pubmed.ncbi.nlm.nih.gov/37342338/)に載っている、免疫チェックポイント阻害剤を投与された肝細胞癌患者のPBMC(Peripheral Blood Monolayer Cells)から得られたシングルセルRNAシークエンスの結果(シングルセルトランスクリプトーム)を使用した。
ところがである。この論文、そして、そのデータを保存しているGEO(Gene Expression Omnibus)(https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE233405)を読んでみても、どのシークエンスがどんなファイルなのか、全く書かれていない!!論文を読んていると「免疫チェックポイント阻害剤が投与された肝臓がん患者のPBMC由来のシングルセルトランスクリプトームであり、6例中3例がレスポンダーで、他の3例がノンレスポンダーである。」ことはわかるが、どのファイルがどれなのかが論文中のサプリメントでもGEOを読んでも探せなかった。それに加えて、これはかなり衝撃だったのだが、一体、どの症例に対してどの免疫チェックポイント阻害剤が使用されているのか、はっきり対応させることが出来なかった事である。信じられない。解析の準備体操にもならん感じがする。
これはシンガポールのA*STARの論文である。酷いものである。酷いものである。これ、ヒトの治療の一部でもあるし、最低でも600万円以上は費やしているはず。こんなの大金と解析時間をドブに捨てるような行為である。シンガポールのA*STARもゴミだし、そもそも、こんなゴミをアクセプトするFrontiers in Immunologyも同様にゴミである。前からこのシンガポールのA*STARって胡散臭いと思ってたんだよな。ちなみに、ここは、もう話も聞きたくないゴミのような会社のノボジーン(話のほぼ通じないド素人のポンコツJapをエリアマネージャーにつけていた。ナメてるだろここ。今は違うんかな。)のケツ持ちのような研究施設と勝手に理解している。どっちも簡単には信頼してはならない。こういう論文を出すから、Frontiersもゴミ扱いされるんだよ。知らなかったとは言え、こういうパブリッシャーから論文を出すと、本当に傷モノになるから注意である。自分もあるから、結構後悔している。
ちょっと話がズレまくって、初っ端から毒を吐きまくってしまったが、ここからが本題である。まずは、シングルセルRNAシークエンスのリードからダウンロードしなくてはならない。シングルセルRNAリークエンスのリードはSRA(Sequence Read Archive)に保存されている。それをsra-toolsのprefechを使って取得する。sra-toolsの設定方法については以前の記事に書いてある。今(2026年5月)時点でも問題なく使用出来た。
prefetch -X 25G SRR24735943 SRR24735944 SRR24735945 SRR24735947 SRR24735948 SRR24735949

# As for SRR24735945 and SRR24735947,
# SRR24735945_1.fastq.gz is index
# SRR24735945_2.fastq.gz is Read 1
# SRR24735945_3.fastq.gz is Read 2
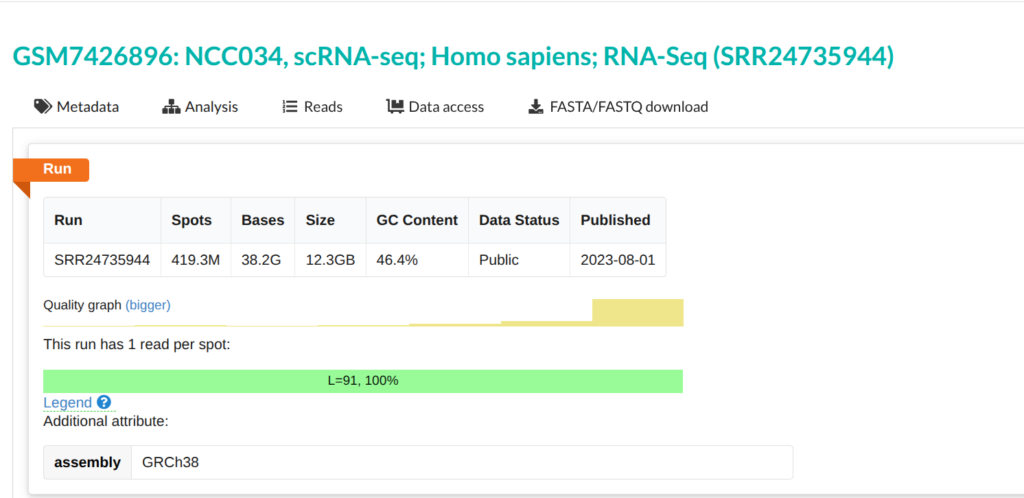
# SRR24735947 is same order.ここでの注意点であるが、SRR24735945とSRR24735947、それ以外で、少し異なるフォーマットでSRAにアップロードされているようだ。このあたりもこの研究のゴミっぷりがわかる。百歩譲ってシングルリードでやっていることは許してやろうと思う。臨床研究だし、検体が集まるのに時間がかかったから、そのときはまだシングルリードしかなかったということだろうから。でも、なんでこんな合理的じゃない事になってる?上記の通り、3つのFastqファイルがアップロードされているが、SRR24735945_1.fastqが10x Chromiumのインデックス、SRR24735945_2.fastqがCell Barcode、SRR24735945_3.fastqがcDNAである。残りのリードは、Fastqが一つだけで、これらが繋がった形でアップロードされている。
prefetchでダウンロードすると、例えばSRR24735945.sraというファイルが出来上がる。次に、それらをfastq-dumpを使ってfastqに変換する。
for SRR in SRR24735943 SRR24735944 SRR24735945 SRR24735947 SRR24735948 SRR24735949
do
fastq-dump -v --split-files --gzip -O /mnt/seqdata/public_data/SRA20260511/fastq /mnt/seqdata/public_data/SRA20260511/sra/${SRR}.sra
done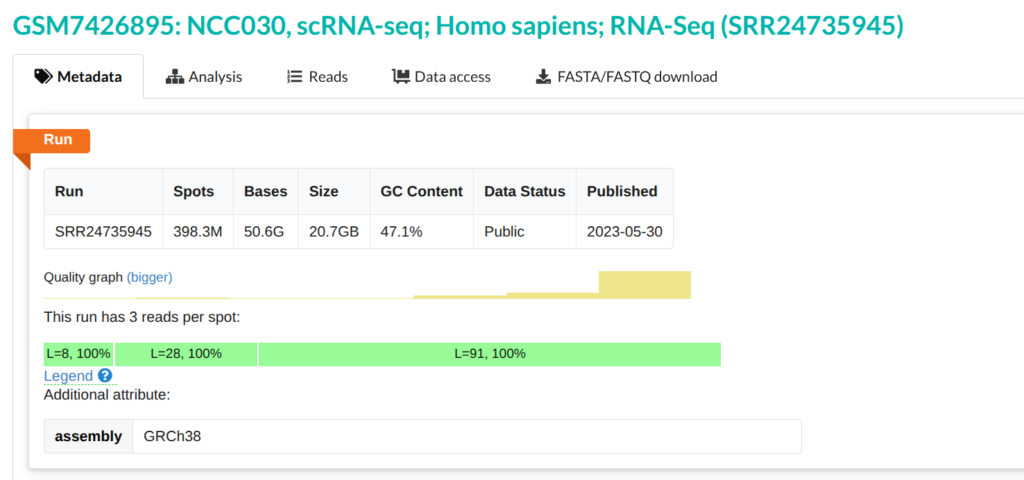
CellRangerによるカウントマトリックスの作成
ここでは、SRR24735945とSRR24735947、残りの4つのリードを別々にcellranger countにかけていく。まずは、3つのFastqからなるSRRSRR24735945とSRR24735947から処理する。fastq-dumpで出力されたfastqファイルを、適切なディレクトリに移動させる。移動させるときに、ついでにファイル名もcellrangerが受け付けることが出来るように変換しておく。
cp -fR /mnt/seqdata/public_data/SRA20260511/fastq/SRR24735945_1.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/
cp -fR /mnt/seqdata/public_data/SRA20260511/fastq/SRR24735945_2.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/
cp -fR /mnt/seqdata/public_data/SRA20260511/fastq/SRR24735945_3.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/

cp -fR /mnt/seqdata/public_data/SRA20260511/fastq/SRR24735947_1.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/
cp -fR /mnt/seqdata/public_data/SRA20260511/fastq/SRR24735947_2.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/
cp -fR /mnt/seqdata/public_data/SRA20260511/fastq/SRR24735947_3.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/

mv /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735945_1.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735945_S1_L001_I1_001.fastq.gz
mv /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735945_2.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735945_S1_L001_R1_001.fastq.gz
mv /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735945_3.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735945_S1_L001_R2_001.fastq.gz

mv /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735947_1.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735947_S1_L001_I1_001.fastq.gz
mv /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735947_2.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735947_S1_L001_R1_001.fastq.gz
mv /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735947_3.fastq.gz /mnt/seqdata/public_data/SRA20260511/PRJNA976204/SRR24735947_S1_L001_R2_001.fastq.gzつづいて、cellranger countを実行する。後にRNA velocity解析も行いたいので、–create-bam=trueを入れて、BAMファイルも出力しておく。–lanes=1になっているが、ここはファイル名のL001に合わせての事である。これがL002とかなら、–lanes=2になるはずである。
for SAMPLE in \
SRR24735945 SRR24735947;
do
time cellranger count \
--id=${SAMPLE} \
--create-bam=true \
--fastqs=/mnt/seqdata/public_data/SRA20260511/PRJNA976204/${SAMPLE} \
--transcriptome=/home/kats/cellranger_refseq/refdata-gex-GRCh38-2024-A \
--sample=${SAMPLE} \
--lanes=1 \
--expect-cells=10000 \
--localcores=32 \
--output-dir=/home/kats/result_cellranger_count_PRJNA976204/${SAMPLE}
done続いて残りのファイルも処理する。これは単にcellranger countに放り込めば良い。
for SAMPLE in \
SRR24735943 \
SRR24735944 \
SRR24735948 \
SRR24735949;
do
time cellranger count \
--id=${SAMPLE} \
--create-bam=true \
--fastqs=/mnt/seqdata/public_data/SRA20260511/PRJNA976204/${SAMPLE} \
--transcriptome=/home/kats/cellranger_refseq/refdata-gex-GRCh38-2024-A \
--sample=${SAMPLE} \
--expect-cells=10000 \
--localcores=32 \
--output-dir=/home/kats/result_cellranger_count_PRJNA976204/${SAMPLE}
done色々とやっていて気づいたのだが、bamファイルをダウンロードし、それらをbamtofastqを使ってfastqに変換し、それをcellranger countで処理する必要はないようだ。prefetchとfastq-dumpで作ったfastqをそのままcellranger countに入れることが出来た。これが終わると、以下のファイルやディレクトリが出力される。Scanpyを使う場合は、filtered_feature_bc_matrix.h5はscanpyでもSeuratでも読み込める。Seuratを使う場合はoutsに入っているファイルも読み込む事が出来る。
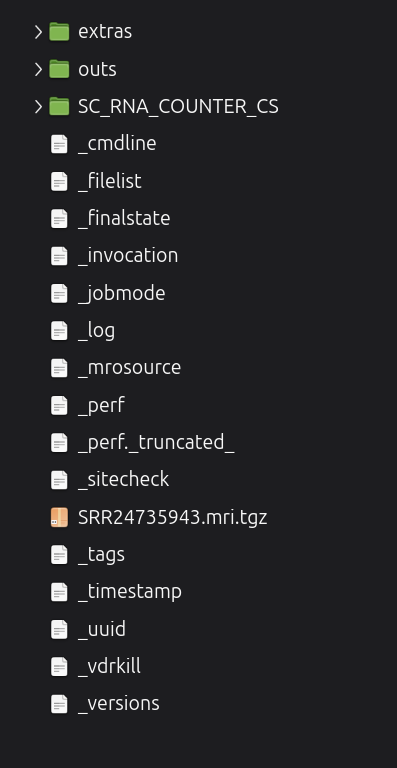
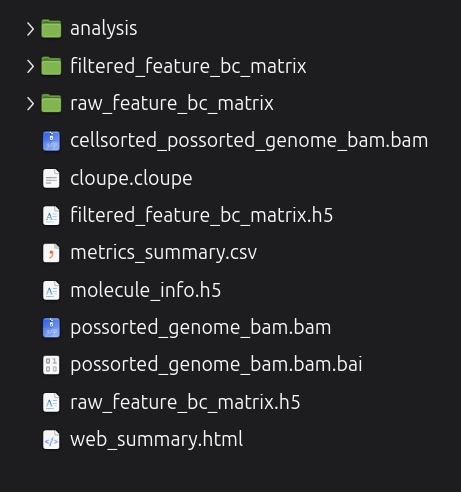
出力されたファイルを、解析に使用するディレクトリにコピーする。
cp -RFv /home/kats/result_cellranger_count_PRJNA976204 "/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204"

# From the strage, the files that will be used for further analysis were copied into directory for the analysis.
cp -Rv "/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204/SRR24735943/outs/filtered_feature_bc_matrix.h5" "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735943/"
cp -Rv "/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204/SRR24735944/outs/filtered_feature_bc_matrix.h5" "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735944/"
cp -Rv "/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204/SRR24735945/outs/filtered_feature_bc_matrix.h5" "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735945/"
cp -Rv "/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204/SRR24735947/outs/filtered_feature_bc_matrix.h5" "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735947/"
cp -Rv "/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204/SRR24735948/outs/filtered_feature_bc_matrix.h5" "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735948/"
cp -Rv "/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204/SRR24735949/outs/filtered_feature_bc_matrix.h5" "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735949/"Scanpyによるプロセッシング、次元削減、クラスタリング、UMAPによる可視化
次に、Scanpyを使っていく。
使用するパッケージ
まず、シングルセルRNAシークエンス解析の基本となりパッケージを読み込んでいく。
import numpy as np
import pandas as pd
import matplotlib as mpl
import seaborn as sns
import scanpy as sc # need 1.9.0. latest version 1.9.3 produce error.
import doubletdetection
import sklearn
import statsmodels.api as sm
import statsmodels.formula.api as smf
from statsmodels.sandbox.regression.predstd import wls_prediction_std
from outliers import smirnov_grubbs as grubbs # pip install outlier-utils
import bbknn # https://github.com/Teichlab/bbknn
import celltypist
import anndata
from scipy.sparse import csr_matrix
# import diopy
import fa2 # install forceatlas2 at first, and DO NOT RUN pip install fa2.
import hdf5plugin
import scanorama
import matplotlib_venn
import singlecellexperiment
import os
import glob
import gc
import igraph
import scipy
import diopy
import harmonypy

sc.settings.verbosity = 3
sc.logging.print_header()
sc.settings.set_figure_params(dpi=80, facecolor="white")
np.random.seed(59867776)
以下の表が、シングルセルRNAシークエンス、特に、QC、次元削減、バッチ効果補正、クラスタリング、UMAPによる表示、細胞の同定までで使用する主なパッケージである。この他に、scikit-learn, pandas, matplotlinなど、当然のように使用していく。色々と共存している環境なので、最初の環境構築がちょっと難しいかもしれない。
| パッケージ | バージョン | 目的 |
|---|---|---|
| anndata | 0.10.9 | データの読み込み、書き出し |
| scanpy | 1.10.0 | QC、次元削減、クラスタリング、UMAP |
| doubletdetection | 4.2 | ダブレット細胞の推定 |
| harmonypy | 2.0.0 | バッチ効果補正 |
| celltypist | 1.7.1 | 細胞の同定 |
データを読み込む
続いて、cellranger countで出力したデータを、head_10x_h5()で読み込む。読み込んだら、anndataのメソッドvar_names_make_unique()で、遺伝子名の重複を除去する。ちょっと注意が必要だが、これは、重複している遺伝子のどちらを削除するような処理ではない。このvar_names_make_unique()により、もし重複のある遺伝子があれば、その後ろに番号を付けるようだ。ちょっと無理やり感があるが、これはscanpyのインストラクションにも書いてあることなので、良しとする。次に、scanpyのpp.filter_genes()により、カウント値が低すぎる遺伝子を除く。ここでは細胞で1つしか無いような遺伝子は除くことにする。どのくらいのカウント値をしきい値にするかは、はっきりとした何らかのロジックが必要である。ただし、逆に言えば、何らかのロジック、例えば、統計値やある基準値などがあれば、どんな値でも良いと思う。ここでは特にルールもロジックもないので、1にする。
# code 1
# SRR24735943; NCC037; B1
# SRR24735944; NCC034; B2
# SRR24735945; NCC030; B3
# SRR24735947; NCC027; B4
# SRR24735948; NCC025; B5
# SRR24735949; NCC022; B6

B1 = sc.read_10x_h5("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735943/filtered_feature_bc_matrix.h5", gex_only=False)
B2 = sc.read_10x_h5("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735944/filtered_feature_bc_matrix.h5", gex_only=False)
B3 = sc.read_10x_h5("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735945/filtered_feature_bc_matrix.h5", gex_only=False)
B4 = sc.read_10x_h5("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735947/filtered_feature_bc_matrix.h5", gex_only=False)
B5 = sc.read_10x_h5("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735948/filtered_feature_bc_matrix.h5", gex_only=False)
B6 = sc.read_10x_h5("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/count/SRR24735949/filtered_feature_bc_matrix.h5", gex_only=False)

B1.uns["name"] = "B1"
B2.uns["name"] = "B2"
B3.uns["name"] = "B3"
B4.uns["name"] = "B4"
B5.uns["name"] = "B5"
B6.uns["name"] = "B6"

B1.var_names_make_unique()
B2.var_names_make_unique()
B3.var_names_make_unique()
B4.var_names_make_unique()
B5.var_names_make_unique()
B6.var_names_make_unique()

sc.pp.filter_genes(B1, min_cells=1)
sc.pp.filter_genes(B2, min_cells=1)
sc.pp.filter_genes(B3, min_cells=1)
sc.pp.filter_genes(B4, min_cells=1)
sc.pp.filter_genes(B5, min_cells=1)
sc.pp.filter_genes(B6, min_cells=1)

#
B1.shape, B2.shape, B3.shape, B4.shape, B5.shape, B6.shape
anndataオブジェクトB1からB6は、cellranger countで作ったカウント値、細胞名(obs)、遺伝子名(vars)が保持されている。そのうちのカウント値をanndataのtoarray()メソッド取り出し、それをマトリックスB1_mtxに入れる。これをB2からB6までに行う。
# code 2

B1_mtx = B1.X.toarray()
B2_mtx = B2.X.toarray()
B3_mtx = B3.X.toarray()
B4_mtx = B4.X.toarray()
B5_mtx = B5.X.toarray()
B6_mtx = B6.X.toarray()作成したマトリックスB1_mtxを使って、QCに用いる値を作成する。code 2で作成したマトリックスB1_mtxを使って、各値を計算する。axis = 1が行、axis = 0が列方向に計算する。Rと逆である。anndataは、カウント値のXを中心に、シ各細胞に関する情報をデータフレームobsに、各遺伝子に関する情報をデータフレームvarsに入れていく。obsとvarsは、計算を適用する方向(axis = 0なのか1なのか)に依って、戻り値の意味が変わってくるので、いちいち混乱してしまう。その他の変数も、基本的にデータフレームとして取り扱う。作成する列に関しては以下の表にまとめた。
| 列名 | レベル | 意味 |
|---|---|---|
| number_of_gene_pp_filter_cells | obs | ある細胞で発現している遺伝子の数 |
| number_of_gene_counts_pp_filter_cells | obs | ある細胞で発現している遺伝子のカウント値の合計 |
| number_of_cell_pp_filter_genes | var | ある遺伝子を発現する細胞数 |
| number_of_cell_counts_pp_filter_genes | var | ある遺伝子を発現する細胞数の合計 |
# code 3

# Basic property of dataset

# B1

B1.obs['number_of_gene_pp_filter_cells'] = np.count_nonzero(B1_mtx, axis=1) #for sc.pp.filter_cells(min_gene=)
B1.obs['number_of_gene_counts_pp_filter_cells'] = B1_mtx.sum(axis=1)#for sc.pp.filter_cells(min_counts=)
B1.var['number_of_cell_pp_filter_genes'] = np.count_nonzero(B1_mtx, axis=0) #for sc.pp.filter_genes(min_gene=)
B1.var['number_of_cell_counts_pp_filter_genes'] = B1_mtx.sum(axis=0)#for sc.pp.filter_genes(min_counts=)

# B2
B2.obs['number_of_gene_pp_filter_cells'] = np.count_nonzero(B2_mtx, axis=1) #for sc.pp.filter_cells(min_gene=)
B2.obs['number_of_gene_counts_pp_filter_cells'] = B2_mtx.sum(axis=1)#for sc.pp.filter_cells(min_counts=)
B2.var['number_of_cell_pp_filter_genes'] = np.count_nonzero(B2_mtx, axis=0) #for sc.pp.filter_genes(min_gene=)
B2.var['number_of_cell_counts_pp_filter_genes'] = B2_mtx.sum(axis=0)#for sc.pp.filter_genes(min_counts=)

# B3
B3.obs['number_of_gene_pp_filter_cells'] = np.count_nonzero(B3_mtx, axis=1) #for sc.pp.filter_cells(min_gene=)
B3.obs['number_of_gene_counts_pp_filter_cells'] = B3_mtx.sum(axis=1)#for sc.pp.filter_cells(min_counts=)
B3.var['number_of_cell_pp_filter_genes'] = np.count_nonzero(B3_mtx, axis=0) #for sc.pp.filter_genes(min_gene=)
B3.var['number_of_cell_counts_pp_filter_genes'] = B3_mtx.sum(axis=0)#for sc.pp.filter_genes(min_counts=)

# B4
B4.obs['number_of_gene_pp_filter_cells'] = np.count_nonzero(B4_mtx, axis=1) #for sc.pp.filter_cells(min_gene=)
B4.obs['number_of_gene_counts_pp_filter_cells'] = B4_mtx.sum(axis=1)#for sc.pp.filter_cells(min_counts=)
B4.var['number_of_cell_pp_filter_genes'] = np.count_nonzero(B4_mtx, axis=0) #for sc.pp.filter_genes(min_gene=)
B4.var['number_of_cell_counts_pp_filter_genes'] = B4_mtx.sum(axis=0)#for sc.pp.filter_genes(min_counts=)

# B5
B5.obs['number_of_gene_pp_filter_cells'] = np.count_nonzero(B5_mtx, axis=1) #for sc.pp.filter_cells(min_gene=)
B5.obs['number_of_gene_counts_pp_filter_cells'] = B5_mtx.sum(axis=1)#for sc.pp.filter_cells(min_counts=)
B5.var['number_of_cell_pp_filter_genes'] = np.count_nonzero(B5_mtx, axis=0) #for sc.pp.filter_genes(min_gene=)
B5.var['number_of_cell_counts_pp_filter_genes'] = B5_mtx.sum(axis=0)#for sc.pp.filter_genes(min_counts=)

# B6
B6.obs['number_of_gene_pp_filter_cells'] = np.count_nonzero(B6_mtx, axis=1) #for sc.pp.filter_cells(min_gene=)
B6.obs['number_of_gene_counts_pp_filter_cells'] = B6_mtx.sum(axis=1)#for sc.pp.filter_cells(min_counts=)
B6.var['number_of_cell_pp_filter_genes'] = np.count_nonzero(B6_mtx, axis=0) #for sc.pp.filter_genes(min_gene=)
B6.var['number_of_cell_counts_pp_filter_genes'] = B6_mtx.sum(axis=0)#for sc.pp.filter_genes(min_counts=)次に、各anndataオブジェクトで、ミトコンドリア遺伝子(MTから始まる遺伝子)、リボソーム遺伝子(RPSもしくはRPLから始まる遺伝子)、TCR、BCRを拾ってきて、それがマッチしたらTrueそれぞれデータフレームvarの列MT、RIBO、TCR、BCRに入れていく。
一般的に、ミトコンドリア遺伝子の発現量は細胞死に由来する低クオリティーのリードと相関するらしい。これらはPCA(主成分分析;Principal Component Analysis;PCA)のときに、これらのカウント値が計算に影響しないように「外す(”Regress out”する)」ために使用する。正直、あまり無下にこれらを除外するのはどうかと思うが、根拠があるなら仕方がない。逆に、計算に含める根拠があるなら、入れても一向に構わない。他には、個人的にはリボソーム遺伝子がかなり邪魔である。例えば、T細胞とか、活性が高い細胞はこれらもやはり高いように思う。それにも関わらず一般的な遺伝子マーカーを使っていても同じ細胞と言わざるを得ないので、これらが別のクラスターに別れてしまうのは邪魔くさい。TCRとかBCRも、細胞種の同定には邪魔になる可能性があるので、ミトコンドリア遺伝子と同様、何かの理由をもとにして除外、もしくは解析に含める必要がある。
# code 4

for adata in [B1, B2, B3, B4, B5, B6]:
    adata.var["MT"] = adata.var_names.str.startswith("MT-")|\
                              adata.var_names.str.startswith("MTTF")|\
                              adata.var_names.str.startswith("MTRNR1")|\
                              adata.var_names.str.startswith("MTTV")|\
                              adata.var_names.str.startswith("MTRNR2")|\
                              adata.var_names.str.startswith("MTTL1")|\
                              adata.var_names.str.startswith("MTND1")|\
                              adata.var_names.str.startswith("MTTI")|\
                              adata.var_names.str.startswith("MTTQ")|\
                              adata.var_names.str.startswith("MTTM")|\
                              adata.var_names.str.startswith("MTND2")|\
                              adata.var_names.str.startswith("MTTW")|\
                              adata.var_names.str.startswith("MTTA")|\
                              adata.var_names.str.startswith("MTTN")|\
                              adata.var_names.str.startswith("MTTC")|\
                              adata.var_names.str.startswith("MTTY")|\
                              adata.var_names.str.startswith("MTCO1")|\
                              adata.var_names.str.startswith("MTTS1")|\
                              adata.var_names.str.startswith("MTTD")|\
                              adata.var_names.str.startswith("MTCO2")|\
                              adata.var_names.str.startswith("MTTK")|\
                              adata.var_names.str.startswith("MTATP8")|\
                              adata.var_names.str.startswith("MTATP6")|\
                              adata.var_names.str.startswith("MTCO3")|\
                              adata.var_names.str.startswith("MTTG")|\
                              adata.var_names.str.startswith("MTND3")|\
                              adata.var_names.str.startswith("MTTR")|\
                              adata.var_names.str.startswith("MTND4L")|\
                              adata.var_names.str.startswith("MTND4")|\
                              adata.var_names.str.startswith("MTTH")|\
                              adata.var_names.str.startswith("MTTS2")|\
                              adata.var_names.str.startswith("MTTL2")|\
                              adata.var_names.str.startswith("MTND5")|\
                              adata.var_names.str.startswith("MTND6")|\
                              adata.var_names.str.startswith("MTTE")|\
                              adata.var_names.str.startswith("MTCYB")|\
                              adata.var_names.str.startswith("MTTT")|\
                              adata.var_names.str.startswith("MTTP")
    adata.var["RIBO"] = adata.var_names.str.startswith("RPS")|adata.var_names.str.startswith("RPL")
    adata.var["TCR"] = adata.var_names.str.startswith("TRA")|\
                               adata.var_names.str.startswith("TRB")|\
                               adata.var_names.str.startswith("TRG")|\
                               adata.var_names.str.startswith("TRD")
    adata.var["BCR"] = adata.var_names.str.startswith("IGH")|\
                               adata.var_names.str.startswith("IGL")|\
                               adata.var_names.str.startswith("IGK")
ここで、code 4で作成したミトコンドリア遺伝子、リボソーム遺伝子、TCR、BCRがどれだけ存在しているのかcalculate_qc_metrics()で確認する。これによりデータフレームobsに列n_genes_by_counts、列total_counts、列total_counts_MT、列pct_counts_RIBOなどが出来上がる。これらは後ほど、QCにカウントの分布を確認するために使用する。
# code 5
for adata in [B1, B2, B3, B4, B5, B6]:
    sc.pp.calculate_qc_metrics(adata, qc_vars=["MT"], percent_top=None, log1p=False, inplace=True)
    sc.pp.calculate_qc_metrics(adata, qc_vars=["RIBO"], percent_top=None, log1p=False, inplace=True)
    sc.pp.calculate_qc_metrics(adata, qc_vars=["TCR"], percent_top=None, log1p=False, inplace=True)
    sc.pp.calculate_qc_metrics(adata, qc_vars=["BCR"], percent_top=None, log1p=False, inplace=True)
code 5で作成した、ミトンドリア遺伝子のカウント値をヒストグラムで見る。このためにseabornのhistplot()を使用する。シングルセルRNAシークエンスって、このQCが一番重要なんじゃあ無いかと思う。普通のシングルセルRNAシークエンスって、考えるところはQC、細胞の同定、疑似系譜解析がすべてだと思っている。それが上手いこと出来ると、あとはその分類にしたがってクラスタリングしたりDEG解析したりするだけである。
# code 6
for adata in [B1, B2, B3, B4, B5, B6]:
    print("****", adata.uns["name"], "****")
    sns.histplot(adata.obs.pct_counts_MT, binrange = (0, 20), cumulative = False)
    mpl.pyplot.title(adata.uns["name"])
mpl.pyplot.show()今度はドットプロットとヒストグラムを描画してみる。ただし、この時点では「ふーん、こんなもんか、どうしよ。」くらいしか考える必要はない。これはダブレット除去後のQCのための準備である。
# code 7
for adata in [B1, B2, B3, B4, B5, B6]:
    print("****", adata.uns["name"], "****")
    sns.jointplot(x = adata.obs.pct_counts_MT, y = adata.obs.pct_counts_RIBO, kind="scatter")
    mpl.pyplot.title(adata.uns["name"])
    mpl.pyplot.show()
    sns.jointplot(x = adata.obs.pct_counts_MT, y = adata.obs.pct_counts_RIBO, kind="kde")
    mpl.pyplot.title(adata.uns["name"])
mpl.pyplot.show() DoubetDetectionでダブレットを除去する。
上記でQCに使いそうな値を作成してきたが、その前にダブレット除去を行う。ダブレット除去は、正規化前の生のカウント値を用いる必要がある。そうしなければ、それがダブレットなのか単にカウント値が高い細胞なのか、推定できない。ダブレット除去にはdoubletdetectionを用いる。これを用いた理由は、確かベンチマークが良く、scanpyを邪魔しないからだったと記憶している。
まずはオブジェクトB1から。
# code 8
# B1
print("****", B1.uns["name"], "****")

clf_B1 = doubletdetection.BoostClassifier(
    n_iters=10,
    clustering_algorithm="louvain",
    standard_scaling=True,
    pseudocount=0.1,
    n_jobs=-1)

doublets_B1 = clf_B1.fit(B1.X).predict(p_thresh=1e-16, voter_thresh=0.5)

doublet_score_B1 = clf_B1.doublet_score()

B1.obs["doublet"] = doublets_B1

B1.obs["doublet_score"]  = doublet_score_B1

# gc.collect()次に、オブジェクトB2。
# code 9
# B2

print("****", B2.uns["name"], "****")

clf_B2 = doubletdetection.BoostClassifier(
    n_iters=10,
    clustering_algorithm="louvain",
    standard_scaling=True,
    pseudocount=0.1,
    n_jobs= -1)

doublets_B2 = clf_B2.fit(B2.X).predict(p_thresh=1e-16, voter_thresh=0.5)

doublet_score_B2 = clf_B2.doublet_score()

B2.obs["doublet"] = doublets_B2

B2.obs["doublet_score"] = doublet_score_B2オブジェクトB3。
# code 10
# B3
print("****", B3.uns["name"], "****")
clf_B3 = doubletdetection.BoostClassifier(n_iters=10, clustering_algorithm="leiden", standard_scaling=True, pseudocount=0.1,n_jobs=-1)
doublets_B3 = clf_B3.fit(B3.X).predict(p_thresh=1e-16, voter_thresh=0.5)
doublet_score_B3 = clf_B3.doublet_score()
B3.obs["doublet"] = doublets_B3
B3.obs["doublet_score"] = doublet_score_B3次に、オブジェクトB4。
# code 11
# B4
print("****", B4.uns["name"], "****")
clf_B4 = doubletdetection.BoostClassifier(n_iters=10, clustering_algorithm="louvain", standard_scaling=True, pseudocount=0.1,n_jobs=-1)
doublets_B4 = clf_B4.fit(B4.X).predict(p_thresh=1e-16, voter_thresh=0.5)
doublet_score_B4 = clf_B4.doublet_score()
B4.obs["doublet"] = doublets_B4
B4.obs["doublet_score"] = doublet_score_B4次に、オブジェクトB5。
# code 12
# B5
print("****", B5.uns["name"], "****")
clf_B5 = doubletdetection.BoostClassifier(n_iters=10, clustering_algorithm="louvain", standard_scaling=True, pseudocount=0.1,n_jobs=-1)
doublets_B5 = clf_B5.fit(B5.X).predict(p_thresh=1e-16, voter_thresh=0.5)
doublet_score_B5 = clf_B5.doublet_score()
B5.obs["doublet"] = doublets_B5
B5.obs["doublet_score"] = doublet_score_B5次に、オブジェクトB6。
# code 13
# B6
print("****", B6.uns["name"], "****")
clf_B6 = doubletdetection.BoostClassifier(n_iters=10, clustering_algorithm="louvain", standard_scaling=True, pseudocount=0.1,n_jobs=-1)
doublets_B6 = clf_B6.fit(B6.X).predict(p_thresh=1e-16, voter_thresh=0.5)
doublet_score_B6 = clf_B6.doublet_score()
B6.obs["doublet"] = doublets_B6
B6.obs["doublet_score"] = doublet_score_B6本当は以下のコードチャンクのように一気に計算したかったんだけど、なんか正常に動かなかった。計算はできるんだけど、結果を各オブジェクトに格納できなかった。以前は出来たんだけど…なので、言うても6個くらいなので、個別に計算した次第である。
# adata_dict = {
#     "B1": B1,
#     "B2": B2,
#     "B3": B3,
#     "B4": B4,
#     "B5": B5,
#     "B6": B6
# }

# for name, adata in adata_dict.items():

#     print(f"Processing {name}")

#     clf = doubletdetection.BoostClassifier(
#         n_iters=10,
#         clustering_algorithm="louvain",
#         standard_scaling=True,
#         pseudocount=0.1,
#         n_jobs=-1
#     )

#     adata.obs["doublet"] = clf.fit(adata.X).predict(
#         p_thresh=1e-16,
#         voter_thresh=0.5
#     )

# adata.obs["doublet_score"] = clf.doublet_score()ダブレットスコアの計算が終わったら、そのスコアを図示してみる。正直、マニュアルにこう書いてあったから流しているだけで、いまいちどんな値なのか理解していないという体たらくである。だから、個人的に見るグラフは歳簿の行のhistplot()の出力で、それをみると大体doublet_scoreが5より高くなってくると、ダブレットとみなしても良さそう。以下、オブジェクトB1からB6まで順次計算する。
# code 14
# B1
f_B1 = doubletdetection.plot.convergence(clf_B1, show=True, p_thresh=1e-16, voter_thresh=0.5)
f3_B1 = doubletdetection.plot.threshold(clf_B1, show=True, p_step=6)
sc.pl.violin(B1, "doublet_score")
sns.histplot(B1.obs.doublet_score, binrange = (0, 20), cumulative = False)
# code 15
# B2
f_B2 = doubletdetection.plot.convergence(clf_B2, show=True, p_thresh=1e-16, voter_thresh=0.5)
f3_B2 = doubletdetection.plot.threshold(clf_B2, show=True, p_step=6)
sc.pl.violin(B2, "doublet_score")
sns.histplot(B2.obs.doublet_score, binrange = (0, 20), cumulative = False)# code 16
# B3
f_B3 = doubletdetection.plot.convergence(clf_B3, show=True, p_thresh=1e-16, voter_thresh=0.5)
f3_B3 = doubletdetection.plot.threshold(clf_B3, show=True, p_step=6)
sc.pl.violin(B3, "doublet_score")
sns.histplot(B3.obs.doublet_score, binrange = (0, 20), cumulative = False)# code 17
# B4
f_B4 = doubletdetection.plot.convergence(clf_B4, show=True, p_thresh=1e-16, voter_thresh=0.5)
f3_B4 = doubletdetection.plot.threshold(clf_B4, show=True, p_step=6)
sc.pl.violin(B4, "doublet_score")
sns.histplot(B4.obs.doublet_score, binrange = (0, 20), cumulative = False)# code 18
# B5
f_B5 = doubletdetection.plot.convergence(clf_B5, show=True, p_thresh=1e-16, voter_thresh=0.5)
f3_B5 = doubletdetection.plot.threshold(clf_B5, show=True, p_step=6)
sc.pl.violin(B5, "doublet_score")
sns.histplot(B5.obs.doublet_score, binrange = (0, 20), cumulative = False)# code 19
# B6
f_B6 = doubletdetection.plot.convergence(clf_B6, show=True, p_thresh=1e-16, voter_thresh=0.5)
f3_B6 = doubletdetection.plot.threshold(clf_B6, show=True, p_step=6)
sc.pl.violin(B6, "doublet_score")
sns.histplot(B6.obs.doublet_score, binrange = (0, 20), cumulative = False)doublet_scoreが5以上だとダブレットとみなすことにする。ということで、doublet_scoreが5より低いものを選んで来て、オブジェクトB1とする。これを他のオブジェクトB2からB6まで適用する。これでダブレットは除去されたとしよう。ちなみに、本当にダブレットだったかどうかは、実際はわからない。これは飽くまで推定であり、明らかにカウント値が2倍のものとか(何に対して2倍かは決める必要があるが)を除く、という方法でも、理にかなっていれば別に良い。これも上記で行った、なぜミトコンドリア遺伝子をクラスタリングから除くか問題と一緒である。無下にdoublet_scoreが高い値を全部除くのも、もしかしたら問題があるのかもしれない。これは推定でしかないわけだし。
# code 20
# for adata in [B1, B2, B3, B4, B5, B6]:
#     adata = adata[adata.obs.doublet_score < 5]
#     adata

# B1
B1 = B1[B1.obs.doublet_score < 5]
# B2
B2 = B2[B2.obs.doublet_score < 5]
# B3
B3 = B3[B3.obs.doublet_score < 5]
# B4
B4 = B4[B4.obs.doublet_score < 5]
# B5
B5 = B5[B5.obs.doublet_score < 5]
# B6
B6 = B6[B6.obs.doublet_score < 5]

B1.shape, B2.shape, B3.shape, B4.shape, B5.shape, B6.shape
QC
ここからQCを行っていく。ダブレット除去にも通じることと思うが、個人的にはシンプルに相関係数を計算して、その回帰直線から外れたものは除いてしまう、という方法がとても良いように思う。この方法だと、カウント値(すなわち遺伝子発現量)の直線性が担保されている細胞を選ぶことが出来るためである。すでにダブレットは除去されているわけだし。これは単純で、calculate_qc_metrics()で求めたデータフレームobsの列n_genes_by_countsと列total_countsの相関を解析し、その信頼区間から外れているものを各オブジェクトから除去すれば良い。
# code 21
for adata in [B1, B2, B3, B4, B5, B6]:
    lm_total_counts = sm.add_constant(adata.obs.total_counts)
    model = sm.OLS(adata.obs.n_genes_by_counts, lm_total_counts)
    result = model.fit()
    predicted = result.predict()
    result.summary()
    print(result.params)
    predicted_2 = result.get_prediction()
    ci = predicted_2.conf_int(alpha=0.05)
    ci
    type(ci)
    df_ci = pd.DataFrame(ci)
    type(df_ci)
    df_ci
    df_ci = pd.DataFrame.rename(self = df_ci, columns={0: "lower", 1: "upper"})
    df_ci

    adata.obs["lower_ci"] = df_ci.lower.values
    adata.obs["upper_ci"] = df_ci.upper.values
    adata.obs

    prstd, iv_l, iv_u = wls_prediction_std(result)
    mpl.pyplot.plot(adata.obs.total_counts, adata.obs.n_genes_by_counts, "o")
    mpl.pyplot.plot(adata.obs.total_counts, result.fittedvalues, 'r--')
    mpl.pyplot.plot(adata.obs.total_counts, iv_u, 'r--')
    mpl.pyplot.plot(adata.obs.total_counts, iv_l, 'r--')
    mpl.pyplot.legend(loc="best")
    mpl.pyplot.show()
ここで、QCの指標となる各列の集計値をバイオリンプロットで見てみる。ここで、scanpyのpp.qc_metric個人的にはこの相関による除外が強力で、いい感じに外れ値的な値が無い分布になっているじゃあないか。
# code 22
# for adata in [B1, B2, B3, B4, B5, B6]:
#     adata.obs["outlier_n_genes_by_counts"] = (adata.obs.n_genes_by_counts < adata.obs.lower_ci.values)&(adata.obs.n_genes_by_counts < adata.obs.upper_ci.values)
#     adata.obs.outlier_n_genes_by_counts
#     adata = adata[~adata.obs["outlier_n_genes_by_counts"], :]
#     #print(adata.obs.n_genes_by_counts)
#     sc.pl.violin(adata, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
#     mpl.pyplot.plot(adata.obs.total_counts, adata.obs.n_genes_by_counts, "o")
#     print(adata.obs.n_genes_by_counts)

# B1
B1.obs["outlier_n_genes_by_counts"] = (B1.obs.n_genes_by_counts < B1.obs.lower_ci.values)&(B1.obs.n_genes_by_counts < B1.obs.upper_ci.values)
B1.obs.outlier_n_genes_by_counts
B1 = B1[~B1.obs["outlier_n_genes_by_counts"], :]
#print(B1.obs.n_genes_by_counts)
sc.pl.violin(B1, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
mpl.pyplot.plot(B1.obs.total_counts, B1.obs.n_genes_by_counts, "o")
print(B1.obs.n_genes_by_counts)

# B2
B2.obs["outlier_n_genes_by_counts"] = (B2.obs.n_genes_by_counts < B2.obs.lower_ci.values)&(B2.obs.n_genes_by_counts < B2.obs.upper_ci.values)
B2.obs.outlier_n_genes_by_counts
B2 = B2[~B2.obs["outlier_n_genes_by_counts"], :]
#print(B2.obs.n_genes_by_counts)
sc.pl.violin(B2, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
mpl.pyplot.plot(B2.obs.total_counts, B2.obs.n_genes_by_counts, "o")
print(B2.obs.n_genes_by_counts)

# B3
B3.obs["outlier_n_genes_by_counts"] = (B3.obs.n_genes_by_counts < B3.obs.lower_ci.values)&(B3.obs.n_genes_by_counts < B3.obs.upper_ci.values)
B3.obs.outlier_n_genes_by_counts
B3 = B3[~B3.obs["outlier_n_genes_by_counts"], :]
#print(B3.obs.n_genes_by_counts)
sc.pl.violin(B3, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
mpl.pyplot.plot(B3.obs.total_counts, B3.obs.n_genes_by_counts, "o")
print(B3.obs.n_genes_by_counts)

# B4
B4.obs["outlier_n_genes_by_counts"] = (B4.obs.n_genes_by_counts < B4.obs.lower_ci.values)&(B4.obs.n_genes_by_counts < B4.obs.upper_ci.values)
B4.obs.outlier_n_genes_by_counts
B4 = B4[~B4.obs["outlier_n_genes_by_counts"], :]
#print(B4.obs.n_genes_by_counts)
sc.pl.violin(B4, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
mpl.pyplot.plot(B4.obs.total_counts, B4.obs.n_genes_by_counts, "o")
print(B4.obs.n_genes_by_counts)

# B5
B5.obs["outlier_n_genes_by_counts"] = (B5.obs.n_genes_by_counts < B5.obs.lower_ci.values)&(B5.obs.n_genes_by_counts < B5.obs.upper_ci.values)
B5.obs.outlier_n_genes_by_counts
B5 = B5[~B5.obs["outlier_n_genes_by_counts"], :]
#print(B5.obs.n_genes_by_counts)
sc.pl.violin(B5, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
mpl.pyplot.plot(B5.obs.total_counts, B5.obs.n_genes_by_counts, "o")
print(B5.obs.n_genes_by_counts)

# B6
B6.obs["outlier_n_genes_by_counts"] = (B6.obs.n_genes_by_counts < B6.obs.lower_ci.values)&(B6.obs.n_genes_by_counts < B6.obs.upper_ci.values)
B6.obs.outlier_n_genes_by_counts
B6 = B6[~B6.obs["outlier_n_genes_by_counts"], :]
#print(B6.obs.n_genes_by_counts)
sc.pl.violin(B6, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
mpl.pyplot.plot(B6.obs.total_counts, B6.obs.n_genes_by_counts, "o")
print(B6.obs.n_genes_by_counts)上記のバイオリンプロットを各オブジェクトに渡って一気に表示するのが以下のコード。
# code 23
for adata in [B1, B2, B3, B4, B5, B6]:
    # adata.obs["within_quantile"] = (adata.obs.n_genes_by_counts >= adata.obs.n_genes_by_counts.quantile(0.10)) & (adata.obs.n_genes_by_counts <= adata.obs.n_genes_by_counts.quantile(0.90))
    # adata.obs["n_genes_by_counts_1000_7000"] = (adata.obs.n_genes_by_counts >= 1000) & (adata.obs.n_genes_by_counts <= 7000)
    # adata.obs["total_counts_less_than_25000"] = adata.obs.total_counts <= 25000
    # adata.obs["outlier_MT"] = adata.obs.pct_counts_MT > 20
    # adata = adata[~adata.obs["outlier_MT"], :]
    # # adata = adata[adata.obs["within_quantile"], :]
    # adata = adata[adata.obs["n_genes_by_counts_1000_7000"], :]
    # adata = adata[adata.obs["total_counts_less_than_25000"], :]
    sc.pl.violin(adata, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
print(adata.uns["name"], ": data shape:", adata.shape)しかしながら、やはりミトコンドリア遺伝子は邪魔くさいので、各オブジェクトのデータフレームobsの列pct_counts_MTが、10より高いものをオブジェクトから除去し、バイオリンプロットで確認する。
# code 24

# # B1
# B1.obs["within_quantile"] = (B1.obs.n_genes_by_counts >= B1.obs.n_genes_by_counts.quantile(0.10)) & (B1.obs.n_genes_by_counts <= B1.obs.n_genes_by_counts.quantile(0.90))
# B1.obs["n_genes_by_counts_1000_7000"] = (B1.obs.n_genes_by_counts >= 1000) & (B1.obs.n_genes_by_counts <= 7000)
# B1.obs["total_counts_less_than_25000"] = B1.obs.total_counts <= 25000
# B1.obs["outlier_MT"] = B1.obs.pct_counts_MT > 20
# B1 = B1[~B1.obs["outlier_MT"], :]
# # B1 = B1[B1.obs["within_quantile"], :]
# B1 = B1[B1.obs["n_genes_by_counts_1000_7000"], :]
# B1 = B1[B1.obs["total_counts_less_than_25000"], :]
# sc.pl.violin(B1, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
# print(B1.uns["name"], ": data shape:", B1.shape)


# B1
B1.obs["outlier_MT"] = B1.obs.pct_counts_MT > 10
B1 = B1[~B1.obs["outlier_MT"], :]
sc.pl.violin(B1, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
print(B1.uns["name"], ": data shape:", B1.shape)

# B2
B2.obs["outlier_MT"] = B2.obs.pct_counts_MT > 10
B2 = B2[~B2.obs["outlier_MT"], :]
sc.pl.violin(B2, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
print(B2.uns["name"], ": data shape:", B2.shape)

# B3
B3.obs["outlier_MT"] = B3.obs.pct_counts_MT > 10
B3 = B3[~B3.obs["outlier_MT"], :]
sc.pl.violin(B3, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
print(B3.uns["name"], ": data shape:", B3.shape)


# B4
B4.obs["outlier_MT"] = B4.obs.pct_counts_MT > 10
B4 = B4[~B4.obs["outlier_MT"], :]
sc.pl.violin(B4, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
print(B4.uns["name"], ": data shape:", B4.shape)


# B5
B5.obs["outlier_MT"] = B5.obs.pct_counts_MT > 10
B5 = B5[~B5.obs["outlier_MT"], :]
sc.pl.violin(B5, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
print(B5.uns["name"], ": data shape:", B5.shape)

# B6
B6.obs["outlier_MT"] = B6.obs.pct_counts_MT > 10
B6 = B6[~B6.obs["outlier_MT"], :]
sc.pl.violin(B6, ["n_genes_by_counts", "total_counts", "pct_counts_MT", "pct_counts_RIBO", "pct_counts_TCR", "pct_counts_BCR"], jitter=0.4, multi_panel=True)
print(B6.uns["name"], ": data shape:", B6.shape)
一応、出来上がったオブジェクトのデータフレームobsの列pct_counts_MTに、外れ値がないかどうかをグラブズ検定で確認する。
# code 25
# B1
outliers_B1_pct_counts_MT = grubbs.min_test_outliers(np.array(B1.obs.pct_counts_MT), alpha=0.05)
outliers_B1_pct_counts_RIBO = grubbs.min_test_outliers(np.array(B1.obs.pct_counts_RIBO), alpha=0.05)
print(outliers_B1_pct_counts_MT)# There is nothing!
print(outliers_B1_pct_counts_MT)# There is nothing!
# B2
outliers_B2_pct_counts_MT = grubbs.min_test_outliers(np.array(B2.obs.pct_counts_MT), alpha=0.05)
outliers_B2_pct_counts_RIBO = grubbs.min_test_outliers(np.array(B2.obs.pct_counts_RIBO), alpha=0.05)
print(outliers_B2_pct_counts_MT)# There is nothing!
print(outliers_B2_pct_counts_MT)# There is nothing!
# B3
outliers_B3_pct_counts_MT = grubbs.min_test_outliers(np.array(B3.obs.pct_counts_MT), alpha=0.05)
outliers_B3_pct_counts_RIBO = grubbs.min_test_outliers(np.array(B3.obs.pct_counts_RIBO), alpha=0.05)
print(outliers_B3_pct_counts_MT)# There is nothing!
print(outliers_B3_pct_counts_MT)# There is nothing!
# B4
outliers_B4_pct_counts_MT = grubbs.min_test_outliers(np.array(B4.obs.pct_counts_MT), alpha=0.05)
outliers_B4_pct_counts_RIBO = grubbs.min_test_outliers(np.array(B4.obs.pct_counts_RIBO), alpha=0.05)
print(outliers_B4_pct_counts_MT)# There is nothing!
print(outliers_B4_pct_counts_MT)# There is nothing!
# B5
outliers_B5_pct_counts_MT = grubbs.min_test_outliers(np.array(B5.obs.pct_counts_MT), alpha=0.05)
outliers_B5_pct_counts_RIBO = grubbs.min_test_outliers(np.array(B5.obs.pct_counts_RIBO), alpha=0.05)
print(outliers_B5_pct_counts_MT)# There is nothing!
print(outliers_B5_pct_counts_MT)# There is nothing!
# B6
outliers_B6_pct_counts_MT = grubbs.min_test_outliers(np.array(B6.obs.pct_counts_MT), alpha=0.05)
outliers_B6_pct_counts_RIBO = grubbs.min_test_outliers(np.array(B6.obs.pct_counts_RIBO), alpha=0.05)
print(outliers_B6_pct_counts_MT)# There is nothing!
print(outliers_B6_pct_counts_MT)# There is nothing!QCは大体これで良しとする。QCが終わったら、各オブジェクトを統合する。そのためには、anndataのconcatenate()メソッドを使用する。ここでは、今後解析に使用していくためのオブジェクトconcatと、それとオリジナルとしてオブジェクトconcat_originalを作成しておく。それが済んだら、var_names_make_unique()メソッドとobs_names_make_unique()メソッドにより、細胞と遺伝子名の重複を解消しておく。var_names_make_unique()とobs_names_make_unique()は、重複があった細胞や遺伝子名に対して、文字列「-1」(ハイフン1)を付けるだけであり、結局、後の解析の邪魔になってしまうので、ここでこの「-1」がついた細胞と遺伝子を除去してしまう。本当ならばこれらを抽出して、どんな細胞、遺伝子なのかを確認し、どちらかを除くのかを自分で決める必要がある。正直、自分で決めてもこのように機械的に除去しても結果には大きく影響しないような気もする。しかし、最初の方に述べたように、この解析は未だ高額なので、無駄の無いように解析した方が良いに決まっているし、後々になって足元を救われる心配がないだろう。
# code 26

# concatenate individual dataset
concat = B1.concatenate(
    B2,
    B3,
    B4,
    B5,
    B6,
    batch_categories=['B1', 'B2', 'B3', 'B4', 'B5', 'B6'],
    index_unique = None)

concat_original = B1.concatenate(
    B2,
    B3,
    B4,
    B5,
    B6,
    batch_categories=['B1', 'B2', 'B3', 'B4', 'B5', 'B6'],
    index_unique = None)

concat.var_names_make_unique()
concat_original.var_names_make_unique()
concat.obs_names_make_unique()
concat_original.obs_names_make_unique()

# Remove lane contamination of cells

concat = concat[concat.obs_names.str.contains('-1-') == False]
concat_original = concat_original[concat_original.obs_names.str.contains('-1-') == False]
正規化(Normalization)
QCが終わったので、データセットを正規化する。正規化の方法は多くあると思うが、ここでは主にscanpyのnormalize_pearson_residuals()を使用する。インストラクションを見ると、SeuratのSCtransformっぽい方法らしい。しかしながら、このあたりは正直、Seuratの方が良いかもしれない。もしかしたらパラメーターを調整すれば良いのかもしれないが、このnormalize_pearson_residuals()を使用すると、値がマイナスの遺伝子も出てくるので、この正規化により得られた値は他のパッケージで使用できない場合がある。SeuratのSCtransformでは値がマイナスにならないので、応用の幅は広いように思う。その他にはnormalize_total()とかnormalize_per_cell()などもあるので、用途に応じて使用すれば良いと思う。
ここでは、正規化した値をlog1p()に変換するのも、けっこう有用である。
# code 27

# This is for DEG analysis after finding marker genes, clustering, and cell typing.

concat.layers["raw"] = concat.X.copy()
type(concat.layers["raw"]) # data type should be scipy.sparse._csr.csr_matrix

# normalization by pearson residual.
concat.layers["normalize_pearson"] = sc.experimental.pp.normalize_pearson_residuals(concat, inplace=False)["X"]

# Following can be transform sparse matrix to numpy array

# concat_pearson_normalized = sc.experimental.pp.normalize_pearson_residuals(concat, inplace=False)
# concat.layers["normalize_pearson"] = csr_matrix(concat_pearson_normalized["X"])

##
# concat.layers["sqrt_norm"] = np.sqrt(sc.pp.normalize_total(concat, inplace=False)["X"]) # Did not use for analysis.
concat.layers["normalize_total"] = sc.pp.normalize_total(concat, layer = "raw", inplace=False)["X"] # a gene counts in a cells/ sum of all genes in a cells
concat.layers["sqrt_normalize_total"] = np.sqrt(sc.pp.normalize_total(concat, inplace=False)["X"]) # a gene counts in a cells/ sum of all genes in a cells
concat.layers["log1p_normalize_total"] = sc.pp.log1p(concat.layers['normalize_total'])発現量にばらつきの多い遺伝子を抽出する
次は、細胞間で発現量の変動が大きい遺伝子を見つける。ここではscanpyのexperimental.pp.highly_variable_genes()を使用する。scanpyのインストラクションを読んだ感じだと、負の二項分布にフィッティングし、残差が大きい遺伝子を拾ってくるという感じだろう。これにより、細胞間で発現のばらつきの大きな遺伝子、すわなち、その細胞の遺伝子発現プロファイルを特徴付け得る遺伝子を抽出することが出来る。
# code 28

sc.experimental.pp.highly_variable_genes(concat,
                                         layer="raw",
                                         flavor="pearson_residuals",
                                         n_top_genes=2500)
発現量に変動が多い遺伝子を検出したら、そこから、それらのみを抽出たオブジェクトconcat_hvgsを作成し、さらにそこからミトコンドリア遺伝子とリボソーム遺伝子の除くたオブジェクトconcat_hvgs_wo_MT_RIBOを作成する。これにより、強制的にクラスタリングからこれらの遺伝子を外すことが出来る。
# code 29

concat_hvgs = concat[:, concat.var["highly_variable"]]
concat_hvgs_wo_MT_RIBO = concat_hvgs[:, ~concat_hvgs.var["MT"]&~concat_hvgs.var["RIBO"]]以下で、一応、バックアップとして他のオブジェクトも作成しておく。これからオブジェクトconcat_hvgs_wo_MT_RIBOを使って、PCA、クラスタリング、UMAPで可視化したりするが、何かあったときに改めて参照できるようにする。
# code 30

concat_original.var["highly_variable"] = concat.var["highly_variable"]
concat_original_wo_MT_RIBO = concat_original[:, ~concat_original.var["MT"]&~concat_original.var["RIBO"]]細胞周期関連遺伝子の発現量をスコアリングする
PCAを行う前に細胞周期関連の遺伝子がPCAの計算に大きく影響しないように、”Regress Out”必要があるが、このためにまずは細胞周期関連遺伝子の発現量に応じて細胞ごとにスコアリングしておく。これもミトコンドリア遺伝子やリボソーム遺伝子と同じように、Phenotypeが同じなのに別の細胞としてクラスタリングされてしまう原因になる。
Regress Outという用語は一般的でなく、”Re-clustering”と同じようにこの界隈の人間にしか通じない変な専門用語なので注意が必要である。
# code 31

cell_cycle_genes = [x.strip() for x in open("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Regressout_cellcyclegenes/regev_lab_cell_cycle_genes.txt")]
print(len(cell_cycle_genes))

# Split into 2 lists
s_genes = cell_cycle_genes[:43]
g2m_genes = cell_cycle_genes[43:]

cell_cycle_genes_concat_hvgs_wo_MT_RIBO = [x for x in cell_cycle_genes if x in concat_hvgs_wo_MT_RIBO.var_names]
print(len(cell_cycle_genes_concat_hvgs_wo_MT_RIBO))
sc.tl.score_genes_cell_cycle(concat_hvgs_wo_MT_RIBO, s_genes=s_genes, g2m_genes=g2m_genes)

cell_cycle_genes_concat = [x for x in cell_cycle_genes if x in concat.var_names]
print(len(cell_cycle_genes_concat))
sc.tl.score_genes_cell_cycle(concat, s_genes=s_genes, g2m_genes=g2m_genes)
code 28で、対照となる全遺伝子のデータセットを正規化したが、その後にcode 29でそこから細胞ごとに変動の多い遺伝子を抽出し、さらにミトコンドリア遺伝子とリボソーム遺伝子を除くことで新しくオブジェクトconcat_hvgs_wo_MT_RIBOを作成しているため、もう一度そのデータセットを正規化した方が良いだろうと思う。なので、もう一度code 28と同様の方法で正規化する。
# code 32

concat_hvgs_wo_MT_RIBO.layers["raw"] = concat_hvgs_wo_MT_RIBO.X.copy()
# concat_hvgs_wo_MT_RIBO.layers["sqrt_norm"] = np.sqrt(sc.pp.normalize_total(concat_hvgs_wo_MT_RIBO, inplace=False)["X"])
concat_hvgs_wo_MT_RIBO.layers["normalize_total"] = sc.pp.normalize_total(concat_hvgs_wo_MT_RIBO, inplace=False)["X"]
concat_hvgs_wo_MT_RIBO.layers["sqrt_normalize_total"] = np.sqrt(sc.pp.normalize_total(concat_hvgs_wo_MT_RIBO, inplace=False)["X"])
concat_hvgs_wo_MT_RIBO.layers["log1p_normalize_total"] = sc.pp.log1p(concat_hvgs_wo_MT_RIBO.layers['normalize_total'])
concat_hvgs_wo_MT_RIBO.layers["normalize_pearson"] = sc.experimental.pp.normalize_pearson_residuals(concat_hvgs_wo_MT_RIBO, inplace=False)["X"]
# concat_hvgs_wo_MT_RIBO.layers["pearson_normalized"] = csr_matrix(sc.experimental.pp.normalize_pearson_residuals(concat_hvgs_wo_MT_RIBO, inplace=False)["X"])

#sc.experimental.pp.normalize_pearson_residuals(concat_hvgs_wo_MT_RIBO)
# concat_hvgs_wo_MT_RIBO_normalized = sc.experimental.pp.normalize_pearson_residuals(concat_hvgs_wo_MT_RIBO, layer="raw", inplace=False)
# concat_hvgs_wo_MT_RIBO.layers["normalized"] = csr_matrix(concat_hvgs_wo_MT_RIBO_normalized["X"])


# concat_hvgs_wo_MT_RIBO.layers["sqrt_norm"] = sc.pp.normalize_total(concat_hvgs_wo_MT_RIBO, inplace=False)["X"]
# np.sqrt(sc.pp.normalize_total(concat_hvgs_wo_MT_RIBO, inplace=False)["X"])(concat_hvgs_wo_MT_RIBO, inplace=False)["X"])PCAの前に細胞間のミトコンドリア遺伝子とリボソーム遺伝子の発現量のばらつきを無くす。スコアにはcalculate_qc_metrics()やscore_genes_cell_cycle()で計算したpct_counts_MT、pct_counts_RIBO、S_score、G2M_scoreを使用する。この処理は他の人には通じない専門用語で”Regress Out”と読んでいるらしい。上述したが、これをイキって、本当の専門家に「Regress Outして…」とかいうと、恥をかくので注意が必要である。あと、インストラクションをよく読んでも、これでどんな処理を行っているのか良くわからないのもなんとかしてほしい。だから「Regress Outして…」とか言って、イキる羽目になる。
# code 33

sc.pp.regress_out(concat_hvgs_wo_MT_RIBO, ["pct_counts_MT", "pct_counts_RIBO", "S_score", "G2M_score"], layer="normalize_pearson") # "total_counts", "n_genes_by_counts"

# <15818x2413 sparse matrix of type '<class 'numpy.float32'>'
# with 9704291 stored elements in Compressed Sparse Row format>PCA
PCAで次元削減する。設定するパラメータはデフォルトでよい。計算に再現性がほしいので、random_stateに59867776を入れる。この数字はなんでも良い。ここでは、デタラメにテンキーを打って得た数字を入れている。
pca_variance_ratio()でどのくらいの主成分が必要なのかを確認できる。これを見ると、主成分間のばらつきがなくなるあたりが、必要な主成分の数になる。ここではPC15くらいで落ち着いた感じがする。
# code 34

# 2026 08 15 done. Do not run again.
sc.pp.pca(concat_hvgs_wo_MT_RIBO, n_comps=50, random_state=59867776, layer="normalize_pearson")
sc.pl.pca_variance_ratio(concat_hvgs_wo_MT_RIBO,n_pcs=50,log=False)そういうことなので、ここではn_comps=20にしてもう一度PCAを行う。オブジェクトはアップデートされるので、もう一度PCAをしても大丈夫。PC15でも十分な気がするが、n_comps=15にするとエラーが出てしまった。なので、切りの良いところで20とする。
# code 35

# 2026 08 15 done. Do not run again.
sc.pp.pca(concat_hvgs_wo_MT_RIBO, n_comps=20, random_state=59867776, layer="normalize_pearson") # n_comps=20 50 n_comps=20
sc.pl.pca_variance_ratio(concat_hvgs_wo_MT_RIBO,n_pcs=25,log=False)PCAの次は、バッチ効果を補正する。バッチ効果とはシークエンスごとのカウントのばらつきである。実験間はもちろん、シークエンサーのレーン毎にも実験的なばらつきがこのバッチ効果として現れる。それを補正する。ばっち効果を補正する計算は沢山あるが、個人的にはscanoramaやharmonyが良いのでは無いかと思う。特にharmonyはけっこう良い値が返ってくるように思う。実体験としてもそう思うし、セミナーなんかでもこれがおすすめされていた。Scanpyには両者のwrapperが用意されているので、それを使えば良い。以下はscanorama。scanoramaって確かベンチマークはけっこう良かったけど、バッチ効果の補正が結構弱い気がする。
# code 36

# sc.external.pp.bbknn(concat_hvgs_wo_MT_RIBO, batch_key='batch') # bbknn
sc.external.pp.scanorama_integrate(concat_hvgs_wo_MT_RIBO, key='batch', knn = 20, sigma = 15) # scanorama
# sc.external.pp.harmony_integrate(concat_hvgs_wo_MT_RIBO, key = 'batch', basis='X_pca', adjusted_basis='X_pca_harmony') # harmony. It did not work.ここで注意点であるが、自分の環境ではharmonyのwrapperが正常に動かなかった。なので、以下ではharmonypyを別途環境にインストールして、それを使っている。データとしてはcode 34で求めたPCAの結果を用いる。
# code 37
# Get PCs from the AnnData object
pcs = concat_hvgs_wo_MT_RIBO.obsm['X_pca']
print(pcs.shape)  # (n_cells, n_pcs)

# Run Harmony on the PCA embedding
harmony_out = harmonypy.run_harmony(pcs, concat_hvgs_wo_MT_RIBO.obs, "batch")

# Store corrected PCs back in the AnnData object
concat_hvgs_wo_MT_RIBO.obsm['X_pca_harmony'] = harmony_out.Z_corrバッチ効果の補正の後に、クラスタリングを行う。まずKNN(K近傍法)で各データ点(デフォルトで15点)がどの点に近いのか、その値を推定する。
# code 38
# 2026 08 15 done. Do not run again.
sc.pp.neighbors(concat_hvgs_wo_MT_RIBO, n_neighbors=15, n_pcs=20, key_added= 'original', random_state=59867776, use_rep='X_pca_harmony') # n_neighbors=15 20, n_pcs=20 50, key_added=None次にその点をLouvain法を使ってクラスタリングするらしい。Louvain法については、イキってると思われるからここでは書かんでおくわ。正直、どのくらいの細かさでクラスタリングすれば良いのか、いまいちわからないので、resolutionを現実的なところで細かく見ていく。しかし、結局resolution = 1.0で計算しておくのが良いかもしれない。後に細胞のタイピングを行うが、そのときにまとめたほうが良いクラスタがあれば一つにまとめてしまうためである。
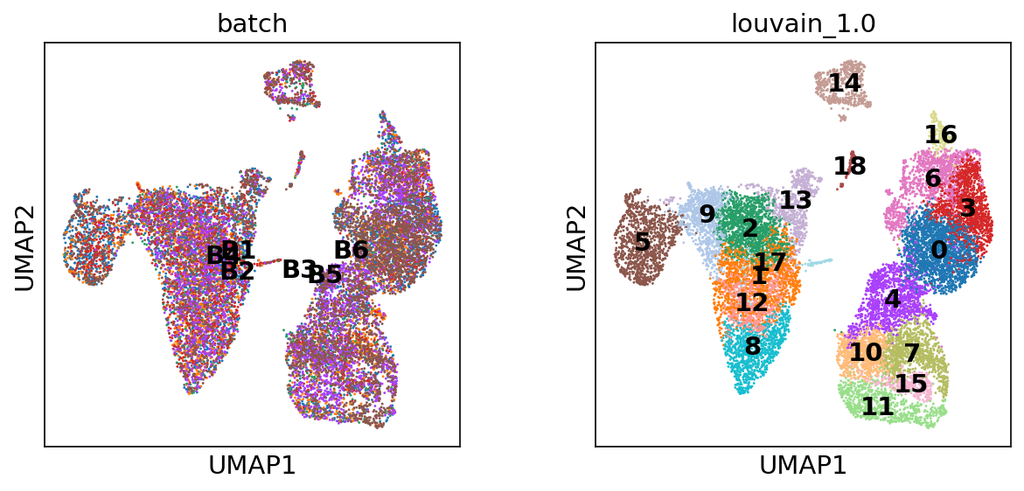
また、さらに細かくクラスタリングした方が良い場合もある。そのときは、code 35のときのPCAで、さらに細かい主成分まで求めて(たとえばデフォルトのn_comps = 50にして)、それをpp.neighbors()、とそれに引き続くtl.louvain()に入れれば良い。余談だが、この解析でも実はn_comps=にすると、論文のようにgdT細胞が別れてくるし、ナイーブヘルパーT細胞も別れてくる。もちろん、明確なクラスタに別れなくても、マーカー遺伝子でそれらの区別がつくようならば、オブザベーション(つまり細胞)を直接分類して(ここで言えば、concat.obs[“celltype_3”]という変数を新しく作って)しまえばよい。今回の解析もそうだが、あまり細かくやっても、UMAPのグラフがガタガタになってしまうし、不必要に細かくしなくても解析に差し障りないとも言える。それが重要な結果ならば話は別だが。
# code 39

# 2026 07 07 done. Do not run again.

sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_0.1", resolution=0.1, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_0.2", resolution=0.2, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_0.3", resolution=0.3, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_0.4", resolution=0.4, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_0.5", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_0.6", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_0.7", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_0.8", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_0.9", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(concat_hvgs_wo_MT_RIBO, key_added="louvain_1.0", resolution=1.0, neighbors_key = 'original', random_state=59867776)

# # neighbors_key = str | None (default: None)
# # Use neighbors connectivities as adjacency.
# # If not specified, louvain looks at .obsp[‘connectivities’] for connectivities (default storage place for pp.neighbors).
# # If specified, louvain looks at .obsp[.uns[neighbors_key][‘connectivities_key’]] for connectivities.クラスタリングの次は可視化のためにUMAPする。ここでは2次元に落とし込むことにする。UMAPの詳しい計算も、イキってると思われるのでここでは述べない。GoogleかChatGPTに聞いてほしい。ちゃんと教えてくれる。
# code 40

sc.tl.umap(concat_hvgs_wo_MT_RIBO, n_components=2, neighbors_key = 'original', random_state=59867776)UMAPしたら、次はそれを可視化する。これで、どのくらい細かいクラスタリングが必要なのかを判断する。しかしながら、やはりこの情報だけでそのクラスタリングの細かさはわからないのではないだろうか。
# code 41

sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.1"], layer="sqrt_norm")
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.2"], layer="sqrt_norm")
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.3"], layer="sqrt_norm")
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.4"], layer="sqrt_norm")
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.5"], layer="sqrt_norm")
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.6"], layer="sqrt_norm")
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.7"], layer="sqrt_norm")
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.8"], layer="sqrt_norm")
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.9"], layer="sqrt_norm")
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color=['batch', "louvain_1.0"], layer="sqrt_norm")別の観点から、シークエンスのバッチ(シークエンスのレーン、実験ごと)毎にUMAPを描いてみる。ここでは「どのサンプルはえらい細胞数が少ないな」とか「なんかこのサンプルはあるクラスタ(例えば4番)が全然いないな」とか「バッチエフェクト全然補正されてないやん!どういうこと?」とかがわかる。
# code 42
for batch in ['B1', 'B2', 'B3', 'B4', 'B5', 'B6']:
    sc.pl.umap(concat_hvgs_wo_MT_RIBO,
               color='batch',
groups=[batch])以下は対照となるバッチ以外は白にして、対照となるバッチだけをドットで表示した例である。あるサンプルはとあるクラスターが全然いない、とかを表示するには対照外のドットは見えない方が良い場合もある。
# code 43
for batch in ['B1', 'B2', 'B3', 'B4', 'B5', 'B6']:
sc.pl.umap(concat_hvgs_wo_MT_RIBO, color='batch', groups=[batch], na_color='white')次元削減には、オブジェクトconcat_hvgs_wo_MT_RIBOを使ってきた。ここで、次元削減で得られた値を元のオブジェクトconcatにも反映させておく。以降は、この元のオブジェクトconcatを使用していく。
# code 44
concat.uns = concat_hvgs_wo_MT_RIBO.uns
concat.obsm = concat_hvgs_wo_MT_RIBO.obsm
# concat.varm = concat_hvgs_wo_MT_RIBO.varm
concat.obsp = concat_hvgs_wo_MT_RIBO.obsp
同様にクラスタリングの結果もオブジェクトconcatに反映させる。
# code 45
concat.obs["louvain_0.1"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.1"]
concat.obs["louvain_0.2"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.2"]
concat.obs["louvain_0.3"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.3"]
concat.obs["louvain_0.4"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.4"]
concat.obs["louvain_0.5"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.5"]
concat.obs["louvain_0.6"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.6"]
concat.obs["louvain_0.7"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.7"]
concat.obs["louvain_0.8"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.8"]
concat.obs["louvain_0.9"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.9"]
concat.obs["louvain_1.0"] = concat_hvgs_wo_MT_RIBO.obs["louvain_1.0"]

concat_original_wo_MT_RIBO.obs["louvain_0.1"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.1"]
concat_original_wo_MT_RIBO.obs["louvain_0.2"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.2"]
concat_original_wo_MT_RIBO.obs["louvain_0.3"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.3"]
concat_original_wo_MT_RIBO.obs["louvain_0.4"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.4"]
concat_original_wo_MT_RIBO.obs["louvain_0.5"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.5"]
concat_original_wo_MT_RIBO.obs["louvain_0.6"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.6"]
concat_original_wo_MT_RIBO.obs["louvain_0.7"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.7"]
concat_original_wo_MT_RIBO.obs["louvain_0.8"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.8"]
concat_original_wo_MT_RIBO.obs["louvain_0.9"] = concat_hvgs_wo_MT_RIBO.obs["louvain_0.9"]
concat_original_wo_MT_RIBO.obs["louvain_1.0"] = concat_hvgs_wo_MT_RIBO.obs["louvain_1.0"]
確認のためにオブジェクトconcatでもUMAPをプロットしてみる。結局、resolution = 1.0の結果を使っていくことにする。
# code 46
# Clusters
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson")
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson")
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson")
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson")
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson")
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson")
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson")
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson")
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson")
sc.pl.umap(concat, color=['batch', "louvain_1.0"], layer="normalize_pearson", legend_loc="on data", save = "_louvain_1.0.png")
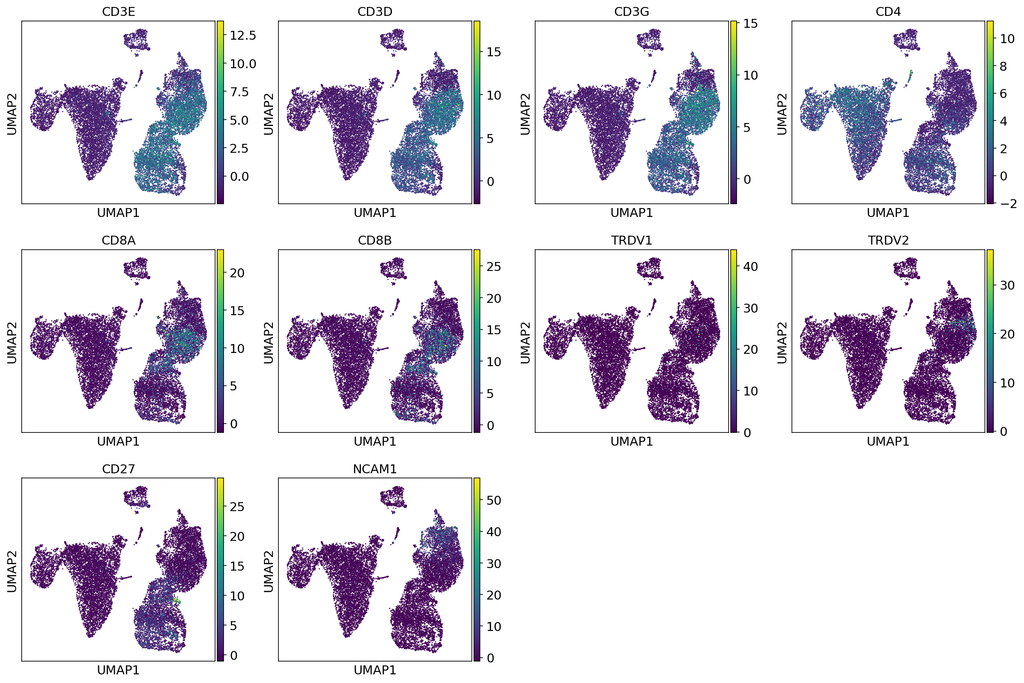
ここで、どのクラスターがどの細胞なのかをざっくりと判断する。ここでようやく、どのくらいの細かさでlouvain法によりクラスタリングすれば良かったのかがなんとなくわかってくる。ここでは、代表的なところで以下のような遺伝子の各クラスターでの発現量を確認していく。
| 遺伝子 | 細胞の種類 |
|---|---|
| CD3E, CD3D, CD3G | T細胞 |
| CD4 | ヘルパーT細胞 |
| CD8A, CD8B | 細胞障害性T細胞 |
| TRDV1, TRDV2, | gamma-deltaT細胞 |
| SELL(CD62L), CCR7, IL7R, IL2RG, | ナイーブT細胞 |
| IL2RA, CD44, CD69 | ナイーブT細胞で発現が少ない |
| CD27, CD28 | メモリーT細胞 |
| ITGAM(CD11B), SIRPA, CD33 | 骨髄系細胞 |
| ITGAX(CD11C), CLEC10A, CD1C | 樹状細胞(cDC; conventional DC) |
| ITGAX(CD11C), CLEC4C, IL3RA, TLR7, TLR9, NRP1 | 樹状細胞(pDC; plasmacytoid DC) |
| CD14, CD68, ADGRE1(マウスで言うところのF4/80), CD86, CD80, CD83 | 単球・マクロファージ |
| FCGR3A(CD16), FCGR3B, NCAM1, KLRK1, IL32, NKG7, GZMA, GNLY,PRF1, CST7, CD2, CCL5, IFNG | NK細胞・細胞障害性T細胞 |
| CD19, MS4A1(CD20), CD79A, CD79B | B細胞 |
| FOXP3, IL2RA(CD25) | 制御性T細胞 |
| B2M, HLA-A, HLA-B, HLA-C, HLA-E, HLA-F, HLA-G | MHCクラスI |
| HLA-DPA1, HLA-DPB1, HLA-DQA1, HLA-DQA2, HLA-DQB1, HLA-DRA, HLA-DRB1,HLA-DRB5 | MHCクラスII |
| TCF7, TOX, HAVCR2(TIM3), MKI67, SOX4, RBPJ, ENTPD1, ITGAE, CD69, SLAMF6, TIGIT, CTLA4, PDCD1, CD274, LAG3 | 疲弊・活性化・ステムネス |
# code 47

print("-----------------------T cell--------------------------")
print("-----------------------CD3(+), CD4(-), CD8(-) TRDV1(+), TRDV2(+), TRDV3(+), CD27, NCAM1; gamma/delta T cell--------------------------")
# "TRDV3" was not detected in the datasets.
T = ["CD3E", "CD3D", "CD3G", "CD4", "CD8A", "CD8B", "TRDV1", "TRDV2","CD27", "NCAM1"]
sc.pl.umap(concat, color=T, layer="normalize_pearson", ncols=4, save = "_T.png")

print("----------------------Naive T--------------------------")
print("----------------------IL2RA, CD44, CD69 are lacking in Naive T--------------------------")
print("----------------------CD27, CD28 are lacking in Terminally differentiated memory T--------------------------")
Naive_T = ["SELL", "CCR7", "IL7R", "IL2RG", "IL2RA", "CD44", "CD69", "CD27", "CD28"]
sc.pl.umap(concat, color=Naive_T, layer="normalize_pearson", ncols=4, save = "_Naive_T.png")

print("-----------------------ITGAX (CD11C); myeloid, classic DC--------------------------")
sc.pl.umap(concat, color=['ITGAX', 'CLEC10A', 'CD1C'], layer="normalize_pearson", save = "_cDC.png")

print("-----------------------ITGAX (CD11C); plasmacytoid DC--------------------------")
sc.pl.umap(concat, color=['ITGAX', 'CLEC4C', 'IL3RA', 'TLR7', 'TLR9', 'NRP1'], layer="normalize_pearson", save = "_pDC.png")

print("-----------------------ITGAM (CD11B); myeloid--------------------------")
CD11B_myeloid = ["ITGAM", "SIRPA", "CD33"]
# ITGAM ; CD11B
# SIRPA; CD172A
sc.pl.umap(concat, color=CD11B_myeloid, layer="normalize_pearson", ncols=4, save = "_CD11B_myeloid.png")

print("----------------------Monocyte, Macrophage--------------------------")
Mono_Mac = ["CD14", "CD68", "ADGRE1", 'CD86', 'CD80', 'CD83']
# B7; CD80
sc.pl.umap(concat, color=Mono_Mac, layer="normalize_pearson", ncols=4, save = "_Monocyte_Macrophage.png")


print("----------------------NK and cytotoxic (or Monocyte)--------------------------")

NK_Cytotoxic = ["FCGR3A", "FCGR3B", "NCAM1", "KLRK1",
                "IL32", "NKG7", "GZMA", "GNLY","PRF1",
                "CST7", "CD2", "CCL5", "IFNG"]
# FCGR3A; CD16
sc.pl.umap(concat, color=NK_Cytotoxic, layer="normalize_pearson", ncols=4, save = "_NK_Cytotoxic.png")

print("----------------------B--------------------------")
B = ["CD19", "MS4A1", "CD79A", "CD79B"]
# MS4A1; CD20
sc.pl.umap(concat, color=B, layer="normalize_pearson", ncols=4, save = "_B.png")


print("----------------------Treg--------------------------")
Treg = ["FOXP3", "IL2RA"]
sc.pl.umap(concat, color=Treg, layer="normalize_pearson", ncols=4, save = "_Treg.png")

print("----------------------MHC-II--------------------------")
MHC_II = ["HLA-DPA1", "HLA-DPB1", "HLA-DQA1", "HLA-DQA2", "HLA-DQB1", "HLA-DRA", "HLA-DRB1","HLA-DRB5"]
# sc.pl.umap(concat, color=['HLA-DPA1'], layer="normalize_pearson")
# sc.pl.umap(concat, color=['HLA-DPB1'], layer="normalize_pearson")
# sc.pl.umap(concat, color=['HLA-DQA1'], layer="normalize_pearson")
# sc.pl.umap(concat, color=['HLA-DQA2'], layer="normalize_pearson")
# sc.pl.umap(concat, color=['HLA-DQB1'], layer="normalize_pearson")
# sc.pl.umap(concat, color=['HLA-DRA'], layer="normalize_pearson")
# sc.pl.umap(concat, color=['HLA-DRB1'], layer="normalize_pearson")
# # sc.pl.umap(concat, color=['HLA-DRB3'], layer="normalize_pearson")
# sc.pl.umap(concat, color=['HLA-DRB5'], layer="normalize_pearson")
# # sc.pl.umap(concat, color=['HLA-DRB4'], layer="normalize_pearson")
sc.pl.umap(concat, color=MHC_II, layer="normalize_pearson", ncols=4, save = "_MHC_II.png")


print("----------------------MHC-I--------------------------")
MHC_I = ["B2M", "HLA-A", "HLA-B", "HLA-C", "HLA-E", "HLA-F", "HLA-G"]
sc.pl.umap(concat, color=MHC_I, layer="normalize_pearson", ncols=4, save = "_MHC_I.png")
クラスタ毎のバイオリンプロットなんかも、細胞の同定にはけっこう有用だったりする。
# code 50
# SELL
# CCR7
# IL7R

# naive T cell

sc.pl.violin(concat,
              layer ='normalize_pearson',
              keys=['SELL','CCR7','IL7R'],
groupby='louvain_1.0')Celltypistによる細胞のタイピング
Celltypistを行うために、それ用にオブジェクトconcatをコピーし、新しくオブジェクトcelltypist_allを作成する。この情報は細胞の同定に使用するだけなので、別のオブジェクトで解析をしていく。コピーしたら、遺伝子名と細胞名に重複が無いように、それぞれvar_names_make_unique()とobs_names_make_unique()を実行する。
# code 51
# # celltypist using all genes, not marker genes.
concat_celltypist = concat.copy()

celltypist_all = anndata.AnnData(concat_celltypist.layers['raw'])
celltypist_all.obs = concat_celltypist.obs
celltypist_all.var = concat_celltypist.var

celltypist_all.var_names_make_unique()
celltypist_all.obs_names_make_unique()
次に、新しく作成したオブジェクトcelltypist_allを正規化しlog1p()で変換する。これはCelltypistのインストラクション通りである。そして、celtypist.annnotate()でクラスタ毎にそれらは何の細胞の可能性があるのかを推定する。対照となる細胞種はmodel = Immune_All_Low.pklで色々と変えることが出来る。これを変えながら、各クラスタは何の細胞なのかを考えていく。ここに(https://www.celltypist.org/models)、どんな細胞を分類出来るかが載っているので、目的に応じて変えれば良いと思う。余談だが、自分の研究がここに載っているモデルに一致しているようならば、もはやアノテーション方法を新しく開発する意味はないような気がする。
# code 52
# For .h5ad files, a log-normalised expression matrix (to 10,000 counts per cell) is expected (raw-count adata processed by scanpy.pp.normalize_total(target_sum=1e4) and scanpy.pp.log1p).

sc.pp.normalize_per_cell(celltypist_all, counts_per_cell_after=1e4)
sc.pp.log1p(celltypist_all)
celltypist_all_predictions_low= celltypist.annotate(celltypist_all, model = 'Immune_All_Low.pkl', majority_voting = True)
# celltypist_all = celltypist_all_predictions.to_adata()celltypist.annotate()の結果はcelltypist.dotplot()でいい感じに見ることが出来る。
# code 53
celltypist.dotplot(celltypist_all_predictions_low, use_as_reference = 'louvain_1.0', use_as_prediction = 'predicted_labels', save= "_celltypist_all_predictions_low.png")
celltypist.dotplot(celltypist_all_predictions_low, use_as_reference = 'louvain_1.0', use_as_prediction = 'majority_voting', save= "_celltypist_all_predictions_low_majority_voting.png")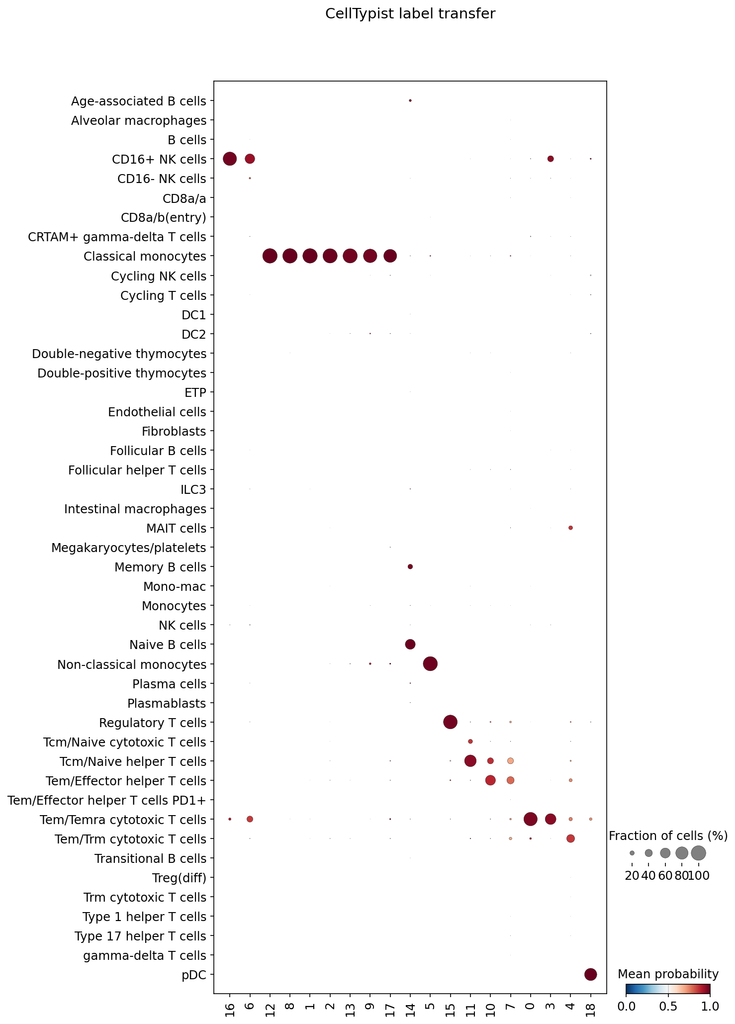
celltypist.dotplot(celltypist_all_predictions_low, use_as_reference = ‘louvain_1.0’, use_as_prediction = ‘predicted_labels’, save= “_celltypist_all_predictions_low.png”)の結果。これを見ながら、どのクラスターがどの細胞の可能性があるのかを探る。定規必須。
ここも上記と同様。色々と試して、自分の判断が正しいのか、自分ではよく分からなかったクラスターは何の細胞の可能性があるのかを検討する。しかしながら、code 47に記したマーカー遺伝子で、血球系は大方分類できると信じている。詳細な分類は、それ相応の目的がないとあんまり意味がないような気がする。なので、この解析では、結果としてcelltypistは分類の確認みたいな用途で使用した。
# code 54
celltypist_all_predictions_high= celltypist.annotate(celltypist_all, model = 'Immune_All_High.pkl', majority_voting = True)
celltypist.dotplot(celltypist_all_predictions_high, use_as_reference = 'louvain_1.0', use_as_prediction = 'predicted_labels', save= "_celltypist_all_predictions_high.png")
celltypist.dotplot(celltypist_all_predictions_high, use_as_reference = 'louvain_1.0', use_as_prediction = 'majority_voting', save= "_celltypist_all_predictions_high_majority_voting.png")
ここまでの解析を一旦保存する。anndataのwrite_h5ad()メソッドで外部に保存出来る。
# code 55

# 2026 08 17 done. Do not run again.
# THE ANALYSIS MUST BE STARTED FROM HERE.

concat.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad')
concat_hvgs_wo_MT_RIBO.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO.h5ad')以降から解析を始める場合は、code 55で保存したh5adをanndataのread_h5ad()メソッドで読み込んだら良い。
# code 56

# 2026 08 17
# THE ANALYSIS MUST BE STARTED USING FOLLOWING DATASET, concat and concat_hvgs_wo_MT_RIBO.

concat = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad')
concat_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO.h5ad')


# Following does not work. The error message is "Currently only `X` and `raw/X` can be read as sparse."

# concat = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad', as_sparse=["raw", "normalize_pearson", "normalize_total", "sqrt_normalize_total", "log1p_normalize_total"])
# concat_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO.h5ad', as_sparse=["raw", "normalize_pearson", "normalize_total", "sqrt_normalize_total", "log1p_normalize_total"])次に、code 47の代表的なマーカー遺伝子のプロットや、celltypistの結果を見ながら、クラスターに細胞名を付ける。そのために先ず特定のクラスターに細胞名を割り振る関数typecellを自分で定義する。このあたり、pythonになれていない証拠でもあるように思う。
なお、論文を見るとgamma-delta T(gdT)細胞があるクラスターとしてアノテーションされているが、確かに、このライブラリにはgdT細胞、具体的にはTRDV2の発現が高いT細胞が居る。正直、これらは個別にアノテーションするべきかもしれない。しかし、このライブラリにおけるこの細胞はCD8の発現が高く、つまり、一般的なgdT細胞とは別な可能性もある(こういうgdT細胞も居るらしいが)。なので、ここではCD3陽性CD8陽性T細胞(細胞障害性T細胞;Tc)としてアノテーションする。
# code 57

def typecell(n):
    if n == '7' or n == '10' or n == '11':
        return 'Th'
    elif n == '0' or n == '3' or n == '4':
        return 'Tc'
    elif n == '6' or n == '16':
        return 'NK'
    elif n == '14':
        return 'B'
    elif n == '15':
        return 'Treg'
    elif n == '18':
        return 'pDC'
    elif n == '9':
        return 'cDC'
    elif n == '5':
        return 'Macrophage'
    elif n == '1' or n == '2' or n == '8' or n == '12' or n == '13' or n == '17':
        return 'Monocyte'
    else:
        return 'unkown'
定義した細胞名を付けるための関数typecell()をapplyメソッドでオブジェクトconcat_hvgs_wo_MT_RIBOとオブジェクトconcatに適用する。分類後の細胞名は、各オブジェクトのデータフレームobsの列celltype_2に入れる。
# code 58
concat_hvgs_wo_MT_RIBO.obs['celltype_2'] = concat_hvgs_wo_MT_RIBO.obs['louvain_1.0'].apply(typecell)
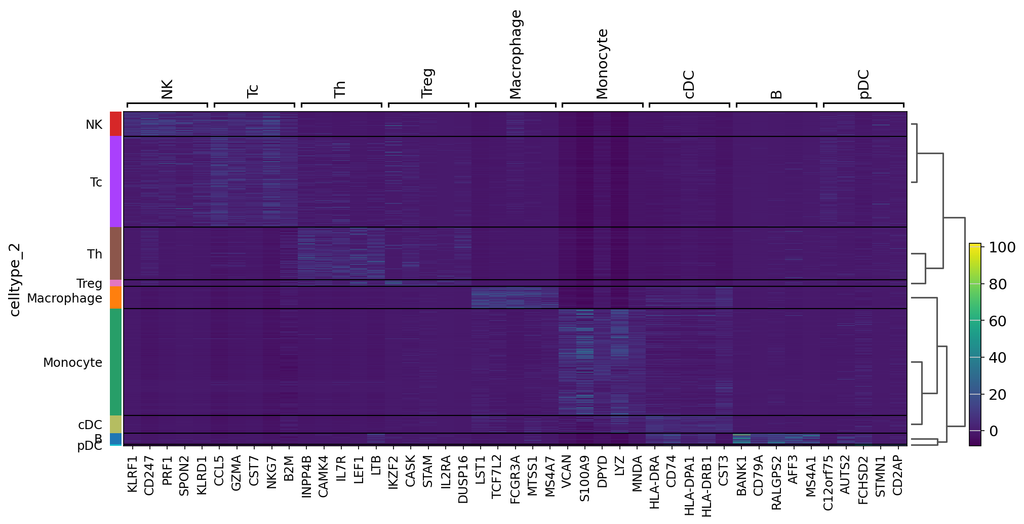
concat.obs['celltype_2'] = concat.obs['louvain_1.0'].apply(typecell)ここで、論文やSeuratのインストラクションでもよく見るあのヒートマップ(横軸を遺伝子、縦軸を細胞として、各クラスターごとのマーカー遺伝子の発現量をヒートマップで表示する)を出してみる。まず、scanpyのrank_genes_groups()でグループ毎の遺伝子の発現量をランク付し、次にそれをrank_genes_groups_heatmap()で表示する。
# code 59
sc.tl.rank_genes_groups(concat, groupby='celltype_2', method='wilcoxon', n_genes=100, layer="normalize_pearson")
sc.pl.rank_genes_groups_heatmap(concat, groupby='celltype_2', n_genes=5, show_gene_labels=True, save = "_rank_genes_groups_heatmap.png", layer="normalize_pearson")

# concat_hvgs_wo_MT_RIBO
ここで、少し話がそれてしまうが、重要なことに気がつく。
オブジェクトconcatとconcat_hvgs_wo_MT_RIBOのlayersのマトリックスnormalize_pearsonは、スパースマトリックス(scipy.sparse._csr.csr_matrix)だったはずである。しかし、もしcode 54でh5adを書き出し、一旦保存して、次にcode 55でそれらをもう一度読み込んで解析を解析した場合、それはnumpy.adarrayとして読み込まれてしまうようだ。スパースマトリックスをデータフレームとして書き出す場合、それをnumpyのtoarray()でマトリックスにしてから書き出すが、上記を行った場合、マトリックスnormalize_pearsonはすでにnumpy.adarrayになっているため、それに対してtoarray()を使うとエラーが出てしまう。逆に、この解析でcode 54とcode 55を実行しない場合、normalize_pearsonに対してtoarray()を適用しないととエラーが出るので注意が必要と思う。
ではなぜここにcode 60があるかというと、書き出す前に上記を色々と確かめていた名残である。わかっていれば、このcode 60は実行する必要はない。
# code 60
# Check data type for later export.
type(concat.layers['raw']), type(concat.layers['normalize_pearson']), type(concat_hvgs_wo_MT_RIBO.layers['raw']), type(concat_hvgs_wo_MT_RIBO.layers['normalize_pearson'])

# Following are output;
# (scipy.sparse._csr.csr_matrix,
#  numpy.ndarray,
#  scipy.sparse._csr.csr_matrix,
# numpy.ndarray)話を本解析に戻す。細胞の同定とクラスターへのアノテーションが終わったので、ここでも一旦外部に保存する。ここでも中断出来る。いや、別にこれをやらんでも、最初から計算すれば良いのだが。pythonはRより早いので、比較的すぐに計算できる。ただし、乱数を一定にしていなかったりすると別のグラフになったりするので、個人的にはこのようなチェックポイントでいちいちオブジェクトを保存するのが安心である。
最低限の作業はこのcode 61で終了である。
# code 61
# # 2026 08 17 done. Do not run again.
# # THE ANALYSIS MUST BE STARTED FROM HERE.

concat.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad')
concat_hvgs_wo_MT_RIBO.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO.h5ad')続きは、書き出したものをもう一度読み込めば良い。もちろん、体力がある人はいちいち保存しなくても良い。その場合はcode 60に注意する必要がある。code 63でも確認してある。
# code 62

# 2026 08 17
# THE ANALYSIS MUST BE STARTED USING FOLLOWING DATASET, concat and concat_hvgs_wo_MT_RIBO.
concat = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad')
concat_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO.h5ad')このcode 63も、code 60で起こったスパースマトリックスとnumpyアレイの違い問題の確認を行ったときの名残であり、特に実行する必要はない。自分がつまずいたところなので、残している。一旦、write_h5ad()で出力し、それをread_h5ad()で読み込むと、オブジェクトのlayers[“raw”]以外が、スパースマトリックスではなく、通常のマトリックス(numpy.ndarray)になってしまっている。
# code 63

# Check data type for later export.
type(concat.layers['raw']), type(concat.layers['normalize_pearson']), type(concat_hvgs_wo_MT_RIBO.layers['raw']), type(concat_hvgs_wo_MT_RIBO.layers['normalize_pearson'])必要な作業はcode 61で終了しているが、いくつかのクラスターを一つにまとめてアノテーションしている。クラスターTh、Tc、Monocyteは、さらに細かい分類が出来るように思う。ここでは、ヘルパーT細胞と細胞障害性T細胞に着目して、色々と解析をしてみようと思う。
code 64で、オブジェクトconcatからヘルパーT細胞(Th)と細胞障害性T細胞(Tc)を抽出してきて、新しくオブジェクトThとTcを作成する。同様に、オブジェクトconcat_hvgs_wo_MT_RIBOからもThとTcを抽出してきて、オブジェクトTh_hvgs_wo_MT_RIBOとTc_hvgs_wo_MT_RIBOを作成する。
# code 64

# Th

Th = concat[(concat.obs['celltype_2'] == 'Th')]
Th_hvgs_wo_MT_RIBO = concat_hvgs_wo_MT_RIBO[concat_hvgs_wo_MT_RIBO.obs['celltype_2'] == 'Th']


# Tc
Tc = concat[concat.obs['celltype_2'] == 'Tc']
Tc_hvgs_wo_MT_RIBO = concat_hvgs_wo_MT_RIBO[concat_hvgs_wo_MT_RIBO.obs['celltype_2'] == 'Tc']


# # T
# T = concat[(concat.obs['celltype_2'] == 'Th')|
#            (concat.obs['celltype_2'] == 'Tc')|
#            (concat.obs['celltype_2'] == 'Treg')]

# T_hvgs_wo_MT_RIBO  = concat_hvgs_wo_MT_RIBO[(concat_hvgs_wo_MT_RIBO.obs['celltype_2'] == 'Th')|
#                                             (concat_hvgs_wo_MT_RIBO.obs['celltype_2'] == 'Tc')|
# (concat_hvgs_wo_MT_RIBO.obs['celltype_2'] == 'Treg')]一応、UMAPを確認しておく。
# code 65

sc.pl.umap(concat, color=['batch', "celltype_2", 'louvain_1.0'], layer="normalize_pearson", legend_loc="on data", save = "_celltype2.png")
sc.pl.umap(Th, color=['batch', "celltype_2", 'louvain_1.0'], layer="normalize_pearson", legend_loc="on data")
sc.pl.umap(Tc, color=['batch', "celltype_2", 'louvain_1.0'], layer="normalize_pearson", legend_loc="on data")
# sc.pl.umap(T, color=['batch', "celltype_2", 'louvain_1.0'], layer="normalize_pearson", legend_loc="on data")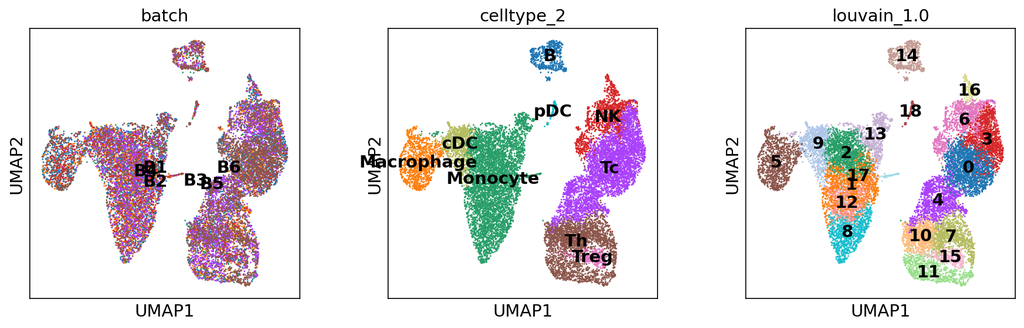
それらをanndataのwrite_h5adで出力しておく。
# code 66
# # Done at 2026 08 17
# # # THE ANALYSIS MUST BE STARTED FROM HERE.

Th.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th.h5ad')
Th_hvgs_wo_MT_RIBO.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO.h5ad')

Tc.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc.h5ad')
Tc_hvgs_wo_MT_RIBO.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO.h5ad')

# T.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/T.h5ad')
# T_hvgs_wo_MT_RIBO.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/T_hvgs_wo_MT_RIBO.h5ad')
コピーも兼ねて、code 66で出力したanndataオブジェクトThとTcをread_h5ad()で読み込み、それを新しくandataオブジェクトTh_2ndとTc_2ndとする。
# code 67
# Use them for further clustering.
Th_2nd = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th.h5ad')
Tc_2nd = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc.h5ad')
# T_2nd = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/T.h5ad')anndataオブジェクトTh_2ndとTc_2ndをもう一度クラスタリングしようと思う。素人専用専門用語で「リクラスタリング(”re-clustering”)」である。なおこの超専門用語は、専門家間でも使用されない、文字通り、素人であることを自ら証明する専門用語である。学会やディスカッションでは使用しないように。使用するにしても、ダブルクオーテーションをつけて話すべきである。
# code 68

Th_2nd.layers["raw"] = Th_2nd.X.copy()

Th_2nd.layers["normalize_total"] = sc.pp.normalize_total(Th_2nd, inplace=False)["X"]
Th_2nd.layers["sqrt_normalize_total"] = np.sqrt(sc.pp.normalize_total(Th_2nd, inplace=False)["X"])
Th_2nd.layers["log1p_normalize_total"] = sc.pp.log1p(Th_2nd.layers['normalize_total'])
Th_2nd.layers["normalize_pearson"] = sc.experimental.pp.normalize_pearson_residuals(Th_2nd, inplace=False)["X"]

# Th_2nd.layers["sqrt_norm"] = np.sqrt(sc.pp.normalize_total(Th_2nd, inplace=False)["X"])
# Th_2nd.layers["sqrt_norm"] = sc.pp.normalize_total(Th_2nd, layer = "raw", inplace=False)["X"]
# Th_2nd.layers["sqrt_norm"] = sc.pp.log1p(Th_2nd.layers['sqrt_norm'])

sc.experimental.pp.highly_variable_genes(Th_2nd,
                                         layer="raw",
                                         flavor="pearson_residuals",
                                         n_top_genes=2500)

Th_2nd_hvgs = Th_2nd[:, Th_2nd.var["highly_variable"]]
Th_2nd_hvgs_wo_MT_RIBO = Th_2nd_hvgs[:, ~Th_2nd_hvgs.var["MT"]&~Th_2nd_hvgs.var["RIBO"]]

cell_cycle_genes = [x.strip() for x in open("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Regressout_cellcyclegenes/regev_lab_cell_cycle_genes.txt")]
print(len(cell_cycle_genes))

# Split into 2 lists
s_genes = cell_cycle_genes[:43]
g2m_genes = cell_cycle_genes[43:]


cell_cycle_genes_Th_2nd = [x for x in cell_cycle_genes if x in Th_2nd_hvgs_wo_MT_RIBO.var_names]
print(len(cell_cycle_genes_Th_2nd))
sc.tl.score_genes_cell_cycle(Th_2nd_hvgs_wo_MT_RIBO, s_genes=s_genes, g2m_genes=g2m_genes)

Th_2nd_hvgs_wo_MT_RIBO.layers["raw"] = Th_2nd_hvgs_wo_MT_RIBO.X.copy()

Th_2nd_hvgs_wo_MT_RIBO.layers["normalize_total"] = sc.pp.normalize_total(Th_2nd_hvgs_wo_MT_RIBO, inplace=False)["X"]
Th_2nd_hvgs_wo_MT_RIBO.layers["sqrt_normalize_total"] = np.sqrt(sc.pp.normalize_total(Th_2nd_hvgs_wo_MT_RIBO, inplace=False)["X"])
Th_2nd_hvgs_wo_MT_RIBO.layers["log1p_normalize_total"] = sc.pp.log1p(Th_2nd_hvgs_wo_MT_RIBO.layers['normalize_total'])
Th_2nd_hvgs_wo_MT_RIBO.layers["normalize_pearson"] = sc.experimental.pp.normalize_pearson_residuals(Th_2nd_hvgs_wo_MT_RIBO, inplace=False)["X"]


# Th_2nd_hvgs_wo_MT_RIBO.layers["sqrt_norm"] = np.sqrt(sc.pp.normalize_total(Th_2nd_hvgs_wo_MT_RIBO, inplace=False)["X"])
# sc.experimental.pp.normalize_pearson_residuals(Th_2nd_hvgs_wo_MT_RIBO)

sc.pp.regress_out(Th_2nd_hvgs_wo_MT_RIBO, ["pct_counts_MT", "pct_counts_RIBO", "S_score", "G2M_score"], layer="normalize_pearson") # "total_counts", "n_genes_by_counts"
sc.pp.pca(Th_2nd_hvgs_wo_MT_RIBO, n_comps=50, random_state=59867776, layer="normalize_pearson")
sc.pl.pca_variance_ratio(Th_2nd_hvgs_wo_MT_RIBO,n_pcs=50,log=False)
続いて、バッチ効果の補正からUMAPまで。
# code 69
# Get PCs from the AnnData object
pcs_Th_2nd = Th_2nd_hvgs_wo_MT_RIBO.obsm['X_pca']
print(pcs_Th_2nd.shape)  # (n_cells, n_pcs)

# Run Harmony on the PCA embedding
harmony_out_Th_2nd = harmonypy.run_harmony(pcs_Th_2nd, Th_2nd_hvgs_wo_MT_RIBO.obs, "batch")

# Store corrected PCs back in the AnnData object
Th_2nd_hvgs_wo_MT_RIBO.obsm['X_pca_harmony'] = harmony_out_Th_2nd.Z_corr

sc.pp.neighbors(Th_2nd_hvgs_wo_MT_RIBO, n_neighbors=15, n_pcs=20, key_added= 'original', random_state=59867776, use_rep='X_pca_harmony') # n_neighbors=15 20, n_pcs=20 50, key_added=None
Th_2nd_hvgs_wo_MT_RIBO.obsp['original_connectivities']
Th_2nd_hvgs_wo_MT_RIBO.obsp['original_distances']

sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.1_2", resolution=0.1, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.2_2", resolution=0.2, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.3_2", resolution=0.3, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.4_2", resolution=0.4, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.5_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.6_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.7_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.8_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.9_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Th_2nd_hvgs_wo_MT_RIBO, key_added="louvain_1.0_2", resolution=1.0, neighbors_key = 'original', random_state=59867776)

sc.tl.umap(Th_2nd_hvgs_wo_MT_RIBO, n_components=2, neighbors_key = 'original', random_state=59867776)

sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.1_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.2_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.3_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.4_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.5_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.6_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.7_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.8_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.9_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_1.0_2"], layer="pearson_residuals")
sc.pl.umap(Th_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_1.0", "louvain_1.0_2"], layer="pearson_residuals", legend_loc="on data")anndataオブジェクトThのヒートマップ。
# code 70
sc.tl.rank_genes_groups(Th_2nd, groupby='louvain_1.0', method='wilcoxon', n_genes=100, layer="normalize_pearson")
sc.pl.rank_genes_groups_heatmap(Th_2nd, groupby='louvain_1.0', n_genes=20, show_gene_labels=True, save = "_rank_genes_groups_heatmap_Th.png", layer="normalize_pearson")クラスタリングの結果を元のオブジェクトにコピーする。
# code 71

Th_2nd.uns = Th_2nd_hvgs_wo_MT_RIBO.uns
Th_2nd.obsm = Th_2nd_hvgs_wo_MT_RIBO.obsm
#Th_2nd.varm = Th_2nd_hvgs_wo_MT_RIBO.varm
Th_2nd.obsp = Th_2nd_hvgs_wo_MT_RIBO.obsp

Th_2nd.obs["louvain_0.1_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.1_2"]
Th_2nd.obs["louvain_0.2_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.2_2"]
Th_2nd.obs["louvain_0.3_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.3_2"]
Th_2nd.obs["louvain_0.4_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.4_2"]
Th_2nd.obs["louvain_0.5_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.5_2"]
Th_2nd.obs["louvain_0.6_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.6_2"]
Th_2nd.obs["louvain_0.7_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.7_2"]
Th_2nd.obs["louvain_0.8_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.8_2"]
Th_2nd.obs["louvain_0.9_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.9_2"]
Th_2nd.obs["louvain_1.0_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_1.0_2"]
anndataオブジェクトTh_2ndのクラスタリング、UMAP結果を、元のオブジェクトThにコピーする。
# code 82

# Add umap culster name at Th_2nd into Th

# Th.uns = Th_2nd_hvgs_wo_MT_RIBO.uns
# Th.obsm = Th_2nd_hvgs_wo_MT_RIBO.obsm
# #Th.varm = Th_2nd_hvgs_wo_MT_RIBO.varm
# Th.obsp = Th_2nd_hvgs_wo_MT_RIBO.obsp

Th.obs["louvain_0.1_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.1_2"]
Th.obs["louvain_0.2_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.2_2"]
Th.obs["louvain_0.3_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.3_2"]
Th.obs["louvain_0.4_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.4_2"]
Th.obs["louvain_0.5_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.5_2"]
Th.obs["louvain_0.6_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.6_2"]
Th.obs["louvain_0.7_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.7_2"]
Th.obs["louvain_0.8_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.8_2"]
Th.obs["louvain_0.9_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.9_2"]
Th.obs["louvain_1.0_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_1.0_2"]

# Th_hvgs_wo_MT_RIBO.uns = Th_2nd_hvgs_wo_MT_RIBO.uns
# Th_hvgs_wo_MT_RIBO.obsm = Th_2nd_hvgs_wo_MT_RIBO.obsm
# #Th_hvgs_wo_MT_RIBO.varm = Th_2nd_hvgs_wo_MT_RIBO.varm
# Th_hvgs_wo_MT_RIBO.obsp = Th_2nd_hvgs_wo_MT_RIBO.obsp

Th_hvgs_wo_MT_RIBO.obs["louvain_0.1_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.1_2"]
Th_hvgs_wo_MT_RIBO.obs["louvain_0.2_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.2_2"]
Th_hvgs_wo_MT_RIBO.obs["louvain_0.3_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.3_2"]
Th_hvgs_wo_MT_RIBO.obs["louvain_0.4_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.4_2"]
Th_hvgs_wo_MT_RIBO.obs["louvain_0.5_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.5_2"]
Th_hvgs_wo_MT_RIBO.obs["louvain_0.6_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.6_2"]
Th_hvgs_wo_MT_RIBO.obs["louvain_0.7_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.7_2"]
Th_hvgs_wo_MT_RIBO.obs["louvain_0.8_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.8_2"]
Th_hvgs_wo_MT_RIBO.obs["louvain_0.9_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.9_2"]
Th_hvgs_wo_MT_RIBO.obs["louvain_1.0_2"] = Th_2nd_hvgs_wo_MT_RIBO.obs["louvain_1.0_2"]
UMAP上で各マーカー遺伝子の発現量を、クラスター毎に確認する。
# code 73

print("----------------------Naive T--------------------------")
print("----------------------IL2RA, CD44, CD69 are lacking in Naive T--------------------------")
print("----------------------CD27, CD28 are lacking in Terminally differentiated memory T--------------------------")
Naive_T = ["SELL", "CCR7", "IL7R", "IL2RG", "IL2RA", "CD44", "CD69", "ITGAE","FAS", "IL2RB", "CD27", "CD28"]
sc.pl.umap(Th, color=Naive_T, layer="normalize_pearson", ncols=4, save = "_Naive_T_Th.png")
同様に、興味のあるマーカー遺伝子の発現量をUMAP上で確認する。
# code 74
follicular = ["CXCL10", "CXCL13", "CXCR5", "ICOS"]
sc.pl.umap(Th, color=follicular, layer="normalize_pearson", ncols=4)
今度は改めてクラスタリングしたanndataオブジェクトTh_2ndでも興味のあるマーカー遺伝子の発現量を確認する。
# code 75
print("----------------------Naive T--------------------------")
print("----------------------IL2RA, CD44, CD69 are lacking in Naive T--------------------------")
print("----------------------CD27, CD28 are lacking in Terminally differentiated memory T--------------------------")
Naive_T = ["SELL", "CCR7", "IL7R", "IL2RG", "IL2RA", "CD44", "CD69", "CD27", "CD28"]
sc.pl.umap(Th_2nd, color=Naive_T, layer="normalize_pearson", ncols=4, save = "_Naive_T_Th_2nd.png")

# Probably Naive Th is possibly Cluster 7, and Cluster 10 and 11 are possibly memory Th.write_h5ad()で保存する。
# code 76

# 2026 08 17 done. Do not run again.
# THE ANALYSIS MUST BE STARTED FROM HERE.

Th_2nd.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd.h5ad')
Th_2nd_hvgs_wo_MT_RIBO.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO.h5ad')

Th.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th.h5ad')
Th_hvgs_wo_MT_RIBO.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO.h5ad')anndataオブジェクトTcでも、上記と同様に改めてクラスタリングする。まずはPCAでまで。
# code 77

Tc_2nd.layers["raw"] = Tc_2nd.X.copy()

Tc_2nd.layers["normalize_total"] = sc.pp.normalize_total(Tc_2nd, inplace=False)["X"]
Tc_2nd.layers["sqrt_normalize_total"] = np.sqrt(sc.pp.normalize_total(Tc_2nd, inplace=False)["X"])
Tc_2nd.layers["log1p_normalize_total"] = sc.pp.log1p(Tc_2nd.layers['normalize_total'])
Tc_2nd.layers["normalize_pearson"] = sc.experimental.pp.normalize_pearson_residuals(Tc_2nd, inplace=False)["X"]

# Tc_2nd.layers["sqrt_norm"] = np.sqrt(sc.pp.normalize_total(Tc_2nd, inplace=False)["X"])
# Tc_2nd.layers["sqrt_norm"] = sc.pp.normalize_total(Tc_2nd, layer = "raw", inplace=False)["X"]
# Tc_2nd.layers["sqrt_norm"] = sc.pp.log1p(Tc_2nd.layers['sqrt_norm'])

sc.experimental.pp.highly_variable_genes(Tc_2nd,
                                         layer="raw",
                                         flavor="pearson_residuals",
                                         n_top_genes=2500)

Tc_2nd_hvgs = Tc_2nd[:, Tc_2nd.var["highly_variable"]]
Tc_2nd_hvgs_wo_MT_RIBO = Tc_2nd_hvgs[:, ~Tc_2nd_hvgs.var["MT"]&~Tc_2nd_hvgs.var["RIBO"]]

cell_cycle_genes = [x.strip() for x in open("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Regressout_cellcyclegenes/regev_lab_cell_cycle_genes.txt")]
print(len(cell_cycle_genes))

# Split into 2 lists
s_genes = cell_cycle_genes[:43]
g2m_genes = cell_cycle_genes[43:]


cell_cycle_genes_Tc_2nd = [x for x in cell_cycle_genes if x in Tc_2nd_hvgs_wo_MT_RIBO.var_names]
print(len(cell_cycle_genes_Tc_2nd))
sc.tl.score_genes_cell_cycle(Tc_2nd_hvgs_wo_MT_RIBO, s_genes=s_genes, g2m_genes=g2m_genes)

Tc_2nd_hvgs_wo_MT_RIBO.layers["raw"] = Tc_2nd_hvgs_wo_MT_RIBO.X.copy()

Tc_2nd_hvgs_wo_MT_RIBO.layers["normalize_total"] = sc.pp.normalize_total(Tc_2nd_hvgs_wo_MT_RIBO, inplace=False)["X"]
Tc_2nd_hvgs_wo_MT_RIBO.layers["sqrt_normalize_total"] = np.sqrt(sc.pp.normalize_total(Tc_2nd_hvgs_wo_MT_RIBO, inplace=False)["X"])
Tc_2nd_hvgs_wo_MT_RIBO.layers["log1p_normalize_total"] = sc.pp.log1p(Tc_2nd_hvgs_wo_MT_RIBO.layers['normalize_total'])
Tc_2nd_hvgs_wo_MT_RIBO.layers["normalize_pearson"] = sc.experimental.pp.normalize_pearson_residuals(Tc_2nd_hvgs_wo_MT_RIBO, inplace=False)["X"]


# Tc_2nd_hvgs_wo_MT_RIBO.layers["sqrt_norm"] = np.sqrt(sc.pp.normalize_total(Tc_2nd_hvgs_wo_MT_RIBO, inplace=False)["X"])
# sc.experimental.pp.normalize_pearson_residuals(Tc_2nd_hvgs_wo_MT_RIBO)

sc.pp.regress_out(Tc_2nd_hvgs_wo_MT_RIBO, ["pct_counts_MT", "pct_counts_RIBO", "S_score", "G2M_score"], layer="normalize_pearson") # "total_counts", "n_genes_by_counts"
sc.pp.pca(Tc_2nd_hvgs_wo_MT_RIBO, n_comps=50, random_state=59867776, layer="normalize_pearson")
sc.pl.pca_variance_ratio(Tc_2nd_hvgs_wo_MT_RIBO,n_pcs=50,log=False)
次に、バッチ効果の補正からUMAPまで。
# code 78

# Get PCs from the AnnData object
pcs_Tc_2nd = Tc_2nd_hvgs_wo_MT_RIBO.obsm['X_pca']
print(pcs_Tc_2nd.shape)  # (n_cells, n_pcs)

# Run Harmony on the PCA embedding
harmony_out_Tc_2nd = harmonypy.run_harmony(pcs_Tc_2nd, Tc_2nd_hvgs_wo_MT_RIBO.obs, "batch")

# Store corrected PCs back in the AnnData object
Tc_2nd_hvgs_wo_MT_RIBO.obsm['X_pca_harmony'] = harmony_out_Tc_2nd.Z_corr


sc.pp.neighbors(Tc_2nd_hvgs_wo_MT_RIBO, n_neighbors=15, n_pcs=20, key_added= 'original', random_state=59867776, use_rep='X_pca_harmony') # n_neighbors=15 20, n_pcs=20 50, key_added=None
Tc_2nd_hvgs_wo_MT_RIBO.obsp['original_connectivities']
Tc_2nd_hvgs_wo_MT_RIBO.obsp['original_distances']

sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.1_2", resolution=0.1, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.2_2", resolution=0.2, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.3_2", resolution=0.3, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.4_2", resolution=0.4, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.5_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.6_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.7_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.8_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_0.9_2", resolution=0.5, neighbors_key = 'original', random_state=59867776)
sc.tl.louvain(Tc_2nd_hvgs_wo_MT_RIBO, key_added="louvain_1.0_2", resolution=1.0, neighbors_key = 'original', random_state=59867776)

sc.tl.umap(Tc_2nd_hvgs_wo_MT_RIBO, n_components=2, neighbors_key = 'original', random_state=59867776)

sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.1_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.2_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.3_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.4_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.5_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.6_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.7_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.8_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_0.9_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_1.0_2"], layer="normalize_pearson")
sc.pl.umap(Tc_2nd_hvgs_wo_MT_RIBO, color=['batch', "louvain_1.0", "louvain_1.0_2"], layer="normalize_pearson", legend_loc="on data")クラスタリングの結果を元のオブジェクトにコピーする。
# code 79

# Copy PCA and UMAP cordination of "Tc_2nd_hvgs_wo_MT_RIBO" into that of "Tc_2nd"

Tc_2nd.uns = Tc_2nd_hvgs_wo_MT_RIBO.uns
Tc_2nd.obsm = Tc_2nd_hvgs_wo_MT_RIBO.obsm
#Tc_2nd.varm = Tc_2nd_hvgs_wo_MT_RIBO.varm
Tc_2nd.obsp = Tc_2nd_hvgs_wo_MT_RIBO.obsp

Tc_2nd.obs["louvain_0.1_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.1_2"]
Tc_2nd.obs["louvain_0.2_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.2_2"]
Tc_2nd.obs["louvain_0.3_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.3_2"]
Tc_2nd.obs["louvain_0.4_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.4_2"]
Tc_2nd.obs["louvain_0.5_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.5_2"]
Tc_2nd.obs["louvain_0.6_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.6_2"]
Tc_2nd.obs["louvain_0.7_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.7_2"]
Tc_2nd.obs["louvain_0.8_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.8_2"]
Tc_2nd.obs["louvain_0.9_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.9_2"]
Tc_2nd.obs["louvain_1.0_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_1.0_2"]
同様に、結果を元のオブジェクトにコピーする。
# code 80

# # Add umap culster name at Tc_2nd into Tc

# Tc.uns = Tc_2nd_hvgs_wo_MT_RIBO.uns
# Tc.obsm = Tc_2nd_hvgs_wo_MT_RIBO.obsm
# #Tc.varm = Tc_2nd_hvgs_wo_MT_RIBO.varm
# Tc.obsp = Tc_2nd_hvgs_wo_MT_RIBO.obsp

Tc.obs["louvain_0.1_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.1_2"]
Tc.obs["louvain_0.2_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.2_2"]
Tc.obs["louvain_0.3_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.3_2"]
Tc.obs["louvain_0.4_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.4_2"]
Tc.obs["louvain_0.5_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.5_2"]
Tc.obs["louvain_0.6_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.6_2"]
Tc.obs["louvain_0.7_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.7_2"]
Tc.obs["louvain_0.8_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.8_2"]
Tc.obs["louvain_0.9_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.9_2"]
Tc.obs["louvain_1.0_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_1.0_2"]

# Tc_hvgs_wo_MT_RIBO.uns = Tc_2nd_hvgs_wo_MT_RIBO.uns
# Tc_hvgs_wo_MT_RIBO.obsm = Tc_2nd_hvgs_wo_MT_RIBO.obsm
# #Tc_hvgs_wo_MT_RIBO.varm = Tc_2nd_hvgs_wo_MT_RIBO.varm
# Tc_hvgs_wo_MT_RIBO.obsp = Tc_2nd_hvgs_wo_MT_RIBO.obsp

Tc_hvgs_wo_MT_RIBO.obs["louvain_0.1_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.1_2"]
Tc_hvgs_wo_MT_RIBO.obs["louvain_0.2_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.2_2"]
Tc_hvgs_wo_MT_RIBO.obs["louvain_0.3_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.3_2"]
Tc_hvgs_wo_MT_RIBO.obs["louvain_0.4_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.4_2"]
Tc_hvgs_wo_MT_RIBO.obs["louvain_0.5_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.5_2"]
Tc_hvgs_wo_MT_RIBO.obs["louvain_0.6_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.6_2"]
Tc_hvgs_wo_MT_RIBO.obs["louvain_0.7_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.7_2"]
Tc_hvgs_wo_MT_RIBO.obs["louvain_0.8_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.8_2"]
Tc_hvgs_wo_MT_RIBO.obs["louvain_0.9_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_0.9_2"]
Tc_hvgs_wo_MT_RIBO.obs["louvain_1.0_2"] = Tc_2nd_hvgs_wo_MT_RIBO.obs["louvain_1.0_2"]
関心のあるマーカー遺伝子の発現量を確認する。
# code 88

print("----------------------Naive T--------------------------")
print("----------------------IL2RA, CD44, CD69 are lacking in Naive T--------------------------")
print("----------------------CD27, CD28 are lacking in Terminally differentiated memory T--------------------------")
Naive_T = ["SELL", "CCR7", "IL7R", "IL2RG", "IL2RA", "CD44", "CD69", "CD27", "CD28"]
sc.pl.umap(Tc, color=Naive_T, layer="normalize_pearson", ncols=4, save = "_Naive_T_Tc.png")同様に、関心のあるマーカー遺伝子の発現量を確認する。
# code 89
print("----------------------Naive T--------------------------")
print("----------------------IL2RA, CD44, CD69 are lacking in Naive T--------------------------")
print("----------------------CD27, CD28 are lacking in Terminally differentiated memory T--------------------------")
Naive_T = ["SELL", "CCR7", "IL7R", "IL2RG", "IL2RA", "CD44", "CD69", "CD27", "CD28"]
sc.pl.umap(Tc_2nd, color=Naive_T, layer="normalize_pearson", ncols=4, save = "_Naive_T_Tc_2nd.png")anndataオブジェクトTc_2ndにおけるマーカー遺伝子のヒートマップ。
# code 90

sc.tl.rank_genes_groups(Tc_2nd, groupby='louvain_1.0_2', method='wilcoxon', n_genes=100, layer="normalize_pearson")
sc.pl.rank_genes_groups_heatmap(Tc_2nd, groupby='louvain_1.0_2', n_genes=10, show_gene_labels=True, save = "_rank_genes_groups_heatmap_Tc.png", layer="normalize_pearson")
anndataオブジェクトTcにおけるマーカー遺伝子のヒートマップ。
# code 91

sc.tl.rank_genes_groups(Tc, groupby='louvain_1.0', method='wilcoxon', n_genes=100, layer="normalize_pearson")
sc.pl.rank_genes_groups_heatmap(Tc, groupby='louvain_1.0', n_genes=20, show_gene_labels=True, save = "_rank_genes_groups_heatmap_Tc.png", layer="normalize_pearson")anndataオブジェクトTc_2ndにおいて、関心のる遺伝子の発現量を確認する。
# code 92

print("----------------------Tc--------------------------")
hvg_Tc = ["GNLY", "GZMB", "LGALS1", "ZEB2", "CCL5", "CX3CR1", "TIGIT", "TOX", "CD27", "CD28", "SELL", "CCR7", "SOX4", "TCF7"]
sc.pl.umap(Tc, color=hvg_Tc, layer="normalize_pearson", ncols=4)write_h5ad()でオブジェクトを出力する。
# code 93

# 2026 08 17 done. Do not run again.
# THE ANALYSIS MUST BE STARTED FROM HERE.

Tc_2nd.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_2nd.h5ad')
Tc_2nd_hvgs_wo_MT_RIBO.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_2nd_hvgs_wo_MT_RIBO.h5ad')

Tc.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc.h5ad')
Tc_hvgs_wo_MT_RIBO.write_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO.h5ad')改めて、今後使用するであろうオブジェクトをwrite_h5ad()で保存する。これで上書きされるので、ある意味ではこの保存はデータのアップデートである。
# code 94

# 2026 07 25
# THE ANALYSIS MUST BE STARTED USING FOLLOWING DATASET, concat and concat_hvgs_wo_MT_RIBO.
concat = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad')
concat_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO.h5ad')

##
Th = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th.h5ad')
Th_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO.h5ad')

Tc = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc.h5ad')
Tc_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO.h5ad')
同様に、改めて作成したanndataオブジェクトもwrite_h5ad()で保存する。
# code 95

Th_2nd = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd.h5ad')
Th_2nd_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO.h5ad')

Tc_2nd = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_2nd.h5ad')
Tc_2nd_hvgs_wo_MT_RIBO_2nd = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_2nd_hvgs_wo_MT_RIBO.h5ad')
改めて行ったクラスタリングでは、クラスターThもしくはTcを更に詳しく分類しており、まだそれらをアノテーションしていない。もしかしたらこの作業は不要かもしれないが、今後、これらのアノテーションには、マーカー遺伝子よりもシグナル全体が有用だったりするかもしれない。そんなときはPseudobulkingを使用する。要は、クラスター毎のカウントを何らかの方法で集計する処理である。scanpyにはget.aggregate()というAPIが用意されているので、それを使用する。
ここでは、layer = “raw”、すなわち、正規化していないカウント値を使用し、func = “sum”を使い、総和を計算する。それを、データフレームTh_pseudobulk、Tc_pseudobulkとする。
# code 96

Th_pseudobulk = sc.get.aggregate(Th, by=['louvain_1.0'], func="sum", layer="raw")
Tc_pseudobulk = sc.get.aggregate(Tc, by=['louvain_1.0'], func="sum", layer="raw")Anndataオブジェクト(Scanpy用)からSeuratオブジェクト、SingleCellExperimentオブジェクト用にデータフレームを出力する
Scanpyで使用するAnndataオブジェクトから、Seuratや他のパッケージで使用されているオブジェクト(SeuratオブジェクトやSingleCellExperiment(sce)オブジェクトを作成するために、各Anndataオブジェクトから必要なデータをデータフレームとして出力する。
まず、Anndataオブジェクト全体を出力するためにはScanpyのwrite()を使用する。そうすると、新しくディレクトリが作られ、そのなかに各データフレームが作成される。
また、それらを個別のデータフレームとして保存したいときは、pandasのDataFrame()が使用できる。ここで注意が必要である。スパースマトリックス(scipy.sparse._csr.csr_matrix)はnumpyのtoarray()でnumpy.adarrayに変換してそれをデータフレームとして保存する必要がある。しかし、一度read_h5ad()で読み込んで作成したanndataオブジェクトは、layers[“raw”]以外はすでにnumpu.adarrayになっているので、それらにtoarray()を使う必要はない。使うとエラーが起こる。
# code 97
# output for R
# It will take time, ~ 10 min.
# Done 2026 07 25.

## concat

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat', concat, ext = 'csv')

pd.DataFrame(
    concat.layers['raw'].toarray(),
    index=concat.obs.index,
    columns=concat.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_layers_raw.csv')

pd.DataFrame(
    concat.layers['normalize_pearson'],
    index=concat.obs.index,
    columns=concat.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_layers_normalize_pearson.csv')

## concat_hvgs_wo_MT_RIBO

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO', concat_hvgs_wo_MT_RIBO, ext = 'csv')

pd.DataFrame(
    concat_hvgs_wo_MT_RIBO.layers['raw'].toarray(),
    index=concat_hvgs_wo_MT_RIBO.obs.index,
    columns=concat_hvgs_wo_MT_RIBO.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO_layers_raw.csv')

pd.DataFrame(
    concat_hvgs_wo_MT_RIBO.layers['normalize_pearson'],
    index=concat_hvgs_wo_MT_RIBO.obs.index,
    columns=concat_hvgs_wo_MT_RIBO.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO_layers_normalize_pearson.csv')

## Th

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th', Th, ext = 'csv')

pd.DataFrame(
    Th.layers['raw'].toarray(),
    index=Th.obs.index,
    columns=Th.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_layers_raw.csv')

pd.DataFrame(
    Th.layers['normalize_pearson'],
    index=Th.obs.index,
    columns=Th.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_layers_normalize_pearson.csv')

## Th_hvgs_wo_MT_RIBO

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO', Th_hvgs_wo_MT_RIBO, ext = 'csv')

pd.DataFrame(
    Th_hvgs_wo_MT_RIBO.layers['raw'].toarray(),
    index=Th_hvgs_wo_MT_RIBO.obs.index,
    columns=Th_hvgs_wo_MT_RIBO.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO_layers_raw.csv')

pd.DataFrame(
    Th_hvgs_wo_MT_RIBO.layers['normalize_pearson'],
    index=Th_hvgs_wo_MT_RIBO.obs.index,
    columns=Th_hvgs_wo_MT_RIBO.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO_layers_normalize_pearson.csv')


## Tc

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc', Tc, ext = 'csv')

pd.DataFrame(
    Tc.layers['raw'].toarray(),
    index=Tc.obs.index,
    columns=Tc.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_layers_raw.csv')

pd.DataFrame(
    Tc.layers['normalize_pearson'],
    index=Tc.obs.index,
    columns=Tc.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_layers_normalize_pearson.csv')

## Tc_hvgs_wo_MT_RIBO

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO', Tc_hvgs_wo_MT_RIBO, ext = 'csv')

pd.DataFrame(
    Tc_hvgs_wo_MT_RIBO.layers['raw'].toarray(),
    index=Tc_hvgs_wo_MT_RIBO.obs.index,
    columns=Tc_hvgs_wo_MT_RIBO.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO_layers_raw.csv')

pd.DataFrame(
    Tc_hvgs_wo_MT_RIBO.layers['normalize_pearson'],
    index=Tc_hvgs_wo_MT_RIBO.obs.index,
    columns=Tc_hvgs_wo_MT_RIBO.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO_layers_normalize_pearson.csv')

## Th_pseudobulk

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_pseudobulk', Th_pseudobulk, ext = 'csv')

pd.DataFrame(
    Th_pseudobulk.layers['sum'],
    index=Th_pseudobulk.obs.index,
    columns=Th_pseudobulk.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_pseudobulk_layers_sum.csv')

## Tc_pseudobulk

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_pseudobulk', Tc_pseudobulk, ext = 'csv')

pd.DataFrame(
    Tc_pseudobulk.layers['sum'],
    index=Tc_pseudobulk.obs.index,
    columns=Tc_pseudobulk.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_pseudobulk_layers_sum.csv')

## Th_2nd

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd', Th_2nd, ext = 'csv')

pd.DataFrame(
    Th_2nd.layers['raw'].toarray(),
    index=Th_2nd.obs.index,
    columns=Th_2nd.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_layers_raw.csv')

pd.DataFrame(
    Th_2nd.layers['normalize_pearson'],
    index=Th_2nd.obs.index,
    columns=Th_2nd.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_layers_normalize_pearson.csv')

## Th_2nd_hvgs_wo_MT_RIBO

sc.write('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO', Th_2nd_hvgs_wo_MT_RIBO, ext = 'csv')

pd.DataFrame(
    Th_2nd_hvgs_wo_MT_RIBO.layers['raw'].toarray(),
    index=Th_2nd_hvgs_wo_MT_RIBO.obs.index,
    columns=Th_2nd_hvgs_wo_MT_RIBO.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO_layers_raw.csv')

pd.DataFrame(
    Th_2nd_hvgs_wo_MT_RIBO.layers['normalize_pearson'],
    index=Th_2nd_hvgs_wo_MT_RIBO.obs.index,
    columns=Th_2nd_hvgs_wo_MT_RIBO.var_names
).to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO_layers_normalize_pearson.csv')
細胞とクラスタリングの対応表も、データフレームに残しておく。しかしながら、今見てみるとこれは使用しなかった。
# code 98

concat_metadata = pd.DataFrame(concat.obs['celltype_2'])
concat_metadata.reset_index(inplace=True)
concat_metadata = pd.DataFrame.rename(concat_metadata, columns = {'index':'Cell', 'celltype_2':'cell_type'})上記のcode 98で作成したデータフレームconcat_metadataをデータフレムとして出力する。
# code 99

# 2026 08 17 output TSV for CellPhoneDB

concat_metadata.to_csv('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_metadata.tsv', sep = '\t', index = False)
code 97から99までで出力したデータで、SeuratやCellchatなどのようなRをパッケージを使って解析していく。
velocyteとscVeloによるRNA velocity解析
ここで、ヘルパーT細胞(Th)と細胞障害性T細胞(Tc)のクラスターをRNA velocity解析してみる。この理由は、これらのT細胞は状況に依って様々な機能を持つ細胞に分化していくためである。これまで大まかにThとTcとアノテーションしたが、その中には更に様々なクラスターが別れている。その状況を知るためである。
まずはvelocytoを使用して、RNA velocityを計算する。この論文は2018年に出されたわけだけど、これを読んだとき、当時けっこう衝撃だったわ。ニューヨークの地下鉄で職場から返ってくるとき、これはすげーなと率直に思った。言うて、細かい計算なんか、全く理解していないけど、結果だけ見てそう思った。こんなことも出来るのかと思った。エクソンとイントロンにマップされたカウントを使って、スプライスと非スプライスの時間的な変化を推測するらしい。だから、”RNA velocity”。後に使用するscVeloは、要するにRNA velocityの可視化パッケージである。
velocyto
velocytoのための準備として、cellranger countで出力されたbamファイルをsamtools sortする必要がある。これはけっこう時間がかかる。
非常に微妙なことがある。velocytoはソート後のbamファイルを使用しなくても実行出来る。しかし、このソートされたbamファルがないと、「ソートされたbamファイルがない!」みたいなエラーが出てしまう。結局つかわんのに。そして、velocytoでもソートから始まるのに。
そういうことで、後のvelocytoでは使用しないにも関わらず、ここでbamファイルをソートする。出力されるファイル名としてpossorted_genome_bam.bamとする。そうないと、後のvelocytoがそのファイルを探せなくてエラーが出る。
for LOCATION in SRR24735943 SRR24735944 SRR24735945 SRR24735947 SRR24735948 SRR24735949;
do
time samtools sort -t CB -O BAM -m 2G -@ 16 --verbosity 4 \
-o "/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204"/${LOCATION}/outs/cellsorted_possorted_genome_bam.bam \
"/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204"/${LOCATION}/outs/possorted_genome_bam.bam
done次に、velocytoの出力を保存するためのディレクトリを作成する。
# SRR24735943; NCC037; B1
# SRR24735944; NCC034; B2
# SRR24735945; NCC030; B3
# SRR24735947; NCC027; B4
# SRR24735948; NCC025; B5
# SRR24735949; NCC022; B6

for DIR in SRR24735943 SRR24735944 SRR24735945 SRR24735947 SRR24735948 SRR24735949;
do
mkdir /mnt/team4tb/Dropbox/Blog/"2026 05 11 blog scRNAseq 1"/output_velocyte/${DIR}
donevelocytoを行う。このシングルセルRNAシークエンスのライブラリで合計3.5時間くらい必要だった。ここではcellranger countのときに使用したgtfファイル(genes.gtf)を使用する。そうしなければ、遺伝子のアノテーションが変わってしまう。また、ゲノム上のリピート配列のGTFファイルも必要である。UCSCゲノムブラウザからダウンロード出来る。
これで、velocytoの結果を保持したloomファイルが出来上がる。
for LOCATION in SRR24735943 SRR24735944 SRR24735945 SRR24735947 SRR24735948 SRR24735949;
do
time velocyto run \
-b /mnt/team4tb/Dropbox/Blog/"2026 05 11 blog scRNAseq 1"/bcfile_${LOCATION}.csv \
-m /mnt/team4tb/Dropbox/Blog/"2026 05 11 blog scRNAseq 1"/hg38_rmsk.gtf \
-v \
-o /mnt/team4tb/Dropbox/Blog/"2026 05 11 blog scRNAseq 1"/output_velocyte/${LOCATION} \
-@ 16 \
"/mnt/seqdata/public_data/Blog/2026 05 11 scRNAseq/result_cellranger_count_PRJNA976204"/${LOCATION}/outs/possorted_genome_bam.bam \
/home/kats/cellranger_refseq/refdata-gex-GRCh38-2024-A/genes/genes.gtf
done
scVelo
velocyteの結果を可視化する。そのためのパッケージがscVeloである。scVeloをインストールするとscanpyが使えるので、それを使用する。無理に他のパケージをインストールしなくても、基本的なものは使えるのが便利である。
import numpy as np
import pandas as pd
import matplotlib as mpl
import seaborn as sns
import scanpy as sc # need 1.9.0. latest version 1.9.3 produce error.
import sklearn
import statsmodels.api as sm
import statsmodels.formula.api as smf
from statsmodels.sandbox.regression.predstd import wls_prediction_std
import anndata
from scipy.sparse import csr_matrix
import scvelo as scv

sc.settings.verbosity = 4
sc.logging.print_header()
sc.settings.set_figure_params(dpi=80, facecolor="white")
scanpyで出力したh5adを、scanpyと同じオブジェクト名であるconcat、concat_hvgs_wo_MT_RIBO、Th、Tcとする。
# scvelo 1

concat = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad')
concat_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO.h5ad')

Th = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th.h5ad')
Th_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO.h5ad')

Tc = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc.h5ad')
Tc_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO.h5ad')

# T = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/T.h5ad')
# T_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/T_hvgs_wo_MT_RIBO.h5ad')マップされた全遺伝子を使っても良いのだが、ここではクラスター毎のマーカー遺伝子を使うのも有りだと思う。マーカー遺伝子は各クラスターを特徴付ける遺伝子になるので、効率的に解析を行うにはこれらを使った方が良いと言える。以下では、各クラスターのマーカー遺伝子を抽出したオブジェクトconcat_hvgs_wo_MT_RIBOのデータフレムobsを、データフレームbcfileとして抽出しておく。
# scvelo 2
bcfile = pd.DataFrame(concat_hvgs_wo_MT_RIBO.obs)
#bcfile = pd.DataFrame.rename(self = bcfile, columns={0: "barcode"})そこから列batchに各実験を識別する文字列、ここではB1(バッチ1)を持つ細胞のメタデータ(データフレームobsの値)をデータフレームbcfile_B1とする。そして、その行名(ipythonの場合インデックスという。ここでは細胞名、バーコード名)をデータフレームbcfile_B1_velocyteとし、その列名をB1にする。これをB6まで行う。
# scvelo 3
bcfile_B1 = bcfile[bcfile.batch.str.contains('B1') == True]
bcfile_B2 = bcfile[bcfile.batch.str.contains('B2') == True]
bcfile_B3 = bcfile[bcfile.batch.str.contains('B3') == True]
bcfile_B4 = bcfile[bcfile.batch.str.contains('B4') == True]
bcfile_B5 = bcfile[bcfile.batch.str.contains('B5') == True]
bcfile_B6 = bcfile[bcfile.batch.str.contains('B6') == True]

bcfile_B1_velocyto = pd.DataFrame(bcfile_B1.index)
bcfile_B1_velocyto = bcfile_B1_velocyto.rename(columns={0:'B1'})

bcfile_B2_velocyto = pd.DataFrame(bcfile_B2.index)
bcfile_B2_velocyto = bcfile_B2_velocyto.rename(columns={0:'B2'})

bcfile_B3_velocyto = pd.DataFrame(bcfile_B3.index)
bcfile_B3_velocyto = bcfile_B3_velocyto.rename(columns={0:'B3'})

bcfile_B4_velocyto = pd.DataFrame(bcfile_B4.index)
bcfile_B4_velocyto = bcfile_B4_velocyto.rename(columns={0:'B4'})

bcfile_B5_velocyto = pd.DataFrame(bcfile_B5.index)
bcfile_B5_velocyto = bcfile_B5_velocyto.rename(columns={0:'B5'})

bcfile_B6_velocyto = pd.DataFrame(bcfile_B6.index)
bcfile_B6_velocyto = bcfile_B6_velocyto.rename(columns={0:'B6'})
ここで、velocytoの計算結果を読み込む。ここではscanpyのread_loom()を利用する。読み込んだオブジェクトをB1_veloとする。これをB6まで行う。scanpyなので、これらはanndataオブジェクトになる。
# scvelo 4

B1_velo = sc.read_loom('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_velocyte/SRR24735943/possorted_genome_bam_110C6.loom')
B2_velo = sc.read_loom('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_velocyte/SRR24735944/possorted_genome_bam_T9QGH.loom')
B3_velo = sc.read_loom('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_velocyte/SRR24735945/possorted_genome_bam_49K5N.loom')
B4_velo = sc.read_loom('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_velocyte/SRR24735947/possorted_genome_bam_4L5GS.loom')
B5_velo = sc.read_loom('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_velocyte/SRR24735948/possorted_genome_bam_0HGTB.loom')
B6_velo = sc.read_loom('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_velocyte/SRR24735949/possorted_genome_bam_75TXW.loom')scanpyでのクラスタリングと同様に、遺伝子名(データフレームvar)と細胞名(データフレームobs)の重複を無くす。
# scvelo 5
B1_velo.var_names_make_unique()
B1_velo.obs_names_make_unique()

B2_velo.var_names_make_unique()
B2_velo.obs_names_make_unique()

B3_velo.var_names_make_unique()
B3_velo.obs_names_make_unique()

B4_velo.var_names_make_unique()
B4_velo.obs_names_make_unique()

B5_velo.var_names_make_unique()
B5_velo.obs_names_make_unique()

B6_velo.var_names_make_unique()
B6_velo.obs_names_make_unique()各データを連結する。anndataのconcatenateメソッドを使う。
# scvelo 6
# All
all_velo = B1_velo.concatenate(
    B2_velo,
    B3_velo,
    B4_velo,
    B5_velo,
    B6_velo,
    batch_categories=['B1', 'B2', 'B3', 'B4', 'B5', 'B6'])
scVeloのclean_obs_names()により、データフレームobsのインデックスから、余計な文字列を除く。以下はインデックスから文字数16の核酸A、G、T、Cを除く、ということらしい。これをB1からB6まで行う。
# scvelo 7

scv.utils.clean_obs_names(all_velo, alphabet='[AGTC]', id_length=16)
scv.utils.clean_obs_names(B1_velo, alphabet='[AGTC]', id_length=16)
scv.utils.clean_obs_names(B2_velo, alphabet='[AGTC]', id_length=16)
scv.utils.clean_obs_names(B3_velo, alphabet='[AGTC]', id_length=16)
scv.utils.clean_obs_names(B4_velo, alphabet='[AGTC]', id_length=16)
scv.utils.clean_obs_names(B5_velo, alphabet='[AGTC]', id_length=16)
scv.utils.clean_obs_names(B6_velo, alphabet='[AGTC]', id_length=16)
クラスタリングの結果とvelocytoの結果を結合する。concatがscanpyでクラスタリングまで行ったanndataオブジェクト、all_veloがvelocytoの結果のanndataオブジェクトである。
# scvelo 8

# All
concat_velo = scv.utils.merge(adata = concat,
ldata = all_velo)パイチャートで、スプライスされたRNA、スプライスされていないRNAなどの比率を確認する。
# scvelo 9
scv.pl.proportions(concat_velo)ある一定のカウント数以下の遺伝子を除外する。このあたりはscanpyでのQCで終了しているので、ひとまずカウント数が1あれば残す。
# scvelo 10
scv.pp.filter_genes(concat_velo, min_shared_counts=1)正規化する。scVeloで使用されるのはライブラリサイズによる正規化である。
# scvelo 11
scv.pp.normalize_per_cell(concat_velo)カウントのばらつきを求める。論文を読んでいると、scVeloではシンプルに標準偏差を使っているらしい。ここでは、ばらつきが大きい遺伝子のトップ3000を残す。
# scvelo 12
sc.pp.filter_genes_dispersion(concat_velo, n_top_genes=3000)それらをlog1pに変換する。
# scvelo 13
sc.pp.log1p(concat_velo)scveloのpp.moments()で、PCAやKNNの値を取得する。PCの数やKNNの計算に利用する点の数は、scanpyのときと同様にしておく。
# scvelo 14
scv.pp.moments(concat_velo, n_pcs=20, n_neighbors=15)scVeloのtl.velocity()でRNA velocityを計算する。マニュアルを読んでも、正直何言ってるかわからん。地球語でしゃべってください。
# scvelo 15
scv.tl.velocity(concat_velo)何してるかわからん。RNA velocityの結果を分類しているのはわかる。地球語でしゃべってください。
# scvelo 16
scv.tl.velocity_graph(concat_velo)ここで、RNA velocity解析の結果を可視化する。arrow_styleのところで、スプライシングの時間変化の向きを矢印(->)か三角(-|>)かを選べる。
# scvelo 17
scv.pl.velocity_embedding_stream(concat_velo,
                                 basis='umap',
                                 color='louvain_1.0',
                                 arrow_style = '-|>',
                                 max_length = 5,
                                 min_mass = 0,
                                 size = 30,
                                 dpi = 400, save = 'concat_velo_stream_umap_louvain_1.0.png')
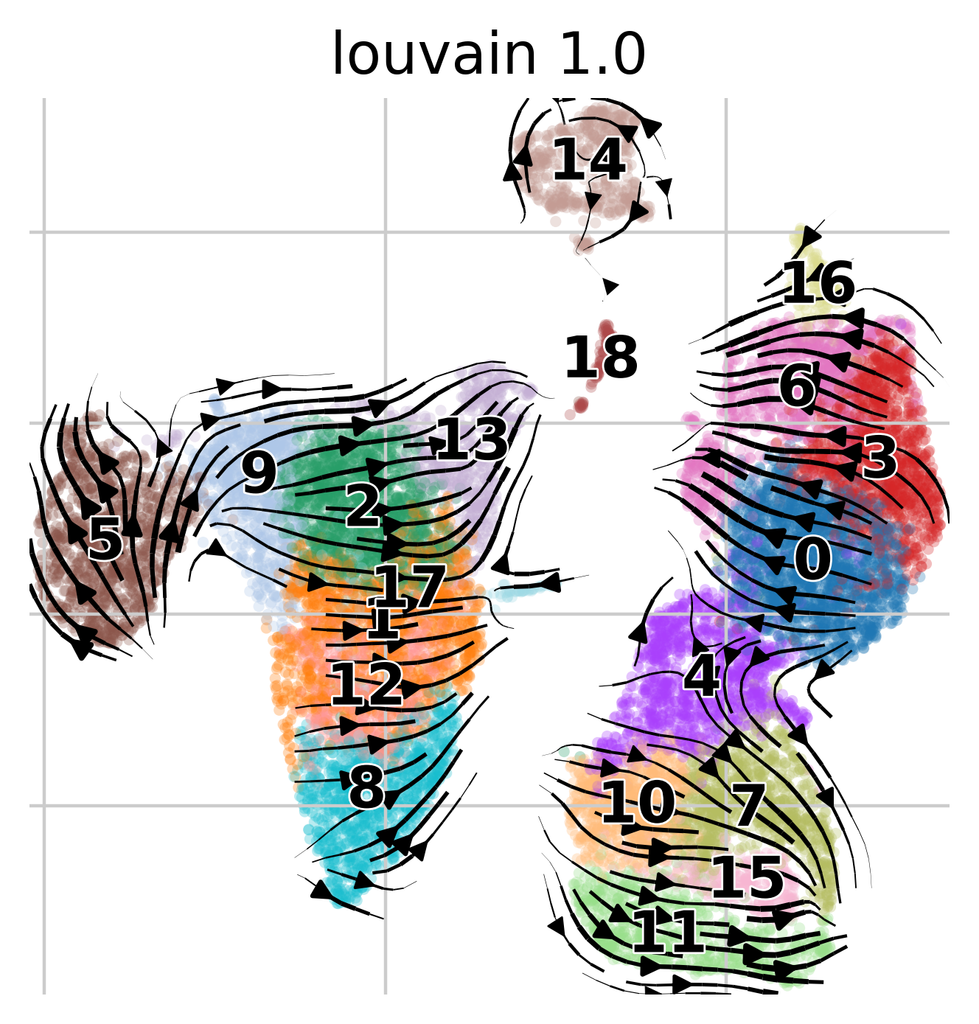
同様に、今度は表示するラベルを増やしてみる。ここでは列louvain_1.0と列batch毎に表示する。ここまでが必要な解析である。これで、各クラスターの細胞のトランスクリプトームが、どのような時間的な変化をしているのかがわかる。T細胞などは、ナイーブT細胞、エフェクターT細胞、メモリーT細胞のようにある程度時間的な変化が予想されるので、この解析がいくらかは有用と信じている。
# scvelo 18
scv.pl.velocity_embedding_stream(concat_velo,
                                 basis='umap',
                                 color=['louvain_1.0', 'batch'],
                                 arrow_style = '-|>',
                                 max_length = 5,
                                 min_mass = 0,
                                 size = 30,
                                 dpi = 400)
上述は、クラスター全体におけるRNA velocityを計算し、それを可視化したものであるが、当然ながらクラスター毎に細胞が全く異なるので、似た細胞毎にRNA velocityを計算し、その中のサブクラスターがどのように時間的に変化しているのかを見るのは有りである。なのでここでは、ヘルパーT細胞(Th)と細胞障害性T細胞(Tc)に分けて、RNA Velocityを計算して可視化してみる。
まずはThから。最初に、scanpyでクラスタリングしたanndataとvelocytoの出力を結合させる。
# scvelo 19
Th_velo = scv.utils.merge(adata = Th,
ldata = all_velo)そしたら、これまで行ってきた通り、フィルタリング、ライブラリサイズで正規化、log1pに変換、統計の計算、RNA velocityの解析を行い、可視化する。
# scvelo 20
scv.pl.proportions(Th_velo)
scv.pp.filter_genes(Th_velo, min_shared_counts=1)
scv.pp.normalize_per_cell(Th_velo)
sc.pp.filter_genes_dispersion(Th_velo, n_top_genes=3000)
sc.pp.log1p(Th_velo)
# scv.pp.filter_and_normalize(Th_velo) #, n_top_genes=3000, , min_shared_counts=20
scv.pp.moments(Th_velo, n_pcs=20, n_neighbors=15)
scv.tl.velocity(Th_velo)
scv.tl.velocity_graph(Th_velo)
scv.pl.velocity_embedding_stream(Th_velo,
                                 basis='umap',
                                 color='louvain_1.0',
                                 arrow_style = '-|>',
                                 max_length = 5,
                                 min_mass = 0,
                                 size = 30,
                                 dpi = 400, save = 'Th_Treg_velo_stream_umap_louvain_1.0_Th_Treg.png')

scv.pl.velocity_embedding_stream(Th_velo,
                                 basis='umap',
                                 color=['batch', 'louvain_1.0', 'louvain_1.0_2'],
                                 arrow_style = '-|>',
                                 max_length = 5,
                                 min_mass = 0,
                                 size = 30,
                                 dpi = 400)

scv.pl.velocity_graph(Th_velo, threshold=.1, color='louvain_1.0')

# NEED TO DISIDE WHICH CELLS SHOULD BE USED FOR PLOT!!! (starting_cell)
x, y = scv.utils.get_cell_transitions(Th_velo, basis='umap', starting_cell=11, n_steps= 100, random_state = 2000)
ax = scv.pl.velocity_graph(Th_velo, color='lightgrey', edge_width=0.05, show=False)
ax = scv.pl.scatter(Th_velo, x=x, y=y, s=120, c='ascending', cmap='gnuplot', ax=ax)

# # NEED TO DECIDE WHICH CELLS SHOULD BE USED FOR PLOT!!! (starting_cell)
# x, y = scv.utils.get_cell_transitions(Th_Treg_velo, basis='umap', starting_cell=0, n_steps= 100, random_state = 2000)
# ax = scv.pl.velocity_graph(Th_Treg_velo, color='lightgrey', edge_width=0.05, show=False)
# ax = scv.pl.scatter(Th_Treg_velo, x=x, y=y, s=120, c='ascending', cmap='gnuplot', ax=ax)

scv.tl.velocity_pseudotime(Th_velo)
scv.pl.scatter(Th_velo, color='velocity_pseudotime', cmap = 'gnuplot')

Th_velo.uns['neighbors']['distances'] = Th_velo.obsp['distances']
Th_velo.uns['neighbors']['connectivities'] = Th_velo.obsp['connectivities']

scv.tl.paga(Th_velo, groups='louvain_1.0')


df = scv.get_df(Th_velo, 'paga/transitions_confidence', precision=2).T
df.style.background_gradient(cmap='Blues').format('{:.2g}')


scv.pl.paga(Th_velo, basis='umap', size=50, alpha=0.1, min_edge_width=2, node_size_scale=1.5, dpi= 400, save='Th_Treg_velo_paga_umap_louvain_1.0.png')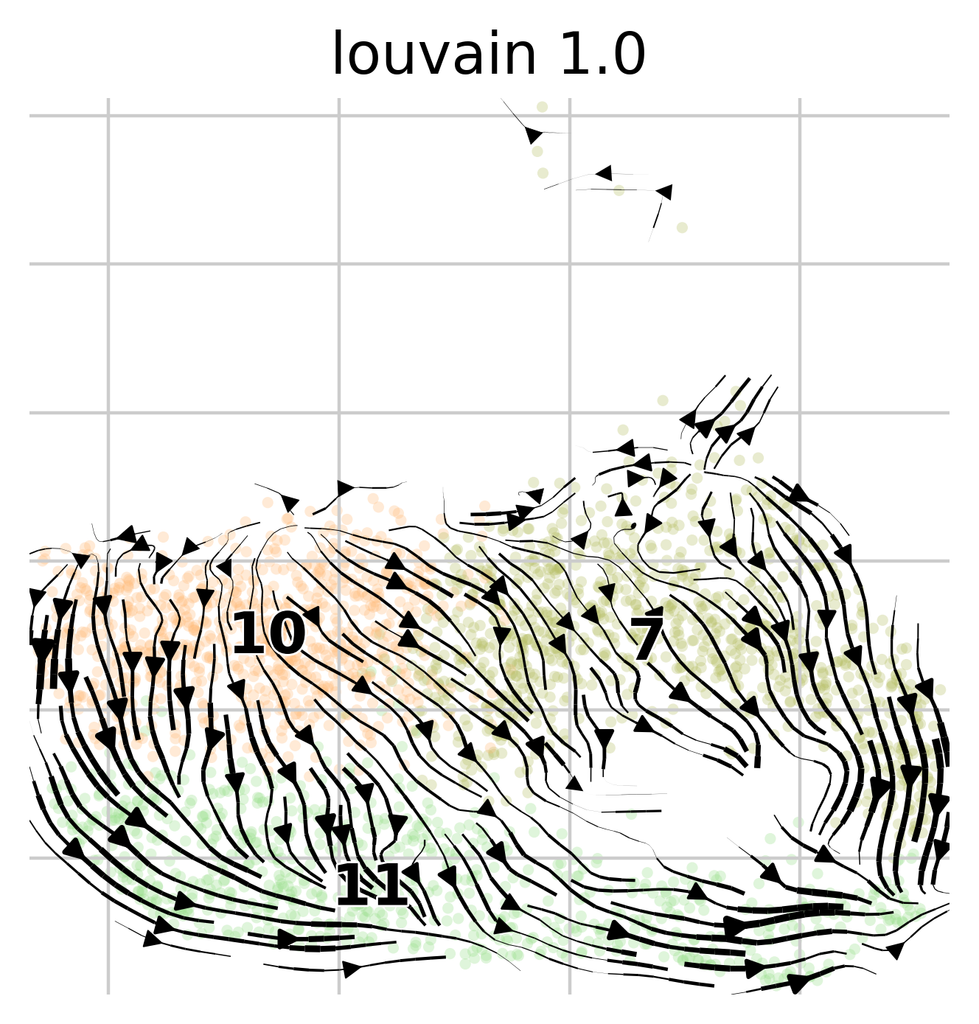
Tcでも同様。まずはScanpyのクラスタリングの結果とvelocytoの結果を結合する。
# scvelo 21
Tc_velo = scv.utils.merge(adata = Tc,
ldata = all_velo)フィルタリング、ライブラリサイズで正規化、log1pに変換、統計の計算、RNA velocityの解析、可視化。
# scvelo 22
scv.pl.proportions(Tc_velo)
scv.pp.filter_genes(Tc_velo, min_shared_counts=1)
scv.pp.normalize_per_cell(Tc_velo)
sc.pp.filter_genes_dispersion(Tc_velo, n_top_genes=3000)
sc.pp.log1p(Tc_velo)
# scv.pp.filter_and_normalize(Tc_velo) #, n_top_genes=3000, , min_shared_counts=20
scv.pp.moments(Tc_velo, n_pcs=20, n_neighbors=15)
scv.tl.velocity(Tc_velo)
scv.tl.velocity_graph(Tc_velo)
scv.pl.velocity_embedding_stream(Tc_velo,
                                 basis='umap',
                                 color='louvain_1.0',
                                 arrow_style = '-|>',
                                 max_length = 5,
                                 min_mass = 0,
                                 size = 30,
                                 dpi = 400, save = 'Tc_velo_stream_umap_louvain_1.0_Tc.png')

scv.pl.velocity_embedding_stream(Tc_velo,
                                 basis='umap',
                                 color=['batch', 'louvain_1.0', 'louvain_1.0_2'],
                                 arrow_style = '-|>',
                                 max_length = 5,
                                 min_mass = 0,
                                 size = 30,
                                 dpi = 400)

scv.pl.velocity_graph(Tc_velo, threshold=.1, color='louvain_1.0')

# NEED TO DISIDE WHICH CELLS SHOULD BE USED FOR PLOT!!! (starting_cell)
x, y = scv.utils.get_cell_transitions(Tc_velo, basis='umap', starting_cell=3, n_steps= 100, random_state = 2000)
ax = scv.pl.velocity_graph(Tc_velo, color='lightgrey', edge_width=0.05, show=False)
ax = scv.pl.scatter(Tc_velo, x=x, y=y, s=120, c='ascending', cmap='gnuplot', ax=ax)

# # NEED TO DECIDE WHICH CELLS SHOULD BE USED FOR PLOT!!! (starting_cell)
# x, y = scv.utils.get_cell_transitions(Tc_velo, basis='umap', starting_cell=0, n_steps= 100, random_state = 2000)
# ax = scv.pl.velocity_graph(Tc_velo, color='lightgrey', edge_width=0.05, show=False)
# ax = scv.pl.scatter(Tc_velo, x=x, y=y, s=120, c='ascending', cmap='gnuplot', ax=ax)

scv.tl.velocity_pseudotime(Tc_velo)
scv.pl.scatter(Tc_velo, color='velocity_pseudotime', cmap = 'gnuplot')

Tc_velo.uns['neighbors']['distances'] = Tc_velo.obsp['distances']
Tc_velo.uns['neighbors']['connectivities'] = Tc_velo.obsp['connectivities']

scv.tl.paga(Tc_velo, groups='louvain_1.0')


df = scv.get_df(Tc_velo, 'paga/transitions_confidence', precision=2).T
df.style.background_gradient(cmap='Blues').format('{:.2g}')


scv.pl.paga(Tc_velo, basis='umap', size=50, alpha=0.1, min_edge_width=2, node_size_scale=1.5, dpi= 400, save='Tc_velo_paga_umap_louvain_1.0.png')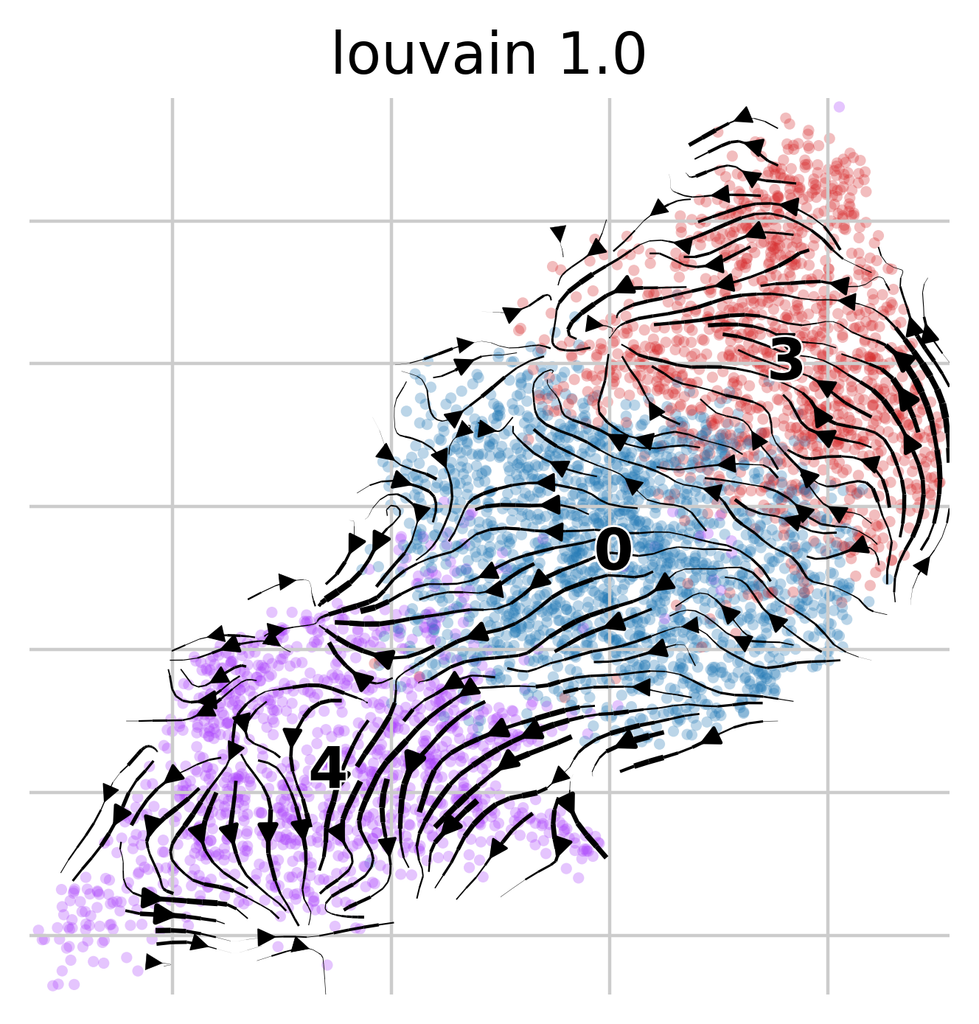
StreamとStream2によるTrajectory inference(疑似系譜解析)
続いて、STREAMを使って擬似系譜解析を行う。STREAMの特徴はstream plotと、正規化の時のフィッティングがすごく良いことだと思う。また、何かの学会かセミナーで「疑似系譜解析ではSTREAMが流行っているよ」という話を聞いたことがあり、それで使用している。
しかしながら、このパッケージはけっこう古く、さらに、環境構築が難しいと思う。数年前にこれをインストールするときに、かなり苦労した経験がある。特により新しいバージョンのscanpyは他の依存関係のあるパッケージとぶつかるし、networkxとfa2もバージョンを選ぶ。環境構築が難しい一方で、解析は非常に簡単である。これは他のシングルセルRNAシークエンス解析用のパッケージでもそうである。
この手の解析はクラスター毎に発現量の推移を見ていったりする。したがって、疑似系譜解析が有効なのは、それらが何かしらの群(細胞や組織)にクラスターがはっきり分かれる場合である。例えば、時間的に細胞の状態が形質がはっきりと変わる場合であり、細胞の分化が典型的な例と言える。UMAPで可視化したときに、クラスターがはっきりと分岐していないような場合は、ほとんど意味がない。もちろん解析自体は問題なく出来るが、おそらくそれを使って何か結論を得ることは難しいと思う。上述のRNA velocity解析もその感じがするが、RNA velocityはここの細胞に着目するので、まだマシという感じがする。この解析でヘルパーT細胞(Th)と細胞障害性T細胞(Tc)に着目したところで、そのクラスターははっきりした分岐がない。だから、この解析の有用性は限定的と言える。言うて、その方法は覚えておきたいので、ここではそんなことは気にせずに解析したいと思う。
Stream
以下がSTREAMで使用するパッケージである。環境に依ってはこれまで使用してきたscanpyとこの環境で使用するscanpyのバージョンがずいぶん違う場合がある。その場合、特に正規化の部分や、もしかしたらKNN、UMAPの部分で計算結果が異なる可能性もあるので、解析には注意する必要がある。
import numpy as np
import pandas as pd
import matplotlib as mpl
import anndata
# # import scanpy as sc# var 1.9.0, networkx==2.1 requies scanpy==1.9.0 # Following codes do not require scanpy.
# import diopy # It does not require diopy, anndata is good enough for exporting data.
from scipy.sparse import csr_matrix
import seaborn as sns
import networkx as nx
import stream as st

# sc.settings.verbosity = 4
# sc.logging.print_header()
# sc.settings.set_figure_params(dpi=80, facecolor="white")

st.set_figure_params(dpi=80,style='white',figsize=[4,3],
                     rc={'image.cmap': 'viridis'})

print("version of STREAM; ", st.__version__)
全部の細胞を使って疑似系譜解析を行うのはナンセンスなので、この解析ではその中のヘルパーT細胞(Th)と細胞障害性T細胞(Tc)を解析する。
まず、scanpyの最後の方に出力した、anndataオブジェクトThとTh_hvgs_wo_MT_RIBOをread_h5ad()で読み込み、var_names_make_unique()とobs_names_make_unique()を使ってそれらの遺伝子名と細胞名から重複を除いておく。
# stream 1

Th = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th.h5ad')
Th_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO.h5ad')
#
Th.var_names_make_unique()
Th.obs_names_make_unique()
Th_hvgs_wo_MT_RIBO.var_names_make_unique()
Th_hvgs_wo_MT_RIBO.obs_names_make_unique()STREAMでは、解析に使用する一時ディレクトリを保存する必要がある(知らんけど、インストラクションに載ってた)ので、そのディレクトリを用意する。VScodeだと、!mkdirと書けばシェルでコードを実行できる。
# stream 2
!mkdir "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/working_stream/Th"
作成したディレクトリ/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/working_stream/Thを、データフレームunsの一つとして入れておく。
# stream 3

Th.uns['workdir'] = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/working_stream/Th"
解析対象となるデータをanndataオブジェクトから抽出する。ここでは、スパースマトリックスとして保持されている正規化前のオリジナルのカウント値をnumpy.ndarrayに変換してanndataオブジェクトのThに入れておく。
# stream 4
Th.X = Th.layers['raw'].toarray()
それを正規化、log1pに変換する。これらはSTREAMのAPIとして用意されている。
# stream 5

st.normalize(Th, method='lib_size')
st.log_transform(Th)
st.remove_mt_genes(Th)続いて、ばらつきの大きな遺伝子を抽出してくる。以前から、「これは綺麗にフィットするなぁ」とか思っていた。調べてみると、LOESS(Locally Estimated Scatteringplot Smoothing)という計算方法を使っているらしい。データ全体ではなく、部分的な回帰を繰り返してフィッティングする方法らしい。細かい計算は違うが、いわゆるスプラインみたいな(繰り返すが、計算方法は異なるようだ。イメージとしてってだけ。)ことを行っていく。通りで綺麗にフィットするわけだ。
考えて見れば、発現の変動が大きい遺伝子を見つけるためには良い方法な気がする。
# stream 6
st.select_variable_genes(Th, loess_frac=0.1, percentile=95)
使用するクラスターをpandasのDataFrame()でデータフレームに変換し、改めてanndataオブジェクトThにそれぞれ入れ直す。
# stream 7
# Th
Th.obs['louvain_1.0'] = pd.DataFrame(Th.obs['louvain_1.0'])
Th.obs['louvain_1.0_2'] = pd.DataFrame(Th.obs['louvain_1.0_2'])
Th.obs['celltype_2'] = pd.DataFrame(Th.obs['celltype_2'])
Th.obs['batch'] = pd.DataFrame(Th.obs['batch'])
次元削減を行う。STREAMでは、MLLE(Modified Locally Linear Embedding)(method = ‘mlle’)やSpectral Embedding(method = ‘se’)という方法で次元削減するらしい。ここはデフォルトのSpectral Embeddingを使用する。出力を見た感じでは、まずPCAで次元削減、KNNの算出、それを使ってクラスタリング、という計算手順のようだ。そういうことなので、KNNの計算に使用するデータの数(引数n_neighbors)はScanpyのときと同じにする。
次にseed_elastic_principal_graph()でグラフの初期値を計算するらしい。次元削減で得られたクラスターを使ってその中心を計算(クラスター間の距離が最短になるもの同士を計算する)し、そこからその点を繋いでみて、その値を次の計算の初期値にする。その値を使って、Elastic Principal Graphを計算する(イキってると思われるから説明するのやめる)。
# stream 8
st.dimension_reduction(Th,
                       method='se',
                       feature='var_genes',
                       n_components=2,
                       n_neighbors=15,
                       n_jobs=4)
st.seed_elastic_principal_graph(Th, n_clusters=2)
st.elastic_principal_graph(Th, epg_alpha=0.01,epg_mu=0.05,epg_lambda=0.05)次元削減の結果をプロットして確認する。
# stream 9

st.plot_dimension_reduction(Th, color=['louvain_1.0_2'], n_components=2, show_graph=True, show_text=True)ElPiGraphで求めた点をプロットする。
# stream 10
st.plot_branches(Th, show_text=True)ElPiGraphで求めた点を木(tree)で示す。elastic_principal_graph()で求めた点を、直線でつなぐ。その距離は、当然保たれているらしい。
# stream 11
st.plot_flat_tree(Th, color=['S0_pseudotime'], dist_scale=0.5, show_graph=True, show_text=True)Stream Plotを出力する。これまでの他の解析(細胞のタイピング)で、どのクラスターが出発点(引数root)にするべきかを判断して、そこを出発点にするのが良いだろう。ここでは点S0を出発点とする。pseudotimeは、ブランチの長さになる。つまり、そのクラスターが似ているほど近くなる。
# stream 12
st.plot_stream_sc(Th,root='S0',color=['louvain_1.0', 'louvain_1.0_2','S0_pseudotime', 'celltype_2', 'batch'],dist_scale=0.3,show_graph=True,show_text=True)ここで、着目するリーフ(行き止まりのノード)で統計的優位に発現量の異なる遺伝子を検出する。論文によれば、各遺伝子の発現量のZスコアを計算し、それをクラスカルウォリス検定する。多重性の補正はConover’s testを使うらしい。marker_listに、調べる遺伝子のリストを入れることが出来る。デフォルトでは全遺伝子が設定される。ここは目的に依って設定した方が良い。全遺伝子で解析する意味がない可能性もある。そもそも、マーカー遺伝子を使ってPsudotimeが計算されているので、まずはマーカー遺伝子で検定すべきと思う。そちらの方がクラスター間で発現量の差が大きい遺伝子を拾ってくることが出来るだろうし、全遺伝子を使った場合、とうぜんながら偽陽性も増えるように思う。もちろん、全遺伝子を使って差を検定し、有意差のある遺伝子を使ってエンリッチメント解析をして、どんな分子シグナルが異なるか、ということを解析するのも有りだと思う。
# stream 13
st.detect_leaf_markers(Th,
                       marker_list=Th.uns['var_genes'],
                       cutoff_zscore=1.0,
                       cutoff_pvalue=0.05,
                       root='S0',n_jobs=4)
Th.uns['leaf_markers_all']Pseudotimeに沿って変化していく遺伝子を拾う。最初にPseudotime間で発現量が20から80%で変化する遺伝子を拾ってきて、その間のブランチでの発現量がPsudotimeと相関する遺伝子を更に拾う。相関には発現量の比の対数を、相関にはスピアマンの相関係数を使うらしい。拾ってくる遺伝子発現量のしきい値を、それぞれ引数cutoff_spearmanとcutoff_logfcで指定する。plot_transition_markers()でその計算結果を表示する。
# stream 14
st.detect_transition_markers(Th,
                             marker_list=Th.uns['var_genes'],
                             cutoff_spearman=0.1,
                             cutoff_logfc=0.25,
                             root='S0',
                             n_jobs=4)
st.plot_transition_markers(Th,
fig_size=(10,5))detect_leaf_markers()では、リーフ間での遺伝子は発現量を検定したが、このdetect_de_markers()は、ブランチ(例えばS0からS1まで、ということと思う)間の発現量を検定する。検定方法はdetect_leaf_markers()と同様、Zスコアのクラスカルウォリス検定にConover’s testで多重性を補正する。引数rootに最初のブランチを指定するが、ここでは基本的に総当りの検定結果が出力される。
# stream 15
st.detect_de_markers(Th,
                    marker_list=Th.uns['var_genes'],
                     cutoff_zscore=1,
                     cutoff_logfc=0.25,
                     root='S0',
                     n_jobs=4)
# marker_list=Th.uns['var_genes'], # it can be used instead of use_precomputed=False, to calculate DE just only for variable genes.

# use_precomputed=False, # Use it instead of marker_list=Th.uns['var_genes'], if you calculate DE using all genes
どんな列名でdetect_de_markers()が入っているか確認する。使っているanndataオブジェクト(ここではTh)のunsにリストde_markers_greaterとして出力される。
# stream 16
list(Th.uns['de_markers_greater'])使っているanndataオブジェクト(ここではTh)のunsのリストde_markers_greaterから、各ブランチ間の結果を拾ってきて、データフレームとして保存する。
# stream 17
# Extract data
# # ('S0', 'S1'), ('S1', 'S3')
Th_greater_S0_S1_vs_S1_S3 = Th.uns['de_markers_greater'][(('S0', 'S1'), ('S1', 'S3'))][
    (Th.uns['de_markers_greater'][(('S0', 'S1'), ('S1', 'S3'))]["qval"] < 0.05)
]

Th_less_S0_S1_vs_S1_S3 = Th.uns['de_markers_less'][(('S0', 'S1'), ('S1', 'S3'))][
    (Th.uns['de_markers_less'][(('S0', 'S1'), ('S1', 'S3'))]["qval"] < 0.05)
]

# # ('S0', 'S1'), ('S1', 'S2')
Th_greater_S0_S1_vs_S1_S2 = Th.uns['de_markers_greater'][(('S0', 'S1'), ('S1', 'S2'))][
    (Th.uns['de_markers_greater'][(('S0', 'S1'), ('S1', 'S2'))]["qval"] < 0.05)
]

Th_less_S0_S1_vs_S1_S2 = Th.uns['de_markers_less'][(('S0', 'S1'), ('S1', 'S2'))][
    (Th.uns['de_markers_less'][(('S0', 'S1'), ('S1', 'S2'))]["qval"] < 0.05)
]

# # ('S1', 'S3'), ('S1', 'S2')
Th_greater_S1_S2_vs_S1_S3 = Th.uns['de_markers_greater'][(('S1', 'S3'), ('S1', 'S2'))][
    (Th.uns['de_markers_greater'][(('S1', 'S3'), ('S1', 'S2'))]["qval"] < 0.05)
]

Th_less_S1_S3_vs_S1_S3 = Th.uns['de_markers_less'][(('S1', 'S3'), ('S1', 'S2'))][
    (Th.uns['de_markers_less'][(('S1', 'S3'), ('S1', 'S2'))]["qval"] < 0.05)
]
detect_de_markers()の出力は、STREAMのplot_de_markers()で可視化できるはずなのだが、なぜかそれが動かなかった。どうしようということで、chatGPTと相談しながら、同じようなものをmatplotlibで作成した。やっていることは簡単で、グラフを上下の2パネルにして、有意に発現が高かった遺伝子、低かった遺伝子の棒グラフをそれぞれリストaxに入れ、あとはグラフのタイトルや軸ラベルを付けたり、棒グラフの間隔を調整したりするだけである。
まずはブランチS0 S1とブランチS1 S3間から。
# stream 18
fig, ax = mpl.pyplot.subplots(2, 1, figsize=(10, 10))

ax[0].bar(
    Th_greater_S0_S1_vs_S1_S3.sort_values("z_score", ascending=False).head(50).index,
    Th_greater_S0_S1_vs_S1_S3.sort_values("z_score", ascending=False).head(50)["z_score"],
    color="orange"
)
ax[0].set_title("DE genes: S0-S1 vs S1-S2")
ax[0].set_ylabel("Z-score")
ax[0].tick_params(axis="x", rotation=90)

ax[1].bar(
    Th_less_S0_S1_vs_S1_S3.sort_values("z_score", ascending=True).head(50).index,
    Th_less_S0_S1_vs_S1_S3.sort_values("z_score", ascending=True).head(50)["z_score"],
    color="green"
)
ax[1].set_title("DE genes: S0-S1 vs S1-S3")
ax[1].set_ylabel("Z-score")
ax[1].tick_params(axis="x", rotation=90)

# mpl.pyplot.tight_layout()
mpl.pyplot.subplots_adjust(hspace=0.8)
mpl.pyplot.show()ブランチS0 S1とブランチS1 S2間。
# stream 19
fig, ax = mpl.pyplot.subplots(2, 1, figsize=(10, 10))

ax[0].bar(
    Th_greater_S0_S1_vs_S1_S2.sort_values("z_score", ascending=False).head(50).index,
    Th_greater_S0_S1_vs_S1_S2.sort_values("z_score", ascending=False).head(50)["z_score"],
    color="orange"
)
ax[0].set_title("DE genes: S0-S1 vs S1-S3")
ax[0].set_ylabel("Z-score")
ax[0].tick_params(axis="x", rotation=90)

ax[1].bar(
    Th_less_S0_S1_vs_S1_S2.sort_values("z_score", ascending=True).head(50).index,
    Th_less_S0_S1_vs_S1_S2.sort_values("z_score", ascending=True).head(50)["z_score"],
    color="green"
)
ax[1].set_title("DE genes: S0-S1 vs S1-S2")
ax[1].set_ylabel("Z-score")
ax[1].tick_params(axis="x", rotation=90)

# mpl.pyplot.tight_layout()
mpl.pyplot.subplots_adjust(hspace=0.8)
mpl.pyplot.show()ブランチS1 S2とブランチS1 S3間。これで、一通り終了。
# stream 20
fig, ax = mpl.pyplot.subplots(2, 1, figsize=(10, 10))

ax[0].bar(
    Th_greater_S1_S2_vs_S1_S3.sort_values("z_score", ascending=False).head(50).index,
    Th_greater_S1_S2_vs_S1_S3.sort_values("z_score", ascending=False).head(50)["z_score"],
    color="orange"
)
ax[0].set_title("DE genes: S1-S3 vs S1-S2")
ax[0].set_ylabel("Z-score")
ax[0].tick_params(axis="x", rotation=90)

ax[1].bar(
    Th_less_S1_S2_vs_S1_S3.sort_values("z_score", ascending=True).head(50).index,
    Th_less_S1_S2_vs_S1_S3.sort_values("z_score", ascending=True).head(50)["z_score"],
    color="green"
)
ax[1].set_title("DE genes: S1-S3 vs S1-S2")
ax[1].set_ylabel("Z-score")
ax[1].tick_params(axis="x", rotation=90)

# mpl.pyplot.tight_layout()
mpl.pyplot.subplots_adjust(hspace=0.8)
mpl.pyplot.show()続いて、細胞障害性T細胞(Tc)のクラスターを同様に解析していく。
まず、scanpyで出力したh5adをread_h5ad()で読み込んでanndataオブジェクトを各種作り、遺伝子名varsと細胞名(obs)から重複を除去(というか、重複した例に番号を付けて重複を解消する。)
# stream 21
Tc = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc.h5ad')
Tc_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO.h5ad')
#
Tc.var_names_make_unique()
Tc.obs_names_make_unique()
Tc_hvgs_wo_MT_RIBO.var_names_make_unique()
Tc_hvgs_wo_MT_RIBO.obs_names_make_unique()
作業ディレクトリをbashで作成する。
# stream 22
!mkdir "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/working_stream/Tc"作成した作業ディレクトリへのパスをunsに設定する。
# stream 23
Tc.uns['workdir'] = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/working_stream/Tc"
カウントマトリックスを設定する。
# stream 24
Tc.X = Tc.layers['raw'].toarray()
正規化、log1p変換、ミトコンドリア遺伝子の除去、クラスタ毎に発現量の変動が多い遺伝子を抽出する。
# stream 25
st.normalize(Tc, method='lib_size')
st.log_transform(Tc)
st.remove_mt_genes(Tc)
st.select_variable_genes(Tc, loess_frac=0.1, percentile=95)scanpyでのクラスタリング、細胞のタイピング結果をコピーする。
# stream 26
# Tc
Tc.obs['louvain_1.0'] = pd.DataFrame(Tc.obs['louvain_1.0'])
Tc.obs['louvain_1.0_2'] = pd.DataFrame(Tc.obs['louvain_1.0_2'])
Tc.obs['celltype_2'] = pd.DataFrame(Tc.obs['celltype_2'])
Tc.obs['batch'] = pd.DataFrame(Tc.obs['batch'])次元削減、クラスタ間の距離でツリーを計算。
# stream 27
st.dimension_reduction(Tc,
                       method='se',
                       feature='var_genes',
                       n_components=2,
                       n_neighbors=15,
                       n_jobs=4)
st.seed_elastic_principal_graph(Tc, n_clusters=2)
st.elastic_principal_graph(Tc, epg_alpha=0.01,epg_mu=0.05,epg_lambda=0.05)クラスタリングの結果とツリーを確認。
# stream 28
st.plot_dimension_reduction(Tc, color=['louvain_1.0'], n_components=2, show_graph=True, show_text=True)
st.plot_dimension_reduction(Tc, color=['louvain_1.0_2'], n_components=2, show_graph=True, show_text=True)
st.plot_branches(Tc, show_text=True)ツリーとストリームプロットを確認。
# stream 29
st.plot_flat_tree(Tc, color=['S3_pseudotime'], dist_scale=0.5, show_graph=True, show_text=True)
st.plot_stream_sc(Tc,root='S3',color=['louvain_1.0', 'louvain_1.0_2','S0_pseudotime', 'celltype_2', 'batch'],dist_scale=0.3,show_graph=True,show_text=True)リーフ(ブランチの行き止まりのノード)間の遺伝子発現量を検定。
# stream 30
st.detect_leaf_markers(Tc,
                       marker_list=Tc.uns['var_genes'],
                       cutoff_zscore=1.0,
                       cutoff_pvalue=0.05,
                       root='S3',n_jobs=4)
Tc.uns['leaf_markers_all']
着目するブランチにおけるpseudotimeと相関して発現が変化する遺伝子を抽出する。
# stream 31
st.detect_transition_markers(Tc,
                             marker_list=Tc.uns['var_genes'],
                             cutoff_spearman=0.1,
                             cutoff_logfc=0.25,
                             root='S3',
                             n_jobs=4)

st.plot_transition_markers(Tc,
fig_size=(10,5))ブランチ間の遺伝子発現量を検定する。
# stream 32
st.detect_de_markers(Tc,
                    marker_list=Tc.uns['var_genes'],
                    cutoff_zscore=1,
                    cutoff_logfc=0.25,
                    root='S3',
                    n_jobs=4)

# marker_list=Th_Treg.uns['var_genes'], # it can be used instead of use_precomputed=False, to calculate DE just only for variable genes.

# use_precomputed=False, # Use it instead of marker_list=Th_Treg.uns['var_genes'], if you calculate DE using all genes どんなブランチがあるのかを確認。
# stream 33
list(Tc.uns['de_markers_greater'])各ブランチで発現量に統計的有意差のある遺伝子を抽出し、データフレームとして保持する。
# stream 34
# Extract data
# # (('S3', 'S1'), ('S1', 'S2'))
Tc_greater_S3_S1_vs_S1_S2 = Tc.uns['de_markers_greater'][(('S3', 'S1'), ('S1', 'S2'))][
    (Tc.uns['de_markers_greater'][(('S3', 'S1'), ('S1', 'S2'))]["qval"] < 0.05)
]

Tc_less_S3_S1_vs_S1_S2 = Tc.uns['de_markers_less'][(('S3', 'S1'), ('S1', 'S2'))][
    (Tc.uns['de_markers_less'][(('S3', 'S1'), ('S1', 'S2'))]["qval"] < 0.05)
]

# # (('S3', 'S1'), ('S1', 'S0'))
Tc_greater_S3_S1_vs_S1_S0 = Tc.uns['de_markers_greater'][(('S3', 'S1'), ('S1', 'S0'))][
    (Tc.uns['de_markers_greater'][(('S3', 'S1'), ('S1', 'S0'))]["qval"] < 0.05)
]

Tc_less_S3_S1_vs_S1_S0  = Tc.uns['de_markers_less'][(('S3', 'S1'), ('S1', 'S0'))][
    (Tc.uns['de_markers_less'][(('S3', 'S1'), ('S1', 'S0'))]["qval"] < 0.05)
]

# #  (('S1', 'S2'), ('S1', 'S0'))
Tc_greater_S1_S2_vs_S1_S0 = Tc.uns['de_markers_greater'][(('S1', 'S2'), ('S1', 'S0'))][
    (Tc.uns['de_markers_greater'][(('S1', 'S2'), ('S1', 'S0'))]["qval"] < 0.05)
]

Tc_less_S1_S2_vs_S1_S0 = Tc.uns['de_markers_less'][(('S1', 'S2'), ('S1', 'S0'))][
    (Tc.uns['de_markers_less'][(('S1', 'S2'), ('S1', 'S0'))]["qval"] < 0.05)
]matplotlibで可視化。
# stream 35
# 1
fig, ax = mpl.pyplot.subplots(2, 1, figsize=(10, 10))


ax[0].bar(
    Tc_greater_S3_S1_vs_S1_S2.sort_values("z_score", ascending=False).head(50).index,
    Tc_greater_S3_S1_vs_S1_S2.sort_values("z_score", ascending=False).head(50)["z_score"],
    color="orange"
)
ax[0].set_title("DE genes: S3-S1 vs S1-S2")
ax[0].set_ylabel("Z-score")
ax[0].tick_params(axis="x", rotation=90)

ax[1].bar(
    Tc_less_S3_S1_vs_S1_S2.sort_values("z_score", ascending=True).head(50).index,
    Tc_less_S3_S1_vs_S1_S2.sort_values("z_score", ascending=True).head(50)["z_score"],
    color="green"
)
ax[1].set_title("DE genes: S3-S1 vs S1-S2")
ax[1].set_ylabel("Z-score")
ax[1].tick_params(axis="x", rotation=90)

# mpl.pyplot.tight_layout()
mpl.pyplot.subplots_adjust(hspace=0.8)
mpl.pyplot.show()


# 2
fig, ax = mpl.pyplot.subplots(2, 1, figsize=(10, 10))

ax[0].bar(
    Tc_greater_S3_S1_vs_S1_S0.sort_values("z_score", ascending=False).head(50).index,
    Tc_greater_S3_S1_vs_S1_S0.sort_values("z_score", ascending=False).head(50)["z_score"],
    color="orange"
)
ax[0].set_title("DE genes: S3-S1 vs S1-S0")
ax[0].set_ylabel("Z-score")
ax[0].tick_params(axis="x", rotation=90)

ax[1].bar(
    Tc_less_S3_S1_vs_S1_S0.sort_values("z_score", ascending=True).head(50).index,
    Tc_less_S3_S1_vs_S1_S0.sort_values("z_score", ascending=True).head(50)["z_score"],
    color="green"
)

ax[1].set_title("DE genes: S3-S1 vs S1-S0")
ax[1].set_ylabel("Z-score")
ax[1].tick_params(axis="x", rotation=90)

# mpl.pyplot.tight_layout()
mpl.pyplot.subplots_adjust(hspace=0.8)
mpl.pyplot.show()


# 3

fig, ax = mpl.pyplot.subplots(2, 1, figsize=(10, 10))

ax[0].bar(
    Tc_greater_S1_S2_vs_S1_S0.sort_values("z_score", ascending=False).head(50).index,
    Tc_greater_S1_S2_vs_S1_S0.sort_values("z_score", ascending=False).head(50)["z_score"],
    color="orange"
)
ax[0].set_title("DE genes: S1-S2 vs S1-S0")
ax[0].set_ylabel("Z-score")
ax[0].tick_params(axis="x", rotation=90)

ax[1].bar(
    Tc_less_S1_S2_vs_S1_S0.sort_values("z_score", ascending=True).head(50).index,
    Tc_less_S1_S2_vs_S1_S0.sort_values("z_score", ascending=True).head(50)["z_score"],
    color="green"
)
ax[1].set_title("DE genes: S1-S2 vs S1-S0")
ax[1].set_ylabel("Z-score")
ax[1].tick_params(axis="x", rotation=90)

# mpl.pyplot.tight_layout()
mpl.pyplot.subplots_adjust(hspace=0.8)
mpl.pyplot.show()
Stream2
Streamはもうけっこう古いパッケージで、解析環境に依っては依存性問題がそのうち出てくるんだろうなってことが、インストールしていて思うところである。そして先日にUbuntuをぶっ壊してから、改めてシングルセルRNA解析シークエンス用のパッケージを入れているときに新しいバージョンが出ていたので、それも使ってみることにした。言うて、これがリリースされているのは2024年のようなので、そんなに新しいかと言われれば、そうでもない。
STREAM2は、マルチオームに対応しており、Feature Detection(マーカー遺伝子の抽出)のための計算もより”flexble”になったらしい(チュートリアル読んだけど、これがどういう意味かわからんかった)。
実際使ってみると、正直、STREAMの方が良い用に思う。一番重要な点であるPeudotimeに沿って発現が変化する遺伝子を抽出する機能や、ブランチ間の遺伝子発現量の検定を行う機能が無い。特徴としては、より複雑なTrajectoryを算出できるようになった、ということのようだ。というか、Trajectoryだけ求めて終わる研究や解析はあるのだろうか。それも大事だが、発現量の異なる遺伝子や遺伝子の擬似的な経時的発現量の変化の方が重要なのではないか?それを他に譲るとしたら、それこそ他のパッケージで良いのでは?と思ってしまう。それ以外は、言うほどSTREAMと変わらなかった。
でもせっかく環境構築したことだし、これもやってみようと思う。まずはパッケージを読み込む。STREAMと同様に作業領域を設定するが、それはここで定義しまう。
STREAMと違って、ここ(https://stream-bio.readthedocs.io/en/latest/index.html)に関数の説明がある。しかし、このマニュアルにしても、ちゃんと説明していないので、引数の確認くらいには使える。
import numpy as np
import pandas as pd
import matplotlib as mpl
import anndata
import scanpy as sc# var 1.9.0, networkx==2.1 requies scanpy==1.9.0
# import diopy
from scipy.sparse import csr_matrix
import seaborn as sns
import networkx as nx
import stream2 as st2


workdir = '/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/temp_stream2'
st2.settings.set_workdir(workdir)

st2.settings.set_figure_params(dpi=80,
                              style='white',
                              fig_size=[5,5],
rc={'image.cmap': 'viridis'})対象となるh5adをread_h5ad()で読み込んで、anndataオブジェクトを作成する。
# stream2 1
# adata = sc.datasets.paul15()

Th = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd.h5ad')
Th_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO.h5ad')読み込んできたanndataオブジェクトのUMAPを確認する。
# stream2 2
sc.pl.umap(Th, color=["louvain_1.0", "louvain_1.0_2", "celltype_2"], layer="normalize_pearson", legend_loc="on data")
print("----------------------Naive T--------------------------")
print("----------------------Naive T--------------------------")
print("----------------------IL2RA, CD44, CD69 are lacking in Naive T--------------------------")
Naive_T = ["SELL", "CCR7", "IL7R", "IL2RG", "IL2RA", "CD44", "CD69", "CD27", "CD28"]
sc.pl.umap(Th, color=Naive_T, layer="normalize_pearson", ncols=4, save = "_Naive_T_Th_stream2.png")
カウント数の少ない遺伝子を除く。これはすでにscanpyで行っているので、ここで改めてやる必要はない。強いてやるなら、カウントが1より低いものは除く(つまり、このThオブジェクトでは遺伝子数は変わらないはず。)
# stream2 3
st2.pp.filter_genes(Th, min_n_cells=1)QCメトリックスを算出する。
# stream2 4
st2.pp.cal_qc_rna(Th)正規化とlog1p変換。
# stream2 5
st2.pp.normalize(Th,method='lib_size')
st2.pp.log_transform(Th)発現量にばらつきの多い遺伝子を抽出し、それらの発現と分散をプロットしてみる。
# stream2 6
st2.pp.select_variable_genes(Th)
st2.pl.variable_genes(Th,show_texts=True)PCAを計算し、主成分と分散を確認する。
# stream2 7
st2.pp.pca(Th,feature='highly_variable', n_components=50)
st2.pl.pca_variance_ratio(Th, log=True)次元削減。STREAMではなかったT-SNE(method = ‘tsne’)とisomap(method = ‘isomap’)が追加されているっぽい。デフォルトではmethod = ‘umap’である。他のパラメータもSTREAMよりも随分増えている。
STREAMでも次元削減でUMAP出来るが、その結果はscanpyで行ったときとずいぶん違っていた。しかし、STREAM2ではscanpyと似た結果が帰ってきた。この結果を受けてSTREAMも設定出来る限り同じ引数を入れて試してみたが、あまり良い結果にはならなかった。
こうやってみると、STREAM2とmonocle3って結果としてやっていることが結構似ているように思う。もしかしたらクラスタリングの結果明確なtrajectoryを作らない場合は、monocle3の方が良いのかもしれない。しかし、monocle3はどうも好きになれない。このSTREAM2もそうだが、trajectoryの開始点を自由に選ぶことが出来る。そして、monocle3だと、終点まで選べたと思う。開始点は良いとして、終点までってのは、なんか違う気がする。Psudotimeだから。このあたりがmonocle3を使っていない理由ではある。要はなんとなく作為的・恣意的な感じがする。言うて、明確な根拠に基づけば良いのだが、その場合は、こんな疑似系譜解析は要る?ってなるはずである。
# stream2 8
st2.tl.dimension_reduction(Th, method = 'umap', obsm='X_pca_harmony',n_dim=40, n_jobs=4)次元削減の結果を表示してみる。
# stream2 8
st2.pl.dimension_reduction(Th,color=['louvain_1.0_2'],fig_size=(5.5,5))STREAMと同様に、グラフの初期値を求める。
# stream2 9
st2.tl.seed_graph(Th, obsm='X_dr', n_clusters=15)グラフの計算。引数がstreamのelastic_principal_graph()でも使用されていたものがあったので、おそらく同じような計算をしているんだと思う。
# stream2 10
st2.tl.learn_graph(Th, obsm='X_dr', n_nodes=20, method='principal_tree',)グラフの結果を可視化する。
# stream2 11
st2.pl.graph(Th,
color=['louvain_1.0_2'],
show_text=True,
show_node=True,
fig_legend_ncol=2)Peudotimeに沿ってストリームプロットを出力する。考えて見ると、このストリームプロットというのは良く出来ていると思う。pseudotimeが保存されているので、trajectoryを説明するのに便利である。
これはfig_ncol=4にして、4つのラベル’louvain_1.0_2’、celltype_2’、’louvain_1.0′,、’batch’を一行に並べた結果である。それに合わせてfig_legend_ncol=2にして、ラベルを2列にしている。
# stream2 12
st2.pl.stream_sc(Th,
source=0,
dist_scale=0.2,
color=['louvain_1.0_2', 'celltype_2', 'louvain_1.0', 'batch'],
fig_ncol=4,
fig_legend_ncol=2,
save_fig=False)stream2 13と同じ図であるが、今度は一つずつ可視化した場合である。
# stream2 13
st2.pl.stream(Th, source=0,
color=['louvain_1.0_2', 'celltype_2', 'louvain_1.0', 'batch', 'n_genes'],
fig_legend_ncol=1,
save_fig=False)続いて、細胞障害性T細胞(Tc)も行う。まずはヘルパーT細胞(Th)と同様にh5adを読み込んでanndataオブジェクトを作成する。
# stream2 14
Tc = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc.h5ad')
Tc_hvgs_wo_MT_RIBO = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO.h5ad')scanpyでの解析結果を表示してみる。
# stream2 15
sc.pl.umap(Tc, color=["louvain_1.0", "louvain_1.0_2", "celltype_2"], layer="normalize_pearson", legend_loc="on data")
print("----------------------Naive T--------------------------")
print("----------------------Naive T--------------------------")
print("----------------------IL2RA, CD44, CD69 are lacking in Naive T--------------------------")
Naive_T = ["SELL", "CCR7", "IL7R", "IL2RG", "IL2RA", "CD44", "CD69"]
sc.pl.umap(Tc, color=Naive_T, layer="normalize_pearson", ncols=4, save = "_Naive_Tc_stream2.png")Thと同様、遺伝子のフィルタリング(pp.filter_genes)、正規化(pp.normalize)、log1p変換(pp.log_transform)、発現量に変動の多い遺伝子を抽出(pp.select_variable_genes)、PCA(tl.pca)、主成分と分散を確認(pl.pca_variance_ratio)、次元削減(tldimension_reduction)、グラフの初期値を求める(tl.seed_graph)、グラフの計算(tl.learn_graph)、グラフの可視化(pl.graph)を行う。
# stream2 16
st2.pp.filter_genes(Tc, min_n_cells=1)
st2.pp.cal_qc_rna(Tc)
st2.pl.violin(Tc,list_obs=['n_counts','n_genes','pct_mt'], fig_size=(3,3))
st2.pp.normalize(Tc,method='lib_size')
st2.pp.log_transform(Tc)
st2.pp.select_variable_genes(Tc)
st2.pl.variable_genes(Tc,show_texts=True)
st2.pp.pca(Tc,feature='highly_variable', n_components=50)
st2.pl.pca_variance_ratio(Tc, log=True)
st2.tl.dimension_reduction(Tc, obsm='X_pca_harmony',n_dim=40, n_jobs=4)
st2.pl.dimension_reduction(Tc,color=['louvain_1.0'],fig_size=(5.5,5))
st2.tl.seed_graph(Tc, obsm='X_dr', n_clusters=15)
st2.tl.learn_graph(Tc, obsm='X_dr', n_nodes=20, method='principal_tree',)
st2.pl.graph(Tc,
color=['louvain_1.0_2'],
show_text=True,
show_node=True,
fig_legend_ncol=2) ここでストリームプロットを出力する。
# stream2 17
st2.pl.stream_sc(Tc,
source=1,
dist_scale=0.2,
color=['louvain_1.0_2', 'celltype_2', 'louvain_1.0', 'batch'],
fig_ncol=4,
fig_legend_ncol=2,
save_fig=False)
st2.pl.stream(Tc, source=1,
color=['louvain_1.0_2', 'celltype_2', 'louvain_1.0', 'batch', 'n_genes'],
fig_legend_ncol=1,
save_fig=False)
最初に書いたが、このstream2は遺伝子発現量の検定が出来ないので、非常に中途半端である。scanpyとUMAPの結果が近いんだから、発現量の解析も出来るようにしてほしかった。これはtrajectoryの開始点と終点を慎重に選べば、このようにはっきりとしたtrajectoryを作らない細胞を解析しなければならない場合は、monocle3を使うのも有りかもしれない。
使用するRパッケージ
以降はRを使った解析になる。そして、以下が使用したパッケージである。
library(devtools)
library(anndataR) # this R is version 4.4.2, package 'anndataR' requires R >= 4.5.0, it is not worked.
#library(anndata)
library(MuDataSeurat) # for ReadH5AD()
library(sceasy) # devtools::install_github("cellgeni/sceasy") # it works at 2026 06 28
# library(reticulate) # load this but still there was error.
# loompy <- reticulate::import('loompy') # load this but still there was error.
library(schard) # devtools::install_github("cellgeni/schard")
library(tidyverse)
library(Seurat)
library(SeuratDisk)
library(glmGamPoi)
library(Signac) # I think Signac is for sc-ATAC-seq
library(SingleCellExperiment)
library(SummarizedExperiment)
library(sctransform)
library(patchwork)
library(rtracklayer)
library(scds) # BiocManager::install("scds")
library(celldex)
library(SingleR)
# library(HGNChelper)
library(openxlsx)
library(DoubletFinder)
library(escape)
library(dittoSeq)
library(GSEABase)
library(TabulaMurisSenisData) # TabulaMuris data were already downloaded to "/mnt/sda1/ciea/katsu/reference_seq_annotation/Tabula_Muris".
##Following libraries are required for learning Seuratm, SingleR, sc-type and other.
library(SeuratData)
library(scRNAseq)
library(scuttle)
library(scran)
library(bluster)
library(scater)
library(ape)
# check stats
library(outliers)
# Some time "Error in grid.newpage() : " will be happpened, and following library needs to prevent it.
library(grid)
library(MetaDE) # https://cran.r-project.org/src/contrib/Archive/MetaDE/
library(scMCA) # install_github("ggjlab/scMCA", force = TRUE)
library(sc2marker) # install_github("https://github.com/CostaLab/sc2marker", build_vignettes = TRUE, force = TRUE)
library(UCell)
library(DESeq2)
library(edgeR)
library(superheat)
library(pheatmap)
library(ComplexHeatmap)
library(monocle3)
library(MAST) # IMPORTANT!! I do not know what is "logFC" in MAST. Because of this, ZINB-Wave will be probably better.
library(tidyverse)
library(dior) # devtools::install_github('JiekaiLab/dior') # this is here; https://github.com/JiekaiLab/scDIOR#2
#slingshot
library(DelayedArray)
library(scone)
library(slingshot)
library(uwot)
library(mclust)
library(RColorBrewer)
library(grDevices)
library(tradeSeq)
library(SeuratWrappers)
library(scrabbitr) # For downsampeing of SingleCellExperiment object
library(foreach)
library(doParallel)
library(data.table)
library(CellChat)
library(NMF)
library(ggalluvial)
library(wordcloud)
library(ComplexHeatmap)
library(circlize)
# DEG
library(baySeq)
library(edgeR)
library(DESeq2)
library(limma)
# enrichment analysis
library(clusterProfiler)
library(fgsea)
library(ssGSEA2) # devtools::install_github("nicolerg/ssGSEA2") # devtools::install_github(broadinstitute/ssGSEA2.0) and devtools::install_github(broadinstitute/ssGSEA2) did not work.
library(escape)
library(GSVA)
library(pathview)
# immune cell deconvolution
library(ConsensusTME)
library(estimate)
library(immunedeconv)
library(MCPcounter)
library(msigdbr)
library(quantiseqr)
library(TIMER) #devtools::install_github('hanfeisun/TIMER'); it will not work!! use TIMER of immunodeconv if you need.
library(xCell)
# stats
library(NSM3) # sudo apt install libgmp-dev libgmp10 libgmp3-dev
library(pwr)
library(missForest)
# basic
library(beeswarm)
library(circlize)
library(org.Hs.eg.db)
library(org.Mm.eg.db)
library(doParallel)
library(foreach)
library(parallel) # Need it for use of baySeq
library(pheatmap)
library(rtracklayer)
library(rvest) # this is for extraction of html table; results of leading edge analysis.
library(xml2) # this is for extraction of html table; results of leading edge analysis.
library(openxlsx) # for read xlsx file.
library(ComplexHeatmap)
library(tidyverse)
library(data.table)
library(survminer)
library(survival)
library(gridExtra)
library(MASS)
library(coin)
library(AnnotationDbi)
library(org.Hs.eg.db)
library(RhpcBLASctl)
library(psych) # for geometric mean
library(BiocParallel)
library(nichenetr)
library(multinichenetr)h5adからSeuratオブジェクト(V5)への変換
CellChatを使って細胞間コミュニケーションの解析を行う。CellChatは主にRで書かれている。よって、h5adをseuratオブジェクトに変換する必要がある。このためのパッケージはいくつかあるが、インストール出来るものは基本的に正しく動かない。また、動いたとしてもseuratオブジェクトのバージョンが違ったりして、結局、そのままでは解析に使えないことが多い。よって、h5adからSeuratオブジェクトに変換するためには、anndataを使って必要なマトリックスやデータフレームをCSVやTSVで出力、保存し、それを改めてRでデータフレームとして読み込んで、適切なデータ型に変換し、必要なオブジェクトを地道に作成していくのが最もエラーの起きない方法と思う。
ちなみに、anndataR、SeuratDisk、sceasy、schard、dior、MuDataSeuratでh5adからseuratオブジェクトへの変換を試したが、全部上手く行かなかった。MuDataSeuratはインポートは出来たが、エラーが出なかっただけで出来上がったseuratオブジェクトは使えたものではなかった。おそらく、パッケージの依存関係やオブジェクトの互換性なんかも関係しているようで、これらを使ったインポートは、綱渡りって感じだった。すなわち、どこかで何かを変えたら、それまで出来ていたインポートができなくなって詰む、ということになる印象だった。
まず、RにscanpyでエクスポートしたCSVを読み込んでいく。必要なデータは、生のリードカウント(*_layers_raw.csv)、正規化したリードカウント(*_layers_normalize_pearson.csv)、obsデータフレーム(obs.csv)、varデータフレーム(var.csv)、データフレームobsm(obsm.csv)、データフレームvarm(varm.csv)である。
ここでは生のリードカウントと正規化したリードカウントは、t()で転置させてデータフレームにする。
# h5ad to SeuratObject 1
# concat
concat_raw <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_layers_raw.csv") %>% column_to_rownames("...1")
concat_normalize_pearson <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_layers_normalize_pearson.csv")%>% column_to_rownames("...1")
concat_obs <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat/obs.csv") %>% column_to_rownames("...1")
concat_var <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat/var.csv") %>% column_to_rownames("...1")
concat_obsm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat/obsm.csv")
concat_varm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat/varm.csv")
concat_raw_t <- concat_raw %>% t() %>% data.frame()
concat_normalize_pearson_t <- concat_normalize_pearson %>% t() %>% data.frame()
# concat_obs_t <- concat_obs %>% t() %>% data.frame()
# concat_var_t <- concat_var %>% t() %>% data.frame()
# Th
Th_raw <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_layers_raw.csv") %>% column_to_rownames("...1")
Th_normalize_pearson <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_layers_normalize_pearson.csv")%>% column_to_rownames("...1")
Th_obs <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th/obs.csv") %>% column_to_rownames("...1")
Th_var <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th/var.csv") %>% column_to_rownames("...1")
Th_obsm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th/obsm.csv")
Th_varm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th/varm.csv")
Th_raw_t <- Th_raw %>% t() %>% data.frame()
Th_normalize_pearson_t <- Th_normalize_pearson %>% t() %>% data.frame()
# Th_obs_t <- Th_obs %>% t() %>% data.frame()
# Th_var_t <- Th_var %>% t() %>% data.frame()
# Th_2nd
Th_2nd_raw <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_layers_raw.csv") %>% column_to_rownames("...1")
Th_2nd_normalize_pearson <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_layers_normalize_pearson.csv")%>% column_to_rownames("...1")
Th_2nd_obs <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd/obs.csv") %>% column_to_rownames("...1")
Th_2nd_var <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd/var.csv") %>% column_to_rownames("...1")
Th_2nd_obsm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd/obsm.csv")
Th_2nd_varm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd/varm.csv")
Th_2nd_raw_t <- Th_2nd_raw %>% t() %>% data.frame()
Th_2nd_normalize_pearson_t <- Th_2nd_normalize_pearson %>% t() %>% data.frame()
# Th_2nd_obs_t <- Th_2nd_obs %>% t() %>% data.frame()
# Th_2nd_var_t <- Th_2nd_var %>% t() %>% data.frame()
# Tc
Tc_raw <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_layers_raw.csv") %>% column_to_rownames("...1")
Tc_normalize_pearson <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_layers_normalize_pearson.csv")%>% column_to_rownames("...1")
Tc_obs <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc/obs.csv") %>% column_to_rownames("...1")
Tc_var <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc/var.csv") %>% column_to_rownames("...1")
Tc_obsm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc/obsm.csv")
Tc_varm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc/varm.csv")
Tc_raw_t <- Tc_raw %>% t() %>% data.frame()
Tc_normalize_pearson_t <- Tc_normalize_pearson %>% t() %>% data.frame()
# Tc_obs_t <- Tc_obs %>% t() %>% data.frame()
# Tc_var_t <- Tc_var %>% t() %>% data.frame()続いて、同様の操作を、変動の多い遺伝子を抽出して作成したオブジェクトに対して適用する。
# h5ad to SeuratObject 2
# concat_hvgs_wo_MT_RIBO
concat_hvgs_wo_MT_RIBO_raw <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO_layers_raw.csv") %>% column_to_rownames("...1")
concat_hvgs_wo_MT_RIBO_normalize_pearson <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO_layers_normalize_pearson.csv")%>% column_to_rownames("...1")
concat_hvgs_wo_MT_RIBO_obs <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO/obs.csv") %>% column_to_rownames("...1")
concat_hvgs_wo_MT_RIBO_var <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO/var.csv") %>% column_to_rownames("...1")
concat_hvgs_wo_MT_RIBO_obsm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO/obsm.csv")
concat_hvgs_wo_MT_RIBO_varm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_hvgs_wo_MT_RIBO/varm.csv")
concat_hvgs_wo_MT_RIBO_raw_t <- concat_hvgs_wo_MT_RIBO_raw %>% t() %>% data.frame()
concat_hvgs_wo_MT_RIBO_normalize_pearson_t <- concat_hvgs_wo_MT_RIBO_normalize_pearson %>% t() %>% data.frame()
# concat_hvgs_wo_MT_RIBO_obs_t <- concat_hvgs_wo_MT_RIBO_obs %>% t() %>% data.frame()
# concat_hvgs_wo_MT_RIBO_var_t <- concat_hvgs_wo_MT_RIBO_var %>% t() %>% data.frame()
# Th_hvgs_wo_MT_RIBO
Th_hvgs_wo_MT_RIBO_raw <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO_layers_raw.csv") %>% column_to_rownames("...1")
Th_hvgs_wo_MT_RIBO_normalize_pearson <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO_layers_normalize_pearson.csv")%>% column_to_rownames("...1")
Th_hvgs_wo_MT_RIBO_obs <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO/obs.csv") %>% column_to_rownames("...1")
Th_hvgs_wo_MT_RIBO_var <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO/var.csv") %>% column_to_rownames("...1")
Th_hvgs_wo_MT_RIBO_obsm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO/obsm.csv")
Th_hvgs_wo_MT_RIBO_varm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_hvgs_wo_MT_RIBO/varm.csv")
Th_hvgs_wo_MT_RIBO_raw_t <- Th_hvgs_wo_MT_RIBO_raw %>% t() %>% data.frame()
Th_hvgs_wo_MT_RIBO_normalize_pearson_t <- Th_hvgs_wo_MT_RIBO_normalize_pearson %>% t() %>% data.frame()
# Th_hvgs_wo_MT_RIBO_obs_t <- Th_hvgs_wo_MT_RIBO_obs %>% t() %>% data.frame()
# Th_hvgs_wo_MT_RIBO_var_t <- Th_hvgs_wo_MT_RIBO_var %>% t() %>% data.frame()
# Th_2nd_hvgs_wo_MT_RIBO
Th_2nd_hvgs_wo_MT_RIBO_raw <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO_layers_raw.csv") %>% column_to_rownames("...1")
Th_2nd_hvgs_wo_MT_RIBO_normalize_pearson <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO_layers_normalize_pearson.csv")%>% column_to_rownames("...1")
Th_2nd_hvgs_wo_MT_RIBO_obs <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO/obs.csv") %>% column_to_rownames("...1")
Th_2nd_hvgs_wo_MT_RIBO_var <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO/var.csv") %>% column_to_rownames("...1")
Th_2nd_hvgs_wo_MT_RIBO_obsm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO/obsm.csv")
Th_2nd_hvgs_wo_MT_RIBO_varm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_2nd_hvgs_wo_MT_RIBO/varm.csv")
Th_2nd_hvgs_wo_MT_RIBO_raw_t <- Th_2nd_hvgs_wo_MT_RIBO_raw %>% t() %>% data.frame()
Th_2nd_hvgs_wo_MT_RIBO_normalize_pearson_t <- Th_2nd_hvgs_wo_MT_RIBO_normalize_pearson %>% t() %>% data.frame()
# Th_hvgs_wo_MT_RIBO_obs_t <- Th_hvgs_wo_MT_RIBO_obs %>% t() %>% data.frame()
# Th_hvgs_wo_MT_RIBO_var_t <- Th_hvgs_wo_MT_RIBO_var %>% t() %>% data.frame()
# Tc_hvgs_wo_MT_RIBO
Tc_hvgs_wo_MT_RIBO_raw <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO_layers_raw.csv") %>% column_to_rownames("...1")
Tc_hvgs_wo_MT_RIBO_normalize_pearson <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO_layers_normalize_pearson.csv")%>% column_to_rownames("...1")
Tc_hvgs_wo_MT_RIBO_obs <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO/obs.csv") %>% column_to_rownames("...1")
Tc_hvgs_wo_MT_RIBO_var <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO/var.csv") %>% column_to_rownames("...1")
Tc_hvgs_wo_MT_RIBO_obsm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO/obsm.csv")
Tc_hvgs_wo_MT_RIBO_varm <- read_csv("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_hvgs_wo_MT_RIBO/varm.csv")
Tc_hvgs_wo_MT_RIBO_raw_t <- Tc_hvgs_wo_MT_RIBO_raw %>% t() %>% data.frame()
Tc_hvgs_wo_MT_RIBO_normalize_pearson_t <- Tc_hvgs_wo_MT_RIBO_normalize_pearson %>% t() %>% data.frame()
# Tc_hvgs_wo_MT_RIBO_obs_t <- Tc_hvgs_wo_MT_RIBO_obs %>% t() %>% data.frame()
# Tc_hvgs_wo_MT_RIBO_var_t <- Tc_hvgs_wo_MT_RIBO_var %>% t() %>% data.frame()次に、Seuratオブジェクトを作成する。最新のseuratはバージョンが5.5.1であり、作成するSeuratオブジェクトはV5になるので注意が必要である。何に注意が必要かと言えば、他のパッケージではV3が使用されていたりすることである。後ほどこれも行う。
まず。作成した生のリードカウント(データフレームconcat_raw_t他)をCreateSeuratObject()に入れて、ひとまずSeuratObjectを作成する。これはSeuratオブジェクトでも一番基本的な生のリードカウントになるので、このとき、assay=”RNA”とする。作成したSeuratオブジェクトconcatのassaysスロットにRNAとして、スパースマトリックスにした正規化したリードカウント(データフレームconcat_normalize_pearson_t他)を入れる。
次に、scanpyで次元削減して得られた値や、ラベルになる値を入れていく。上記でインポートして作成したデータフレームconcat_obsmの列X_umap1と列X_umap2を使って、UMAPで得られた各細胞の位置を示すデータフレームconcat_umapを作成し、それをマトリックスconcat_umap_matとする。そして、これにCreateDimReducObject()を使ってDimReducオブジェクトにして、Seuratオブジェクトのreductionスロットにumapとして入れる。
次にタイピングで得られた細胞の名前celltype_2や、louvain法によって得られたクラスターの番号louvain_1.0など、必要な変数をSeuratオブジェクトのmeta.dataスロットに入れていく。その前に、各データフレームにはfactor()を付けておく。
# h5ad to SeuratObject 3
# concat
## Seurat Object
concat <- CreateSeuratObject(counts = concat_raw_t, assay = "RNA")
concat@assays$RNA@layers$data <- as.sparse(concat_normalize_pearson_t)
#concat@assays$Norm <- CreateAssay5Object(counts = as.sparse(concat_normalize_pearson_t))
## DimReduc
concat_umap <- data.frame(umap_1 = concat_obsm$X_umap1, umap_2 = concat_obsm$X_umap2) %>% as.matrix()
rownames(concat_umap) <- colnames(concat_normalize_pearson_t)
concat_umap_mat <- as.matrix(concat_umap)
concat@reductions$umap <- CreateDimReducObject(embeddings = concat_umap, assay = "RNA", global = TRUE)
## Add factor to obs
concat_obs$louvain_1.0 <- factor(concat_obs$louvain_1.0,
labels = names(table(concat_obs$louvain_1.0)),
levels = names(table(concat_obs$louvain_1.0)),
exclude = NA, ordered = is.ordered(concat_obs$louvain_1.0), nmax = NA)
concat_obs$celltype_2 <- factor(concat_obs$celltype_2,
labels = names(table(concat_obs$celltype_2)),
levels = names(table(concat_obs$celltype_2)),
exclude = NA, ordered = is.ordered(concat_obs$celltype_2), nmax = NA)
concat_obs$batch <- factor(concat_obs$batch,
labels = names(table(concat_obs$batch)),
levels = names(table(concat_obs$batch)),
exclude = NA, ordered = is.ordered(concat_obs$batch), nmax = NA)
## Meta data
concat@meta.data$louvain_1.0 <- concat_obs$louvain_1.0
concat@meta.data$celltype_2 <- concat_obs$celltype_2
concat@meta.data$batch <- concat_obs$batch
concat@meta.data$pct_counts_MT <- concat_obs$pct_counts_MT
concat@meta.data$pct_counts_RIBO <- concat_obs$pct_counts_RIBO
concat@meta.data$S_score <- concat_obs$S_score
concat@meta.data$G2M_score <- concat_obs$G2M_score
# Th
## Seurat Object
Th <- CreateSeuratObject(counts = Th_raw_t, assay = "RNA")
Th@assays$RNA@layers$data <- as.sparse(Th_normalize_pearson_t)
#Th@assays$Norm <- CreateAssay5Object(counts = as.sparse(Th_normalize_pearson_t))
## DimReduc
Th_umap <- data.frame(umap_1 = Th_obsm$X_umap1, umap_2 = Th_obsm$X_umap2) %>% as.matrix()
rownames(Th_umap) <- colnames(Th_normalize_pearson_t)
Th_umap_mat <- as.matrix(Th_umap)
Th@reductions$umap <- CreateDimReducObject(embeddings = Th_umap, assay = "RNA", global = TRUE)
## Add factor to obs
Th_obs$louvain_1.0 <- factor(Th_obs$louvain_1.0,
labels = names(table(Th_obs$louvain_1.0)),
levels = names(table(Th_obs$louvain_1.0)),
exclude = NA, ordered = is.ordered(Th_obs$louvain_1.0), nmax = NA)
Th_obs$louvain_1.0_2 <- factor(Th_obs$louvain_1.0_2,
labels = names(table(Th_obs$louvain_1.0_2)),
levels = names(table(Th_obs$louvain_1.0_2)),
exclude = NA, ordered = is.ordered(Th_obs$louvain_1.0_2), nmax = NA)
Th_obs$celltype_2 <- factor(Th_obs$celltype_2,
labels = names(table(Th_obs$celltype_2)),
levels = names(table(Th_obs$celltype_2)),
exclude = NA, ordered = is.ordered(Th_obs$celltype_2), nmax = NA)
Th_obs$batch <- factor(Th_obs$batch,
labels = names(table(Th_obs$batch)),
levels = names(table(Th_obs$batch)),
exclude = NA, ordered = is.ordered(Th_obs$batch), nmax = NA)
## Meta data
Th@meta.data$louvain_1.0 <- Th_obs$louvain_1.0
Th@meta.data$louvain_1.0_2 <- Th_obs$louvain_1.0_2
Th@meta.data$celltype_2 <- Th_obs$celltype_2
Th@meta.data$batch <- Th_obs$batch
Th@meta.data$pct_counts_MT <- Th_obs$pct_counts_MT
Th@meta.data$pct_counts_RIBO <- Th_obs$pct_counts_RIBO
Th@meta.data$S_score <- Th_obs$S_score
Th@meta.data$G2M_score <- Th_obs$G2M_score
# Th_2nd
## Seurat Object
Th_2nd <- CreateSeuratObject(counts = Th_2nd_raw_t, assay = "RNA")
Th_2nd@assays$RNA@layers$data <- as.sparse(Th_2nd_normalize_pearson_t)
#Th_2nd@assays$Norm <- CreateAssay5Object(counts = as.sparse(Th_2nd_normalize_pearson_t))
## DimReduc
Th_2nd_umap <- data.frame(umap_1 = Th_2nd_obsm$X_umap1, umap_2 = Th_2nd_obsm$X_umap2) %>% as.matrix()
rownames(Th_2nd_umap) <- colnames(Th_2nd_normalize_pearson_t)
Th_2nd_umap_mat <- as.matrix(Th_2nd_umap)
Th_2nd@reductions$umap <- CreateDimReducObject(embeddings = Th_2nd_umap, assay = "RNA", global = TRUE)
## Add factor to obs
Th_2nd_obs$louvain_1.0 <- factor(Th_2nd_obs$louvain_1.0,
labels = names(table(Th_2nd_obs$louvain_1.0)),
levels = names(table(Th_2nd_obs$louvain_1.0)),
exclude = NA, ordered = is.ordered(Th_2nd_obs$louvain_1.0), nmax = NA)
Th_2nd_obs$louvain_1.0_2 <- factor(Th_2nd_obs$louvain_1.0_2,
labels = names(table(Th_2nd_obs$louvain_1.0_2)),
levels = names(table(Th_2nd_obs$louvain_1.0_2)),
exclude = NA, ordered = is.ordered(Th_2nd_obs$louvain_1.0_2), nmax = NA)
Th_2nd_obs$celltype_2 <- factor(Th_2nd_obs$celltype_2,
labels = names(table(Th_2nd_obs$celltype_2)),
levels = names(table(Th_2nd_obs$celltype_2)),
exclude = NA, ordered = is.ordered(Th_2nd_obs$celltype_2), nmax = NA)
Th_2nd_obs$batch <- factor(Th_2nd_obs$batch,
labels = names(table(Th_2nd_obs$batch)),
levels = names(table(Th_2nd_obs$batch)),
exclude = NA, ordered = is.ordered(Th_2nd_obs$batch), nmax = NA)
## Meta data
Th_2nd@meta.data$louvain_1.0 <- Th_2nd_obs$louvain_1.0
Th_2nd@meta.data$louvain_1.0_2 <- Th_2nd_obs$louvain_1.0_2
Th_2nd@meta.data$celltype_2 <- Th_2nd_obs$celltype_2
Th_2nd@meta.data$batch <- Th_2nd_obs$batch
Th_2nd@meta.data$pct_counts_MT <- Th_2nd_obs$pct_counts_MT
Th_2nd@meta.data$pct_counts_RIBO <- Th_2nd_obs$pct_counts_RIBO
Th_2nd@meta.data$S_score <- Th_2nd_obs$S_score
Th_2nd@meta.data$G2M_score <- Th_2nd_obs$G2M_score
# Tc
## Seurat Object
Tc <- CreateSeuratObject(counts = Tc_raw_t, assay = "RNA")
Tc@assays$RNA@layers$data <- as.sparse(Tc_normalize_pearson_t)
#Tc@assays$Norm <- CreateAssay5Object(counts = as.sparse(Tc_normalize_pearson_t))
## DimReduc
Tc_umap <- data.frame(umap_1 = Tc_obsm$X_umap1, umap_2 = Tc_obsm$X_umap2) %>% as.matrix()
rownames(Tc_umap) <- colnames(Tc_normalize_pearson_t)
Tc_umap_mat <- as.matrix(Tc_umap)
Tc@reductions$umap <- CreateDimReducObject(embeddings = Tc_umap, assay = "RNA", global = TRUE)
## Add factor to obs
Tc_obs$louvain_1.0 <- factor(Tc_obs$louvain_1.0,
labels = names(table(Tc_obs$louvain_1.0)),
levels = names(table(Tc_obs$louvain_1.0)),
exclude = NA, ordered = is.ordered(Tc_obs$louvain_1.0), nmax = NA)
Tc_obs$louvain_1.0_2 <- factor(Tc_obs$louvain_1.0_2,
labels = names(table(Tc_obs$louvain_1.0_2)),
levels = names(table(Tc_obs$louvain_1.0_2)),
exclude = NA, ordered = is.ordered(Tc_obs$louvain_1.0_2), nmax = NA)
Tc_obs$celltype_2 <- factor(Tc_obs$celltype_2,
labels = names(table(Tc_obs$celltype_2)),
levels = names(table(Tc_obs$celltype_2)),
exclude = NA, ordered = is.ordered(Tc_obs$celltype_2), nmax = NA)
Tc_obs$batch <- factor(Tc_obs$batch,
labels = names(table(Tc_obs$batch)),
levels = names(table(Tc_obs$batch)),
exclude = NA, ordered = is.ordered(Tc_obs$batch), nmax = NA)
## Meta data
Tc@meta.data$louvain_1.0 <- Tc_obs$louvain_1.0
Tc@meta.data$louvain_1.0_2 <- Tc_obs$louvain_1.0_2
Tc@meta.data$celltype_2 <- Tc_obs$celltype_2
Tc@meta.data$batch <- Tc_obs$batch
Tc@meta.data$pct_counts_MT <- Tc_obs$pct_counts_MT
Tc@meta.data$pct_counts_RIBO <- Tc_obs$pct_counts_RIBO
Tc@meta.data$S_score <- Tc_obs$S_score
Tc@meta.data$G2M_score <- Tc_obs$G2M_scoreクラスター間で変動の大きい遺伝子を抽出して作成したオブジェクトにも同様にその処理を適用する。
# h5ad to SeuratObject 4
# concat_hvgs_wo_MT_RIBO
## Seurat Object
concat_hvgs_wo_MT_RIBO <- CreateSeuratObject(counts = concat_hvgs_wo_MT_RIBO_raw_t, assay = "RNA")
concat_hvgs_wo_MT_RIBO@assays$RNA@layers$data <- as.sparse(concat_hvgs_wo_MT_RIBO_normalize_pearson_t)
#concat_hvgs_wo_MT_RIBO@assays$Norm <- CreateAssay5Object(counts = as.sparse(concat_hvgs_wo_MT_RIBO_normalize_pearson_t))
## DimReduc
concat_hvgs_wo_MT_RIBO_umap <- data.frame(umap_1 = concat_hvgs_wo_MT_RIBO_obsm$X_umap1, umap_2 = concat_hvgs_wo_MT_RIBO_obsm$X_umap2) %>% as.matrix()
rownames(concat_hvgs_wo_MT_RIBO_umap) <- colnames(concat_hvgs_wo_MT_RIBO_normalize_pearson_t)
concat_hvgs_wo_MT_RIBO_umap_mat <- as.matrix(concat_hvgs_wo_MT_RIBO_umap)
concat_hvgs_wo_MT_RIBO@reductions$umap <- CreateDimReducObject(embeddings = concat_hvgs_wo_MT_RIBO_umap, assay = "RNA", global = TRUE)
## Add factor to obs
concat_hvgs_wo_MT_RIBO_obs$louvain_1.0 <- factor(concat_hvgs_wo_MT_RIBO_obs$louvain_1.0,
labels = names(table(concat_hvgs_wo_MT_RIBO_obs$louvain_1.0)),
levels = names(table(concat_hvgs_wo_MT_RIBO_obs$louvain_1.0)),
exclude = NA, ordered = is.ordered(concat_hvgs_wo_MT_RIBO_obs$louvain_1.0), nmax = NA)
concat_hvgs_wo_MT_RIBO_obs$celltype_2 <- factor(concat_hvgs_wo_MT_RIBO_obs$celltype_2,
labels = names(table(concat_hvgs_wo_MT_RIBO_obs$celltype_2)),
levels = names(table(concat_hvgs_wo_MT_RIBO_obs$celltype_2)),
exclude = NA, ordered = is.ordered(concat_hvgs_wo_MT_RIBO_obs$celltype_2), nmax = NA)
concat_hvgs_wo_MT_RIBO_obs$batch <- factor(concat_hvgs_wo_MT_RIBO_obs$batch,
labels = names(table(concat_hvgs_wo_MT_RIBO_obs$batch)),
levels = names(table(concat_hvgs_wo_MT_RIBO_obs$batch)),
exclude = NA, ordered = is.ordered(concat_hvgs_wo_MT_RIBO_obs$batch), nmax = NA)
## Meta data
concat_hvgs_wo_MT_RIBO@meta.data$louvain_1.0 <- concat_hvgs_wo_MT_RIBO_obs$louvain_1.0
concat_hvgs_wo_MT_RIBO@meta.data$celltype_2 <- concat_hvgs_wo_MT_RIBO_obs$celltype_2
concat_hvgs_wo_MT_RIBO@meta.data$batch <- concat_hvgs_wo_MT_RIBO_obs$batch
# Th_hvgs_wo_MT_RIBO
## Seurat Object
Th_hvgs_wo_MT_RIBO <- CreateSeuratObject(counts = Th_hvgs_wo_MT_RIBO_raw_t, assay = "RNA")
Th_hvgs_wo_MT_RIBO@assays$RNA@layers$data <- as.sparse(Th_hvgs_wo_MT_RIBO_normalize_pearson_t)
#Th_hvgs_wo_MT_RIBO@assays$Norm <- CreateAssay5Object(counts = as.sparse(Th_hvgs_wo_MT_RIBO_normalize_pearson_t))
## DimReduc
Th_hvgs_wo_MT_RIBO_umap <- data.frame(umap_1 = Th_hvgs_wo_MT_RIBO_obsm$X_umap1, umap_2 = Th_hvgs_wo_MT_RIBO_obsm$X_umap2) %>% as.matrix()
rownames(Th_hvgs_wo_MT_RIBO_umap) <- colnames(Th_hvgs_wo_MT_RIBO_normalize_pearson_t)
Th_hvgs_wo_MT_RIBO_umap_mat <- as.matrix(Th_hvgs_wo_MT_RIBO_umap)
Th_hvgs_wo_MT_RIBO@reductions$umap <- CreateDimReducObject(embeddings = Th_hvgs_wo_MT_RIBO_umap, assay = "RNA", global = TRUE)
## Add factor to obs
Th_hvgs_wo_MT_RIBO_obs$louvain_1.0 <- factor(Th_hvgs_wo_MT_RIBO_obs$louvain_1.0,
labels = names(table(Th_hvgs_wo_MT_RIBO_obs$louvain_1.0)),
levels = names(table(Th_hvgs_wo_MT_RIBO_obs$louvain_1.0)),
exclude = NA, ordered = is.ordered(Th_hvgs_wo_MT_RIBO_obs$louvain_1.0), nmax = NA)
Th_hvgs_wo_MT_RIBO_obs$louvain_1.0_2 <- factor(Th_hvgs_wo_MT_RIBO_obs$louvain_1.0_2,
labels = names(table(Th_hvgs_wo_MT_RIBO_obs$louvain_1.0_2)),
levels = names(table(Th_hvgs_wo_MT_RIBO_obs$louvain_1.0_2)),
exclude = NA, ordered = is.ordered(Th_hvgs_wo_MT_RIBO_obs$louvain_1.0_2), nmax = NA)
Th_hvgs_wo_MT_RIBO_obs$celltype_2 <- factor(Th_hvgs_wo_MT_RIBO_obs$celltype_2,
labels = names(table(Th_hvgs_wo_MT_RIBO_obs$celltype_2)),
levels = names(table(Th_hvgs_wo_MT_RIBO_obs$celltype_2)),
exclude = NA, ordered = is.ordered(Th_hvgs_wo_MT_RIBO_obs$celltype_2), nmax = NA)
Th_hvgs_wo_MT_RIBO_obs$batch <- factor(Th_hvgs_wo_MT_RIBO_obs$batch,
labels = names(table(Th_hvgs_wo_MT_RIBO_obs$batch)),
levels = names(table(Th_hvgs_wo_MT_RIBO_obs$batch)),
exclude = NA, ordered = is.ordered(Th_hvgs_wo_MT_RIBO_obs$batch), nmax = NA)
## Meta data
Th_hvgs_wo_MT_RIBO@meta.data$louvain_1.0 <- Th_hvgs_wo_MT_RIBO_obs$louvain_1.0
Th_hvgs_wo_MT_RIBO@meta.data$louvain_1.0_2 <- Th_hvgs_wo_MT_RIBO_obs$louvain_1.0_2
Th_hvgs_wo_MT_RIBO@meta.data$celltype_2 <- Th_hvgs_wo_MT_RIBO_obs$celltype_2
Th_hvgs_wo_MT_RIBO@meta.data$batch <- Th_hvgs_wo_MT_RIBO_obs$batch
Th_hvgs_wo_MT_RIBO@meta.data$pct_counts_MT <- Th_hvgs_wo_MT_RIBO_obs$pct_counts_MT
Th_hvgs_wo_MT_RIBO@meta.data$pct_counts_RIBO <- Th_hvgs_wo_MT_RIBO_obs$pct_counts_RIBO
Th_hvgs_wo_MT_RIBO@meta.data$S_score <- Th_hvgs_wo_MT_RIBO_obs$S_score
Th_hvgs_wo_MT_RIBO@meta.data$G2M_score <- Th_hvgs_wo_MT_RIBO_obs$G2M_score
# Th_2nd_hvgs_wo_MT_RIBO
## Seurat Object
Th_2nd_hvgs_wo_MT_RIBO <- CreateSeuratObject(counts = Th_2nd_hvgs_wo_MT_RIBO_raw_t, assay = "RNA")
Th_2nd_hvgs_wo_MT_RIBO@assays$RNA@layers$data <- as.sparse(Th_2nd_hvgs_wo_MT_RIBO_normalize_pearson_t)
#Th_2nd_hvgs_wo_MT_RIBO@assays$Norm <- CreateAssay5Object(counts = as.sparse(Th_2nd_hvgs_wo_MT_RIBO_normalize_pearson_t))
## DimReduc
Th_2nd_hvgs_wo_MT_RIBO_umap <- data.frame(umap_1 = Th_2nd_hvgs_wo_MT_RIBO_obsm$X_umap1, umap_2 = Th_2nd_hvgs_wo_MT_RIBO_obsm$X_umap2) %>% as.matrix()
rownames(Th_2nd_hvgs_wo_MT_RIBO_umap) <- colnames(Th_2nd_hvgs_wo_MT_RIBO_normalize_pearson_t)
Th_2nd_hvgs_wo_MT_RIBO_umap_mat <- as.matrix(Th_2nd_hvgs_wo_MT_RIBO_umap)
Th_2nd_hvgs_wo_MT_RIBO@reductions$umap <- CreateDimReducObject(embeddings = Th_2nd_hvgs_wo_MT_RIBO_umap, assay = "RNA", global = TRUE)
## Add factor to obs
Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0 <- factor(Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0,
labels = names(table(Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0)),
levels = names(table(Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0)),
exclude = NA, ordered = is.ordered(Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0), nmax = NA)
Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0_2 <- factor(Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0_2,
labels = names(table(Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0_2)),
levels = names(table(Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0_2)),
exclude = NA, ordered = is.ordered(Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0_2), nmax = NA)
Th_2nd_hvgs_wo_MT_RIBO_obs$celltype_2 <- factor(Th_2nd_hvgs_wo_MT_RIBO_obs$celltype_2,
labels = names(table(Th_2nd_hvgs_wo_MT_RIBO_obs$celltype_2)),
levels = names(table(Th_2nd_hvgs_wo_MT_RIBO_obs$celltype_2)),
exclude = NA, ordered = is.ordered(Th_2nd_hvgs_wo_MT_RIBO_obs$celltype_2), nmax = NA)
Th_2nd_hvgs_wo_MT_RIBO_obs$batch <- factor(Th_2nd_hvgs_wo_MT_RIBO_obs$batch,
labels = names(table(Th_2nd_hvgs_wo_MT_RIBO_obs$batch)),
levels = names(table(Th_2nd_hvgs_wo_MT_RIBO_obs$batch)),
exclude = NA, ordered = is.ordered(Th_2nd_hvgs_wo_MT_RIBO_obs$batch), nmax = NA)
## Meta data
Th_2nd_hvgs_wo_MT_RIBO@meta.data$louvain_1.0 <- Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0
Th_2nd_hvgs_wo_MT_RIBO@meta.data$louvain_1.0_2 <- Th_2nd_hvgs_wo_MT_RIBO_obs$louvain_1.0_2
Th_2nd_hvgs_wo_MT_RIBO@meta.data$celltype_2 <- Th_2nd_hvgs_wo_MT_RIBO_obs$celltype_2
Th_2nd_hvgs_wo_MT_RIBO@meta.data$batch <- Th_2nd_hvgs_wo_MT_RIBO_obs$batch
Th_2nd_hvgs_wo_MT_RIBO@meta.data$pct_counts_MT <- Th_2nd_hvgs_wo_MT_RIBO_obs$pct_counts_MT
Th_2nd_hvgs_wo_MT_RIBO@meta.data$pct_counts_RIBO <- Th_2nd_hvgs_wo_MT_RIBO_obs$pct_counts_RIBO
Th_2nd_hvgs_wo_MT_RIBO@meta.data$S_score <- Th_2nd_hvgs_wo_MT_RIBO_obs$S_score
Th_2nd_hvgs_wo_MT_RIBO@meta.data$G2M_score <- Th_2nd_hvgs_wo_MT_RIBO_obs$G2M_score
# Tc_hvgs_wo_MT_RIBO
## Seurat Object
Tc_hvgs_wo_MT_RIBO <- CreateSeuratObject(counts = Tc_hvgs_wo_MT_RIBO_raw_t, assay = "RNA")
Tc_hvgs_wo_MT_RIBO@assays$RNA@layers$data <- as.sparse(Tc_hvgs_wo_MT_RIBO_normalize_pearson_t)
#Tc_hvgs_wo_MT_RIBO@assays$Norm <- CreateAssay5Object(counts = as.sparse(Tc_hvgs_wo_MT_RIBO_normalize_pearson_t))
## DimReduc
Tc_hvgs_wo_MT_RIBO_umap <- data.frame(umap_1 = Tc_hvgs_wo_MT_RIBO_obsm$X_umap1, umap_2 = Tc_hvgs_wo_MT_RIBO_obsm$X_umap2) %>% as.matrix()
rownames(Tc_hvgs_wo_MT_RIBO_umap) <- colnames(Tc_hvgs_wo_MT_RIBO_normalize_pearson_t)
Tc_hvgs_wo_MT_RIBO_umap_mat <- as.matrix(Tc_hvgs_wo_MT_RIBO_umap)
Tc_hvgs_wo_MT_RIBO@reductions$umap <- CreateDimReducObject(embeddings = Tc_hvgs_wo_MT_RIBO_umap, assay = "RNA", global = TRUE)
## Add factor to obs
Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0 <- factor(Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0,
labels = names(table(Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0)),
levels = names(table(Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0)),
exclude = NA, ordered = is.ordered(Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0), nmax = NA)
Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0_2 <- factor(Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0_2,
labels = names(table(Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0_2)),
levels = names(table(Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0_2)),
exclude = NA, ordered = is.ordered(Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0_2), nmax = NA)
Tc_hvgs_wo_MT_RIBO_obs$celltype_2 <- factor(Tc_hvgs_wo_MT_RIBO_obs$celltype_2,
labels = names(table(Tc_hvgs_wo_MT_RIBO_obs$celltype_2)),
levels = names(table(Tc_hvgs_wo_MT_RIBO_obs$celltype_2)),
exclude = NA, ordered = is.ordered(Tc_hvgs_wo_MT_RIBO_obs$celltype_2), nmax = NA)
Tc_hvgs_wo_MT_RIBO_obs$batch <- factor(Tc_hvgs_wo_MT_RIBO_obs$batch,
labels = names(table(Tc_hvgs_wo_MT_RIBO_obs$batch)),
levels = names(table(Tc_hvgs_wo_MT_RIBO_obs$batch)),
exclude = NA, ordered = is.ordered(Tc_hvgs_wo_MT_RIBO_obs$batch), nmax = NA)
## Meta data
Tc_hvgs_wo_MT_RIBO@meta.data$louvain_1.0 <- Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0
Tc_hvgs_wo_MT_RIBO@meta.data$louvain_1.0_2 <- Tc_hvgs_wo_MT_RIBO_obs$louvain_1.0_2
Tc_hvgs_wo_MT_RIBO@meta.data$celltype_2 <- Tc_hvgs_wo_MT_RIBO_obs$celltype_2
Tc_hvgs_wo_MT_RIBO@meta.data$batch <- Tc_hvgs_wo_MT_RIBO_obs$batch
Tc_hvgs_wo_MT_RIBO@meta.data$pct_counts_MT <- Tc_hvgs_wo_MT_RIBO_obs$pct_counts_MT
Tc_hvgs_wo_MT_RIBO@meta.data$pct_counts_RIBO <- Tc_hvgs_wo_MT_RIBO_obs$pct_counts_RIBO
Tc_hvgs_wo_MT_RIBO@meta.data$S_score <- Tc_hvgs_wo_MT_RIBO_obs$S_score
Tc_hvgs_wo_MT_RIBO@meta.data$G2M_score <- Tc_hvgs_wo_MT_RIBO_obs$G2M_score次に、CellChat用にリードカウントを正規化する。scanpyでも同じような正規化が出来るのだが、なんか微妙に違っているらしく、scanpyの計算ではデータセットにマイナスの値が出てきてしまう。それだとCellChatで計算できない。よって、似たようなアルゴリズムを使っている(と思う)SCtransformを使って改めて正規化する。このとき、列pct_counts_M(細胞あたりのミトコンドリア遺伝子の割合)、列pct_counts_MT(リボソーム遺伝子の占める割合)、列(S_score)S期、列(S_score)列G2M_score(G2M期関連の遺伝子のスコア)をこの計算から外すことが出来る。正直にいうが、この操作は文献を読んでもいまいち良くわからない。
正規化したデータはSeuratオブジェクトのassaysスロットのSCTに入るはず。
# h5ad to SeuratObject 5
# SCtransform, this is for cellchat
concat_sctransform <- SCTransform(concat,
vars.to.regress = c("pct_counts_MT", "pct_counts_RIBO", "S_score", "G2M_score"),
verbose = TRUE)
Th_sctransform <- SCTransform(Th,
vars.to.regress = c("pct_counts_MT", "pct_counts_RIBO", "S_score", "G2M_score"),
verbose = TRUE)
Th_2nd_sctransform <- SCTransform(Th_2nd,
vars.to.regress = c("pct_counts_MT", "pct_counts_RIBO", "S_score", "G2M_score"),
verbose = TRUE)
Tc_sctransform <- SCTransform(Tc,
vars.to.regress = c("pct_counts_MT", "pct_counts_RIBO", "S_score", "G2M_score"),
verbose = TRUE)作成したSeuratオブジェクトを使ってUMAPを可視化し、scanpyで作成したものと同じかどうかを確認する。各Seuratオブジェクトのデフォルトになるカウントマトリックスを、DefaultAssay()を使ってRNAにする。ここは、必要に応じてかえながら解析していく必要がある。例えば、正規化したリードカウントが必要ならばここをSCTにしてから解析を進める。そして、必要に応じてまたRNAに戻ったりする。そして、主として使用するラベルをIdents()で設定する。ここには、meta.dataスロットに設定されている列を必要に応じて設定する。ここも色々と変えながら解析していくことになる。そして、設定したらDimPlot()でUMAPを確認する。このときはScanpyで求めたUMAPを再現することができた。
# h5ad to SeuratObject 6
DefaultAssay(concat) <- "RNA" #Norm #integrated #RNA
DefaultAssay(Th) <- "RNA" #Norm #integrated #RNA
DefaultAssay(Th_2nd) <- "RNA" #Norm #integrated #RNA
DefaultAssay(Tc) <- "RNA" #Norm #integrated #RNA
DefaultAssay(concat_hvgs_wo_MT_RIBO) <- "RNA" #Norm #integrated #RNA
DefaultAssay(Th_hvgs_wo_MT_RIBO) <- "RNA" #Norm #integrated #RNA
DefaultAssay(Th_2nd_hvgs_wo_MT_RIBO) <- "RNA" #Norm #integrated #RNA
DefaultAssay(Tc_hvgs_wo_MT_RIBO) <- "RNA" #Norm #integrated #RNA
Idents(concat) <- "celltype_2"
Idents(Th) <- "louvain_1.0_2"
Idents(Th_2nd) <- "louvain_1.0_2"
Idents(Tc) <- "louvain_1.0_2"
Idents(concat_hvgs_wo_MT_RIBO) <- "celltype_2"
Idents(Th_hvgs_wo_MT_RIBO) <- "louvain_1.0_2"
Idents(Th_2nd_hvgs_wo_MT_RIBO) <- "louvain_1.0_2"
Idents(Tc_hvgs_wo_MT_RIBO) <- "louvain_1.0_2"
# DimPlot
DimPlot(concat, label = TRUE)
DimPlot(Th, label = TRUE)
DimPlot(Th_2nd, label = TRUE)
DimPlot(Tc, label = TRUE)
DimPlot(concat_hvgs_wo_MT_RIBO, label = TRUE)
DimPlot(Th_hvgs_wo_MT_RIBO, label = TRUE)
DimPlot(Th_2nd_hvgs_wo_MT_RIBO, label = TRUE)
DimPlot(Tc_hvgs_wo_MT_RIBO, label = TRUE)
同様に、UMAPを確認する。必要なデータがSeuratオブジェクトに移行出来ているので、次の解析に移る。
# h5ad to SeuratObject 7
# Th
Idents(Th_hvgs_wo_MT_RIBO) <- "batch"
DimPlot(Th_hvgs_wo_MT_RIBO, label = TRUE)
Idents(Th_hvgs_wo_MT_RIBO) <- "louvain_1.0"
DimPlot(Th_hvgs_wo_MT_RIBO, label = TRUE)
Idents(Th_hvgs_wo_MT_RIBO) <- "louvain_1.0_2"
DimPlot(Th_hvgs_wo_MT_RIBO, label = TRUE)
# Th_2nd
Idents(Th_2nd_hvgs_wo_MT_RIBO) <- "batch"
DimPlot(Th_2nd_hvgs_wo_MT_RIBO, label = TRUE)
Idents(Th_2nd_hvgs_wo_MT_RIBO) <- "louvain_1.0"
DimPlot(Th_2nd_hvgs_wo_MT_RIBO, label = TRUE)
Idents(Th_2nd_hvgs_wo_MT_RIBO) <- "louvain_1.0_2"
DimPlot(Th_2nd_hvgs_wo_MT_RIBO, label = TRUE)
# Tc
Idents(Tc_hvgs_wo_MT_RIBO) <- "batch"
DimPlot(Tc_hvgs_wo_MT_RIBO, label = TRUE)
Idents(Tc_hvgs_wo_MT_RIBO) <- "louvain_1.0"
DimPlot(Tc_hvgs_wo_MT_RIBO, label = TRUE)
Idents(Tc_hvgs_wo_MT_RIBO) <- "louvain_1.0_2"
DimPlot(Tc_hvgs_wo_MT_RIBO, label = TRUE) escape、GSVA、fgsea、ssGSEA2によるPsudoblukのエンリッチメント解析
ここでは対象となるクラスターをPseudobulkingして、それらに対して各種エンリッチメント解析(というかGene Set Enrichment Analysis;GSEA)を行っていく。この解析では単にGSEAを行うだけになるが、特にssGSEA2では遺伝子セット毎にファイルが出力されるので、それを使ってLeading Edge geneを同定することができ、それによってそのクラスターのマーカー遺伝子を、例えば、Gene Ontologyにあるシグナル経路を使う場合は、Biological Pathway、Molecular Function、Cellular Componentを区別してアノテーションすることが出来る。もちろん、PseudobulkingせずにカウントマトリックスをそのままGSEAし、各細胞毎の分子シグナルを解析する方法もあるだろうが、それだとかなり大変になるような気がする。クラスター毎のマーカー遺伝子を生物学的に意味のあるシグナルから見つけるためには、細胞毎にGSEAにするよりもPseudobulkingしてしまった方が計算が楽である。逆にそのクラスターにおける細胞毎の分子シグナルを知りたいときは、もちろん細胞毎にGSEAを行う必要がある。その場合は、エンリッチされてきたシグナル経路の統計なんかが必要になるだろう。この場合、何らかのデータベースに登録されたシグナル経路を広範囲に使おうとすると、解析が大変(目星がなさすぎて不可能に近いように思う)になる。
ひとまず、対象とする各Seuratオブジェクトにあるクラスターの数を出す。
# enrichment 1
table(Th_hvgs_wo_MT_RIBO@active.ident)
table(Idents(Th_hvgs_wo_MT_RIBO))
table(Tc_hvgs_wo_MT_RIBO@active.ident)
table(Idents(Tc_hvgs_wo_MT_RIBO))Pseudobulking
ここで、Pseudobulkingする。まず、使用するラベルが保持されているラベルをIdents()で設定する。PeudobulkingにはAggregateExpression()を使う。これで、各クラスター毎にアノテーションされた遺伝子発現量を合計することができる。クラスター名を数字から始まる列名ではなく、アルファベットから始まる列名に変更しておく。
# enrichment 2
Idents(Th_hvgs_wo_MT_RIBO) <- "louvain_1.0_2"
Th_pseudobulk <- AggregateExpression(Th_hvgs_wo_MT_RIBO, assay = "RNA", group.by = "ident")
Th_pseudobulk$RNA@Dimnames[[2]] <- c("c0", "c1", "c2", "c3", "c4", "c5", "c6", "c7")
Idents(Th_hvgs_wo_MT_RIBO) <- "louvain_1.0_2"
Tc_pseudobulk <- AggregateExpression(Tc_hvgs_wo_MT_RIBO, assay = "RNA", group.by = "ident")
Tc_pseudobulk$RNA@Dimnames[[2]] <- c("c0", "c1", "c2", "c3", "c4", "c5", "c6", "c7", "c8", "c9", "c10", "c11", "c12")
各種GSEAを行うため、カウントマトリックスをデータフレームにしておく。
# enrichment 3
Th_pseudobulk_df <- data.frame(Th_pseudobulk$RNA)
Tc_pseudobulk_df <- data.frame(Tc_pseudobulk$RNA)edgeRによる正規化
ここで、Pseudobulkingして得られたカウントマトリックスを正規化する。ここではedgeRを使った。edgRの正規化は、TMM(Trimed Mean of M values)法である。
# enrichment 4
# Th_psuedobulk
## Prepare DGEList object for edgeR
Th_DGEList <- edgeR::DGEList(Th_pseudobulk_df)
## scale with edgeR
Th_NormFactors <- calcNormFactors(Th_DGEList)
## Normalization
Th_normalized <- cpm(Th_NormFactors,
normalized.lib.sizes = TRUE,
log = FALSE) %>% data.frame() # %>% rownames_to_column(var = "gene_id")
# Tc_psuedobulk
## Prepare DGEList object for edgeR
Tc_DGEList <- edgeR::DGEList(Tc_pseudobulk_df)
## scale with edgeR
Tc_NormFactors <- calcNormFactors(Tc_DGEList)
## Normalization
Tc_normalized <- cpm(Tc_NormFactors,
normalized.lib.sizes = TRUE,
log = FALSE) %>% data.frame() # %>% rownames_to_column(var = "gene_id")GMTファイルの読み込み
遺伝子セットを準備する。ここでは、MsigDBにある遺伝子セット全体を選んだ。何もこんなに広範囲な遺伝子セットを選ぶ必要はない。むしろ、たとえばMsigDBのC8(免疫や炎症のシグナル経路)のように、目的に応じて絞った遺伝子セットを使用するべきである。
# enrichment 5
# immunologic signature gene sets
msigdb_C7_202607 <- readGMT("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/c7.all.v2026.1.Hs.symbols.gmt")
# cell type signature gene sets
msigdb_C8_202607 <- readGMT("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/c8.all.v2026.1.Hs.symbols.gmt")
# All gene sets
msigdb_All_202607 <- readGMT("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/msigdb.v2026.1.Hs.symbols.gmt")edgeRで正規化したデータフレームを、マトリックスに変換する。
# enrichment 6
Th_normalized_mat <- as.matrix(Th_normalized)
Tc_normalized_mat <- as.matrix(Tc_normalized)Escapeによるエンリッチメント解析
最初にescape。これは計算が早くてすごく良い。ただし、エンリッチメントの解析結果した出力されないのでLeading edge geneの解析は難しいかもしれない。
# enrichment 7
## escape, Th, msigdb
set.seed(20260725)
start_results_escape <- Sys.time()
result_escape <- escape.matrix(
input.data = Th_normalized_mat,
gene.sets = msigdb_All_202607,
method = "ssGSEA",
groups = 1000,
min.size = 10,
BPPARAM = MulticoreParam(workers = 16, progressbar = TRUE))
end_results_escape <- Sys.time()
gc(T,T,T)
gc(T,T,T)
## escape, Tc, msigdb
set.seed(20260725)
start_results_escape_Tc <- Sys.time()
result_escape_Tc <- escape.matrix(
input.data = Tc_normalized_mat,
gene.sets = msigdb_All_202607,
method = "ssGSEA",
groups = 1000,
min.size = 10,
BPPARAM = MulticoreParam(workers = 16, progressbar = TRUE))
end_results_escape_Tc <- Sys.time()
gc(T,T,T)
gc(T,T,T)GVSAによるエンリッチメント解析
次にGSVA。これも計算が早くて良い。これは、escape、fgsea、ssGSEA2に比べて、エンリッチメントスコアの範囲が広く、すごくわかりやすい結果だったと思う。ただし、leading edge geneの解析は出来ないはず。
# enrichment 8
## geva, Th, msigdb
set.seed(20260725)
start_results_GSVA_Th <- Sys.time()
gsvaPar_Th <- gsvaParam(Th_normalized_mat, msigdb_All_202607)
result_gsva_Tc <- gsva(gsvaPar_Th, verbose=TRUE, BPPARAM = MulticoreParam(workers = 16, progressbar = TRUE))
end_results_GSVA_Th <- Sys.time()
gc(T,T,T)
gc(T,T,T)
## geva, Tc, msigdb
set.seed(20260725)
start_results_GSVA_Tc <- Sys.time()
gsvaPar_Tc <- gsvaParam(Tc_normalized_mat, msigdb_All_202607)
result_gsva_Tc <- gsva(gsvaPar_Tc, verbose=TRUE, BPPARAM = MulticoreParam(workers = 16, progressbar = TRUE))
end_results_GSVA_Tc <- Sys.time()
gc(T,T,T)
gc(T,T,T)fgseaによるエンリッチメント解析
次にfgsea。正直、escape GSVA ssGSEA2に比べて、名前(fast GSEA)ほど計算が早く無いし、計算を早めようとして並列化するとコンピューターがクラッシュするので、結構嫌いである。しかしながら、もしかしたら色々な値を得ることが出来るので、柔軟なのかもしれない。
このfgseaだが、なんと細胞毎にGSEAを行っていく。ということで、上述の通り出来る限り並列化した方が計算は早く終わる。ここではdoParallelパッケージを使ってなるべくCPUコアを沢山使う。
まずはSeuratオブジェクトThから。
# enrichment 9
# code 104
# prepare geneset for fgsea, hallmark
# geneset_fgsea <- fgsea::gmtPathways("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/c7.all.v2026.1.Hs.symbols.gmt")
geneset_fgsea <- fgsea::gmtPathways("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/msigdb.v2026.1.Hs.symbols.gmt")
# choose workers (physical cores minus one is a good start)
n_workers <- detectCores(logical = FALSE)
# n_workers <- detectCores(logical = FALSE)-1
cl <- makeCluster(n_workers, type = "PSOCK") #FORK #PSOCK
registerDoParallel(cl)
# # prevent thread oversubscription inside workers (optional but recommended)
# clusterEvalQ(cl, {
# Sys.setenv(OMP_NUM_THREADS="1",
# MKL_NUM_THREADS="1",
# OPENBLAS_NUM_THREADS="1",
# RCPP_PARALLEL_NUM_THREADS="1")})
# # prevent thread oversubscription inside workers (optional but recommended)
# # this can also complete calculation.
# # fgsea was able to be run by means of adding environmental variables(su; cd /etc; gedit environment) on the /etc/environment file.
# clusterEvalQ(cl, {
# Sys.setenv(OMP_NUM_THREADS="1",
# OMP_THREAD_LIMIT="1",
# OMP_MAX_ACTIVE_LEVELS="1",
# OMP_DYNAMIC=FALSE,
# MKL_NUM_THREADS="1",
# MKL_DYNAMIC=FALSE,
# OPENBLAS_NUM_THREADS="1",
# GOTO_NUM_THREADS="1" ,
# RCPP_PARALLEL_NUM_THREADS="1")})
start_results_fgsea_Th <- Sys.time()
set.seed(20260725)
result_fgsea_Th <- list()
result_fgsea_Th <- foreach(i = seq_len(ncol(Th_normalized_mat)), .packages = "fgsea", .inorder = TRUE, .verbose = TRUE) %dopar% {
fgsea(pathways = geneset_fgsea,
stats = Th_normalized_mat[, i],
minSize = 10,
maxSize = 500)} # %dopar% %do%
# n <- 100
# result_fgsea <- foreach(i = c(1:n), .packages = "fgsea", .inorder = TRUE, .verbose = TRUE) %dopar% {
# fgsea(pathways = geneset_fgsea,
# stats = analysis_2_t_argu[, i],
# minSize = 10,
# maxSize = 500)} # %dopar% %do%
stopCluster(cl)
rm(cl)
# foreach::registerDoSEQ()
end_results_fgsea_Th <- Sys.time()
# names(result_fgsea) <- colnames(analysis_2_t_argu[, 1:n])
names(result_fgsea_Th) <- colnames(Th_normalized_mat)
gc(T,T,T)
gc(T,T,T)得られた結果をデータフレームにまとめる。使用するのはNES(Normalized Enrichment Score)と書かれたデータフレームである。
# enrichment 10
# code 105
# Extract results of fgsea, foreach, hallmark
result_fgsea_ES_Th <- data.frame()
result_fgsea_NES_Th <- data.frame()
result_fgsea_padj_Th <- data.frame()
for(i in 1:length(result_fgsea_Th)){
result_fgsea_ES_Th[1:nrow(result_fgsea_Th[[i]]),i] <- data.frame(result_fgsea_Th[[i]]$ES)
result_fgsea_NES_Th[1:nrow(result_fgsea_Th[[i]]),i] <- data.frame(result_fgsea_Th[[i]]$NES)
result_fgsea_padj_Th[1:nrow(result_fgsea_Th[[i]]),i] <- data.frame(result_fgsea_Th[[i]]$padj)
}
colnames(result_fgsea_ES_Th) <- colnames(Th_normalized_mat)
rownames(result_fgsea_ES_Th) <- result_fgsea_Th[[1]]$pathway # any component can be used for rownames() because gene set name in all components is same.
colnames(result_fgsea_NES_Th) <- colnames(Th_normalized_mat)
rownames(result_fgsea_NES_Th) <- result_fgsea_Th[[1]]$pathway # any component can be used for rownames() because gene set name in all components is same.
colnames(result_fgsea_padj_Th) <- colnames(Th_normalized_mat)
rownames(result_fgsea_padj_Th) <- result_fgsea_Th[[1]]$pathway # any component can be used for rownames() because gene set name in all components is same.
gc(T,T,T)
gc(T,T,T)次にSeuratオブジェクトTc。Thと同じ用に計算する。
# enrichment 11
# code 104
# prepare geneset for fgsea, hallmark
# geneset_fgsea <- fgsea::gmtPathways("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/c7.all.v2026.1.Hs.symbols.gmt")
geneset_fgsea <- fgsea::gmtPathways("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/msigdb.v2026.1.Hs.symbols.gmt")
# From chatGPT
# choose workers (physical cores minus one is a good start)
n_workers <- detectCores(logical = FALSE)
# n_workers <- detectCores(logical = FALSE)-1
cl <- makeCluster(n_workers, type = "PSOCK") #FORK #PSOCK
registerDoParallel(cl)
# # prevent thread oversubscription inside workers (optional but recommended)
# clusterEvalQ(cl, {
# Sys.setenv(OMP_NUM_THREADS="1",
# MKL_NUM_THREADS="1",
# OPENBLAS_NUM_THREADS="1",
# RCPP_PARALLEL_NUM_THREADS="1")})
# # prevent thread oversubscription inside workers (optional but recommended)
# # this can also complete calculation.
# # fgsea was able to be run by means of adding environmental variables(su; cd /etc; gedit environment) on the /etc/environment file.
# clusterEvalQ(cl, {
# Sys.setenv(OMP_NUM_THREADS="1",
# OMP_THREAD_LIMIT="1",
# OMP_MAX_ACTIVE_LEVELS="1",
# OMP_DYNAMIC=FALSE,
# MKL_NUM_THREADS="1",
# MKL_DYNAMIC=FALSE,
# OPENBLAS_NUM_THREADS="1",
# GOTO_NUM_THREADS="1" ,
# RCPP_PARALLEL_NUM_THREADS="1")})
start_results_fgsea_Tc <- Sys.time()
set.seed(20260725)
result_fgsea_Tc <- list()
result_fgsea_Tc <- foreach(i = seq_len(ncol(Tc_normalized_mat)), .packages = "fgsea", .inorder = TRUE, .verbose = TRUE) %dopar% {
fgsea(pathway = geneset_fgsea,
stats = Tc_normalized_mat[, i],
minSize = 10,
maxSize = 500)} # %dopar% %do%
# n <- 100
# result_fgsea <- foreach(i = c(1:n), .packages = "fgsea", .inorder = TRUE, .verbose = TRUE) %dopar% {
# fgsea(paTcways = geneset_fgsea,
# stats = analysis_2_t_argu[, i],
# minSize = 10,
# maxSize = 500)} # %dopar% %do%
stopCluster(cl)
rm(cl)
# foreach::registerDoSEQ()
end_results_fgsea_Tc <- Sys.time()
# names(result_fgsea) <- colnames(analysis_2_t_argu[, 1:n])
names(result_fgsea_Tc) <- colnames(Tc_normalized_mat)
gc(T,T,T)
gc(T,T,T)必要な出力をデータフレームにまとめる。
# enrichment 12
# code 105
# Extract results of fgsea, foreach, hallmark
result_fgsea_ES_Tc <- data.frame()
result_fgsea_NES_Tc <- data.frame()
result_fgsea_padj_Tc <- data.frame()
for(i in 1:length(result_fgsea_Tc)){
result_fgsea_ES_Tc[1:nrow(result_fgsea_Tc[[i]]),i] <- data.frame(result_fgsea_Tc[[i]]$ES)
result_fgsea_NES_Tc[1:nrow(result_fgsea_Tc[[i]]),i] <- data.frame(result_fgsea_Tc[[i]]$NES)
result_fgsea_padj_Tc[1:nrow(result_fgsea_Tc[[i]]),i] <- data.frame(result_fgsea_Tc[[i]]$padj)
}
colnames(result_fgsea_ES_Tc) <- colnames(Tc_normalized_mat)
rownames(result_fgsea_ES_Tc) <- result_fgsea_Tc[[1]]$pathway # any component can be used for rownames() because gene set name in all components is same.
colnames(result_fgsea_NES_Tc) <- colnames(Tc_normalized_mat)
rownames(result_fgsea_NES_Tc) <- result_fgsea_Tc[[1]]$pathway # any component can be used for rownames() because gene set name in all components is same.
colnames(result_fgsea_padj_Tc) <- colnames(Tc_normalized_mat)
rownames(result_fgsea_padj_Tc) <- result_fgsea_Tc[[1]]$pathway # any component can be used for rownames() because gene set name in all components is same.
gc(T,T,T)
gc(T,T,T)ssGSEA2によるエンリッチメント解析
Pseudobulkingの解析ではこれがベストと思う。他のパッケージと違い、使用したシグナル経路全部のエンリッチメントスコアの詳細が、個別のファイルで出力され、その中にはシグナル経路を構成する各遺伝子の値も含まれる。ということで、Leading edge geneを見出すことが出来る。つまり、各クラスターに、例えば、IFNG-high-Tcのような名前を付けることが出来る。
しかしながら、動作があまり安定じゃあないように感じるし、計算もかなり遅く、計算の並列化もあまりコントロールできないので、下手するとクラッシュする。とにかく大きなカウントマトリックスを計算しようとすると間違いなくメモリリークでRstudioとPCがクラッシュする。余談だが、これを予防するためにコンピューターのSimultaneous Multi-Threading(SMT;intelで言えばHyper Threading)をBIOSでオフにしている。
また、ssGSEA2は、現在居るディレクトリに結果を出力するので、ここを変えながら解析を進めないと、同じシグナル経路名のファイルでどんどん上書きされていく。だから、まずは元のディレクトリ名をgetwd()で取得しておき、一つの解析が終わったらそれに戻るようにする。
# enrichment 13
original_path <- getwd()次に、GCTファイルを作成する。
# enrichment 14
# code 99
## Prepare GCT file
Th_normalized_ssGSEA2 <- Th_normalized %>% rownames_to_column(var = "gene_id")
header <- "#1.2"
number_gene <- nrow(Th_normalized_ssGSEA2) # 2413 genes
number_case <- ncol(Th_normalized_ssGSEA2)-1 # 8 cases
file.remove("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_normalized_ssGSEA2.gct")
cat(header,"\n", file = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_normalized_ssGSEA2.gct")
cat(number_gene,"\t",number_case,"\n", file = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_normalized_ssGSEA2.gct", append = TRUE)
write_tsv(Th_normalized_ssGSEA2, "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_normalized_ssGSEA2.gct",
col_names = TRUE,
append = TRUE)上述した通り、ssGSEA2は計算結果をシグナル経路毎にファイルに出力する。そしてディレクトリはカレントディレクトリになる。たしか、run_ssGSEA2()の引数output.directoryで出力するディレクトリを指定できるが、それは正しく動いた試しがない。だから、カレントディレクトリを変更することで出力を保存する。
計算時間は結構ながいが、カウントマトリックスとして8列x2413行で、MsigDBに登録のあるヒトのシグナル経路全部を使っても30分くらいであり、これくらいなら全く問題なく許容範囲と言える。これが終わったら指定したディレクトリに解析結果が沢山できるので、それを使って各クラスター毎にleading edge geneを解析し、それをマーカー遺伝子とみなせば良い。
計算が終わったら、元のディレクトリにパスを直しておく。
# enrichment 15
file.remove("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/signature_gct_Th_normalized_ssGSEA2")
dir.create("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/signature_gct_Th_normalized_ssGSEA2")
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/signature_gct_Th_normalized_ssGSEA2")
getwd()
start_results_ssGSEA2_Th_NES <- Sys.time()
set.seed(20260725)
# Following is for All gene sets.
results_ssGSEA2_Th_NES <- run_ssGSEA2(input.ds = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_normalized_ssGSEA2.gct",
output.prefix = "NES_",
gene.set.databases = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/msigdb.v2026.1.Hs.symbols.gmt",
sample.norm.type = "none",
weight = 0.75,
correl.type = "rank",
statistic = "area.under.RES",
output.score.type = "NES",
nperm = 1000,
min.overlap = 10,
extended.output = TRUE,
par = 16,
spare.cores = 0,
global.fdr = FALSE,
param.file=TRUE,
log.file='run.log_NES')
# # Following is for C7 gene sets.
# results_ssGSEA2_Th_NES <- run_ssGSEA2(input.ds = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Th_normalized_ssGSEA2.gct",
# output.prefix = "NES_",
# gene.set.databases = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/c7.all.v2026.1.Hs.symbols.gmt",
# sample.norm.type = "none",
# weight = 0.75,
# correl.type = "rank",
# statistic = "area.under.RES",
# output.score.type = "NES",
# nperm = 1000,
# min.overlap = 10,
# extended.output = TRUE,
# par = 16,
# spare.cores = 0,
# global.fdr = FALSE,
# param.file=TRUE,
# log.file='run.log_NES')
#
# file.rename(from = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/signature_gct",
# to = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/signature_gct_Th_normalized_ssGSEA2")
end_results_ssGSEA2_Th_NES <- Sys.time() # Time difference of 33.44445 mins
gc()
gc()
end_results_ssGSEA2_Th_NES - start_results_ssGSEA2_Th_NES
setwd(original_path)同様の計算をTcに対しても行う。以下はGCTファイルの作成。
# enrichment 16
## Prepare GCT file
Tc_normalized_ssGSEA2 <- Tc_normalized %>% rownames_to_column(var = "gene_id")
header <- "#1.2"
number_gene <- nrow(Tc_normalized_ssGSEA2) # 2413 genes
number_case <- ncol(Tc_normalized_ssGSEA2)-1 # 13 cases
file.remove("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_normalized_ssGSEA2.gct")
cat(header,"\n", file = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_normalized_ssGSEA2.gct")
cat(number_gene,"\t",number_case,"\n", file = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_normalized_ssGSEA2.gct", append = TRUE)
write_tsv(Tc_normalized_ssGSEA2, "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_normalized_ssGSEA2.gct",
col_names = TRUE,
append = TRUE)Tcに対しssGSEA2を行う。ここでも、計算が終わったら、元のディレクトリにパスを直しておく。
# enrichment 17
file.remove("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/signature_gct_Tc_normalized_ssGSEA2")
dir.create("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/signature_gct_Tc_normalized_ssGSEA2")
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/signature_gct_Tc_normalized_ssGSEA2")
getwd()
start_results_ssGSEA2_Tc_NES <- Sys.time()
set.seed(20260725)
# Following is for All gene sets.
results_ssGSEA2_Tc_NES <- run_ssGSEA2(input.ds = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/Tc_normalized_ssGSEA2.gct",
output.prefix = "NES_",
gene.set.databases = "/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/MsigDB/msigdb.v2026.1.Hs.symbols.gmt",
sample.norm.type = "none",
weight = 0.75,
correl.type = "rank",
statistic = "area.under.RES",
output.score.type = "NES",
nperm = 1000,
min.overlap = 10,
extended.output = TRUE,
par = 16,
spare.cores = 0,
global.fdr = FALSE,
param.file=TRUE,
log.file='Tc_run.log_NES')
end_results_ssGSEA2_Tc_NES <- Sys.time() # Time difference of 33.44445 mins
gc()
gc()
end_results_ssGSEA2_Tc_NES - start_results_ssGSEA2_Tc_NES
setwd(original_path)これらが終わったら、一旦結果を保存しておく。
# enrichment 18
## 2026 08 09
save.image("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/PRJNA976204_seurat_pseudobulk_cellchat_nichenetr_slingshot_tradeseq.RData")Cellchat、nichenetr、CellPhoneDB、Liana+による細胞-細胞コミュニケーション解析
細胞-細胞コミュニケーション(Cell-Cell Communication; CCC)を解析する。代表的な細胞-細胞コミュニケーションの解析パッケージはRのCellChat、とPythonのCellphoneDBであろう。さらに、ちょっと癖が強いがnichenetrもある。ただしこれは、着目する遺伝子がはっきりしているとき、例えば、群間の遺伝子発現量を比較して、発現量に統計的有意差がある遺伝子がわかっているときなどは明らかに有用であり、それが無い今回の解析のような場合は正直微妙である。着目する遺伝子は群間に有意差があるもの以外でも良いが、逆に何も定義が無い場合はなかなか難しい。個人的に優秀と思うのがLianaというRのパッケージで、このパッケージはCellChat、CellphoneDBとか、そのあたりで使っているアノテーションも使って、総合的なスコアを出してくれる。最近ではこれもLiana+にバージョンアップしていた。一般的に、細胞-細胞コミュニケーションの解析は、複数のパッケージを使うことでその一般性を確認したほうが良い。その理由は、各パッケージでアノテーションに使用するリガンド-レセプターのペアの種類と数が定まっておらず、かつ、スコアも計算方法も違うためである。だから、パッケージ毎に同じ結果を得るのは難しいわけだが、だからといって一つのパッケージを使ったときの結果だけを用いて解釈して次に進むのは、少し危ないということらしい。この状況で複数のパッケージを使って似たようなリガンド-レセプターペアが拾ってこれたならば、それらやそのシグナル経路が細胞-細胞間コミュニケーションに強く関与するだろう、と言えそうである。
ここでは、CellChat、nichenetr、CellphoneDB、そしてLiana+の方法を述べる。
CellChatによる細胞-細胞コミュニケーション解析
まずはCellChatより解析してみる。インストラクションに書いてあることをそのままやっただけなので、使っている変数名とかが少しわかりにくいかもしれない。
論文は、これ(https://www.nature.com/articles/s41467-021-21246-9)とこれ(https://www.nature.com/articles/s41596-024-01045-4)。前者はCellChatの概要と計算方法、後者は手順が書いてある。手順を参考にすれば、解析できる。解析方法についてはGithub(https://github.com/jinworks/CellChat)が良いと思う。前者の論文に関してだが、正直、あまり良くない。もっと計算方法をちゃんと書いたほうが良いと思う。読んだけど、computeNetSimilarity()の計算方法の説明で、使っている項の説明が一つ抜けていて、良く分からなかった。ソースコードを読み解けということだろうか。
CellChatでは、コード# h5ad to SeuratObject 5でsctransformmにより正規化したカウントマトリックスを用いる。それを使って、cellchatオブジェクトを作成する。まず、必要なデータをseuratオブジェクトconcat_sctransformから拾ってくる。必要なのはsctransformで正規化したカウントマトリックスconcat_sctransform@assays$SCT@dataとmeta.dataである。ベクトルcell.use_concatに、細胞名を入れておく。
# CellChat 1
# concat_sctransform@assays$SCT@counts
# concat_sctransform@assays$SCT@data
data_input_concat = concat_sctransform@assays$SCT@data
# data_input_concat = normalizeData(data_input_concat)
meta_concat = concat@meta.data
cell.use_concat = rownames(meta_concat)
data_input_concat = data_input_concat[, cell.use_concat]
meta_concat = meta_concat[cell.use_concat, ]データフレームdata_input_concat、meta_concatをcreateCellChat()に入れて、CellChatオブジェクトを作成する。
# CellChat 2
cellchat_concat <- createCellChat(object = data_input_concat, meta = meta_concat, group.by = "celltype_2")addMeta()で各種ラベルが保存されているメタデータをいれ、setIdent()で主に使用していくラベルをセットする。ここでは細胞間のコミュニケーションが知りたいわけなので、最終的に細胞タイピングの結果を保持しているcelltype_2を入れる。次にlevels()でcelltype_2の表示する順番を固定し、そして、そのcelltype_2の各ラベルの個数、つまり各細胞の細胞数を取得し、ベクトルgroupSize_concatに入れる。
# CellChat 3
cellchat_concat <- addMeta(cellchat_concat, meta = meta_concat)
cellchat_concat <- setIdent(cellchat_concat, ident.use = "celltype_2") # set "labels" as default cell identity
levels(cellchat_concat@idents) # show factor levels of the cell labels
groupSize_concat <- as.numeric(table(cellchat_concat@idents)) # number of cells in each cell groupここで、CellChatで使用するリガンドとレセプターのペアの情報を取得する。ヒトの場合はCellChatDB.human、マウスの場合はCellChatDB.mouseをリストCellChatDBとして入れる。showDatabaseCategory()でどのようなカテゴリーのリガンド-レセプターペアがあるのかを見ることができる。
# CellChat 4
CellChatDB <- CellChatDB.human # use CellChatDB.mouse if running on mouse data
showDatabaseCategory(CellChatDB)subsetDB()で”Secreted Signaling”のリガンド-レセプターペアを拾ってきて、リストCellChatDB.useとする。
# CellChat 5
# Show the structure of the database
dplyr::glimpse(CellChatDB$interaction)
#> Rows: 1,939
#> Columns: 11
#> $ interaction_name <chr> "TGFB1_TGFBR1_TGFBR2", "TGFB2_TGFBR1_TGFBR2", "TGFB…
#> $ pathway_name <chr> "TGFb", "TGFb", "TGFb", "TGFb", "TGFb", "TGFb", "TG…
#> $ ligand <chr> "TGFB1", "TGFB2", "TGFB3", "TGFB1", "TGFB1", "TGFB2…
#> $ receptor <chr> "TGFbR1_R2", "TGFbR1_R2", "TGFbR1_R2", "ACVR1B_TGFb…
#> $ agonist <chr> "TGFb agonist", "TGFb agonist", "TGFb agonist", "TG…
#> $ antagonist <chr> "TGFb antagonist", "TGFb antagonist", "TGFb antagon…
#> $ co_A_receptor <chr> "", "", "", "", "", "", "", "", "", "", "", "", "",…
#> $ co_I_receptor <chr> "TGFb inhibition receptor", "TGFb inhibition recept…
#> $ evidence <chr> "KEGG: hsa04350", "KEGG: hsa04350", "KEGG: hsa04350…
#> $ annotation <chr> "Secreted Signaling", "Secreted Signaling", "Secret…
#> $ interaction_name_2 <chr> "TGFB1 - (TGFBR1+TGFBR2)", "TGFB2 - (TGFBR1+TGFBR2)…
# use a subset of CellChatDB for cell-cell communication analysis
CellChatDB.use <- subsetDB(CellChatDB, search = "Secreted Signaling", key = "annotation")# use c("Secreted Signaling", "Cell-Cell Contact", "ECM-Receptor")
# CellChatDB.use <- CellChatDB
# use all CellChatDB for cell-cell communication analysis
# CellChatDB.use <- CellChatDB # simply use the default CellChatDB
# set the used database in the object
# cellchat@DB <- CellChatDB.useリストCellChatDB.useを対象となるカウントマトリックスとメタデータからなるcellchatオブジェクトのDBスロット(というかは知らん)に入れる。
# CellChat 6
cellchat_concat@DB <- CellChatDB.useマニュアルによれば、subsetData()によりcomputation costを下げるために(計算を早く終わらせるってことだろう)リストCellChatDB.useに入っている遺伝子をcellchatオブジェクトから拾ってくる。
続いて、発現量の多い遺伝子を解析し、されらにその結果を使って相互作用が強そうな遺伝子を拾ってくる。ここでは、マルチコア使用する。
# CellChat 7
# subset the expression data of signaling genes for saving computation cost
cellchat_concat <- CellChat::subsetData(cellchat_concat) # This step is necessary even if using the whole database
future::plan("multicore", workers = 16) # do parallel
#> Warning: Strategy 'multiprocess' is deprecated in future (>= 1.20.0). Instead,
#> explicitly specify either 'multisession' or 'multicore'. In the current R
#> session, 'multiprocess' equals 'multisession'.
#> Warning in supportsMulticoreAndRStudio(...): [ONE-TIME WARNING] Forked
#> processing ('multicore') is not supported when running R from RStudio
#> because it is considered unstable. For more details, how to control forked
#> processing or not, and how to silence this warning in future R sessions, see ?
#> parallelly::supportsMulticore
cellchat_concat <- identifyOverExpressedGenes(cellchat_concat)
cellchat_concat <- identifyOverExpressedInteractions(cellchat_concat)
# project gene expression data onto PPI (Optional: when running it, USER should set `raw.use = FALSE` in the function `computeCommunProb()` in order to use the projected data)
# cellchat <- projectData(cellchat, PPI.human)次に、それらのタンパク質-タンパク質相互作用(Protein-Protein Interaction; PPI)はどのくらいなのかを計算するらしい。そして、それらの相互作用をする細胞数が少ない場合、filterCommunication()でそれらの細胞を除くようだ。インストラクションの通り、min..cells=10にした。このfilterCommunication()で、ノイズのようなリガンド-レセプターペアは除くことができるはずなので、生物学的に有意なのかどうかを判断するためにはここは重要と思う。
# CellChat 8
cellchat_concat <- computeCommunProb(cellchat_concat)
#> triMean is used for calculating the average gene expression per cell group.
#> [1] ">>> Run CellChat on sc/snRNA-seq data <<< [2022-11-26 08:34:38]"
#> [1] ">>> CellChat inference is done. Parameter values are stored in `object@options$parameter` <<< [2022-11-26 08:35:36]"
# Filter out the cell-cell communication if there are only few number of cells in certain cell groups
cellchat_concat <- filterCommunication(cellchat_concat, min.cells = 10)推測されたリガンド-レセプターペアから、それらがどのシグナル経路に属するかを計算する。
# CellChat 9
cellchat_concat <- computeCommunProbPathway(cellchat_concat)それらを細胞-細胞間コミュニケーションを集計する。
# CellChat 10
cellchat_concat <- aggregateNet(cellchat_concat)そして、あの見覚えのあるサークルプロットを出力する。しかしながら、これだけ見ていてもなんのこっちゃ全然わからん。こんなものは聴衆を煙に巻くだけの画像である。
# CellChat 11
groupSize_concat <- as.numeric(table(cellchat_concat@idents))
par(mfrow = c(1,2), xpd=TRUE)
netVisual_circle(cellchat_concat@net$count, vertex.weight = groupSize_concat, weight.scale = T, label.edge= F, title.name = "Number of interactions")
netVisual_circle(cellchat_concat@net$weight, vertex.weight = groupSize_concat, weight.scale = T, label.edge= F, title.name = "Interaction weights/strength")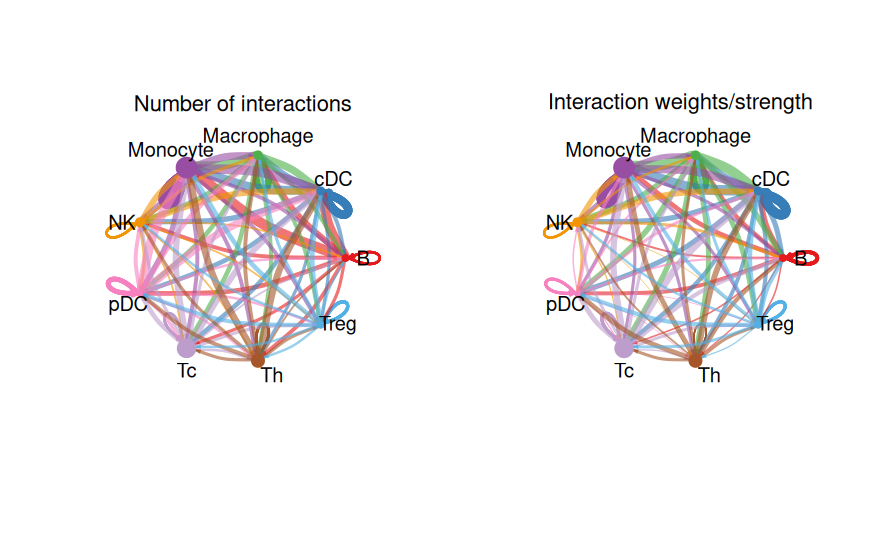
タイピングにより得られた各細胞種にそれぞれ着目し、サークルプロットを出力する。これは上記よりはマシって感じである。
# CellChat 12
mat_concat <- cellchat_concat@net$weight
par(mfrow = c(1,2), xpd=TRUE)
for (i in 1:nrow(mat_concat)) {
mat2_concat <- matrix(0, nrow = nrow(mat_concat), ncol = ncol(mat_concat), dimnames = dimnames(mat_concat))
mat2_concat[i, ] <- mat_concat[i, ]
netVisual_circle(mat2_concat, vertex.weight = groupSize_concat, weight.scale = T, edge.weight.max = max(mat_concat), title.name = rownames(mat_concat)[i])
}特定の遺伝子に着目して細胞-細胞間コミュニケーションを可視化してみる。ベクトルpathways.show_concatに見たい分子名を入れ、それを使って表示する。これらは、cellchat_concat@netP$pathwaysに入っている。なお、もし入力した分子がここに入っていなかったら、それは表示できない。
# CellChat 13
pathways.show_concat <- c("CD40")
# Hierarchy plot
# Here we define `vertex.receive` so that the left portion of the hierarchy plot shows signaling to fibroblast and the right portion shows signaling to immune cells
vertex.receiver_concat = seq(1,4) # a numeric vector.
netVisual_aggregate(cellchat_concat, signaling = pathways.show_concat, vertex.receiver = vertex.receiver_concat)
# Circle plot
par(mfrow=c(1,1))
netVisual_aggregate(cellchat_concat, signaling = pathways.show_concat, layout = "circle")同様の値を、表示方法を変える。
# CellChat 14
# Chord diagram
par(mfrow=c(1,1))
netVisual_aggregate(cellchat_concat, signaling = pathways.show_concat, layout = "chord")これも上記と同様だが、netVisual()によりほしい図を外部に出力、保存できる。それによりCellChat 13におけるサークルプロットと、それを2次元に展開した図(layout = “hierarchy”とした場合の結果)を保存する。また、着目するシグナリングのうち、具体的にどのリガンド-レセプターペアの寄与が大きいのかをnetAnalysis_contribution()で示すことができる。一つのレセプターに複数のリガンドが結合する(かもしれない)場合、その内約が示されている。言うても、結局発現量以上の値は無いわけで、ここで色々と示したところで、最終的に各クラスター(タイピングの結果命名された細胞名)における発現量をバイオリンプロットで示す羽目には鳴ると思うので、これらは参考データにしかならんとは思う。上手いこと結果の説明に使用するのが関の山って感じである。重要なのはここで見つかった遺伝子の正規化したカウント値である。
# CellChat 15
# Access all the signaling pathways showing significant communications
pathways.show.all_concat <- cellchat_concat@netP$pathways
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_cellchat")
# check the order of cell identity to set suitable vertex.receiver
levels(cellchat_concat@idents)
vertex.receiver = seq(1,length(pathways.show.all_concat))
for (i in 1:length(pathways.show.all_concat)) {
# Visualize communication network associated with both signaling pathway and individual L-R pairs
#
netVisual(cellchat_concat, signaling = pathways.show.all_concat[i], vertex.receiver = vertex.receiver_concat, layout = "circle")
#
netVisual(cellchat_concat, signaling = pathways.show.all_concat[i], vertex.receiver = vertex.receiver_concat, layout = "hierarchy")
# Compute and visualize the contribution of each ligand-receptor pair to the overall signaling pathway
gg_concat <- netAnalysis_contribution(cellchat_concat, signaling = pathways.show.all_concat[i])
ggsave(filename=paste0(pathways.show.all_concat[i], "_L-R_contribution_concat.pdf"), plot=gg_concat, width = 3, height = 2, units = 'in', dpi = 300)
}
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/")発現量に基づくリガンド-レセプターペアの相互作用の強さをヒートマップ(どちらかといえばドット)で示す。個人的には上記のサークルプロットよりもこちらの方が重要と思う。結局、この結果を印刷して、定規とペンで相互作用の強そうなシグナリングを探していく、という作業が全体的に見回せるので良かった。ここの結果を見て、何かしら有意そうな細胞-細胞間コミュニケーションがあれば、上記のサークルプロットで示すという方法が良いと思う。
# CellChat 16
# show all the significant interactions (L-R pairs) from some cell groups (defined by 'sources.use') to other cell groups (defined by 'targets.use')
cellchat_concat_bubbleplot <- netVisual_bubble(cellchat_concat,
sources.use = c(1:10),
targets.use = c(1:10),
font.size = 8,
font.size.title = 8,
remove.isolate = TRUE)
#> Comparing communications on a single object
cellchat_concat_bubbleplot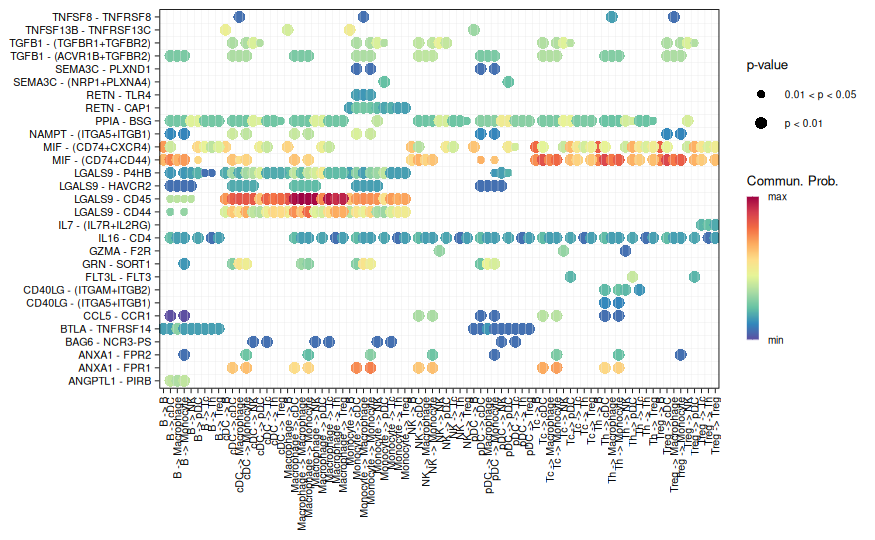
細胞毎の関係性を示す。説明がややこしので、論文ではほぼ使い物にならないのではないだろうか。急にCentralityとか言われても、何だそれとなるに決まっているし、唯でさえ文字制限で厳しいのにそんなのを説明するスペースは無いような気がする。また、どの細胞かsenderかrecieverかを同定するのは、何か特定のシグナリングが特定できたあとの話なのでは無いかと思う。もし特定のシグナル経路に関してsenderとrecieverが知りたいときは、netAnalysis_signalingRole_network()の引数signalingに見たいシグナル経路を入れれば良い。もちろんこれは結果として得られているシグナル経路に限る。
# CellChat 17
pathways.show_concat <- c("CD40")
cellchat_concat <- netAnalysis_computeCentrality(cellchat_concat, slot.name = "netP") # the slot 'netP' means the inferred intercellular communication network of signaling pathways
# Visualize the computed centrality scores using heatmap, allowing ready identification of major signaling roles of cell groups
netAnalysis_signalingRole_network(cellchat_concat, signaling = pathways.show_concat, width = 8, height = 2.5, font.size = 10)同様に、各細胞から出ている、入ってくるシグナル経路の強さを、netAnalysis_signalingRole_scatter()で二次元の散布図で表示する。引数signalingがNULLの場合は、全シグナルを集計した場合として表示される。もし何か特定のシグナリングに着目するときは、そこに文字列のベクトルで入れる。
# CellChat 18
# Signaling role analysis on the aggregated cell-cell communication network from all signaling pathways
gg1_concat <- netAnalysis_signalingRole_scatter(cellchat_concat)
#> Signaling role analysis on the aggregated cell-cell communication network from all signaling pathways
# Signaling role analysis on the cell-cell communication networks of interest
gg2_concat <- netAnalysis_signalingRole_scatter(cellchat_concat, signaling = c("CD40", "CCL"))
#> Signaling role analysis on the cell-cell communication network from user's input
gg1_concat + gg2_concatシグナル全体の強度を、リガンド側、レセプター側として各細胞毎に可視化する。これも、引数signalingに見たいシグナル経路をベクトルとして入れることができる。シグナル全体は意味がわからんので、特定のシグナルに限定して表示する必要があると言える。
# CellChat 19
# Signaling role analysis on the aggregated cell-cell communication network from all signaling pathways
ht1_concat <- netAnalysis_signalingRole_heatmap(cellchat_concat, pattern = "outgoing",width = 6, height = 6)
ht2_concat <- netAnalysis_signalingRole_heatmap(cellchat_concat, pattern = "incoming",width = 6, height = 6)
ht1_concat + ht2_concatどの細胞においてどのシグナリング経路の寄与が大きいかどうかを、比負値行列因子分解(NMF; Non-negative Matrix Factorization)し、どの細胞でどのシグナル経路の寄与が大きいかを可視化する。これにより、行と列(細胞名と遺伝子名)でカウント値をクラスタリングし、どのクラスターにどの細胞(行)が、そしてその細胞がどのような遺伝子(列)で構成されるか、ということを評価する。見方がわかるとけっこう有用であることがわかる。
まずはselectK()で最適なクラスターの数を求める。ここではパターンと言っている。selectK()によりcophenetic係数とsilhouette値が算出されるが、これらはNMFのコンセンサス行列の安定性を示すらしい。コンセンサス行列とは、クラスター数を増やして行った結果、各点の値が同じクラスターに分類される確率を示す行列らしい。cophenetic係数とsilhouette値が1に近ければ、そのクラスタリングの結果が安定しているということらしい。分けるクラスター数を2から増やして行って、cophenetic係数とsilhouette値の値が急に落ちると、その安定性が下がった、つまり、ある値が同じクラスターに分類されなくなってきたということなので、その落ちる手前が最適なクラスター数(同じ値が同じクラスターに分類される最大のクラスター数)ということになるようだ。イキっていると思われるから詳しく説明するのはやめておくわ。知りたいならばgoogleかchatGPTに聞いたほうが詳しく教えてくれる。インストラクション(https://htmlpreview.github.io/?https://github.com/jinworks/CellChat/blob/master/tutorial/CellChat-vignette.html)では、cophenetic係数が急に落ちるところを最適なクラスター数として選択しており、そのときのsilhouette値を確認する、ということを行っているようだ。
そういうことで、selectK()を実行し、cophenetic係数とsilhouette値を算出する。
# CellChat 20
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_cellchat/concat")
selectK(cellchat_concat, pattern = "outgoing")
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/")cophenetic係数が7で急に低下したので、ここではクラスター数を6とする。pattern=”outgoing”なので、ここではリガンドを使ったクラスタリングけ結果を示す。遺伝子側がシグナル経路になっている。確かに、そちらのほうが全体を包括しているのか…だとしたら、outgoing(リガンド)とincoming(レセプター)の区別をした意味が微妙な気がするが。
# CellChat 21
nPatterns = 6
cellchat_concat <- identifyCommunicationPatterns(cellchat_concat, pattern = "outgoing", k = nPatterns)その結果を示す。これはあまりわかりやすくない。どの細胞にどの遺伝子(シグナル経路)が大きく影響するのかを示す。
# CellChat 22
# river plot
netAnalysis_river(cellchat_concat, pattern = "outgoing")
#> Please make sure you have load `library(ggalluvial)` when running this functionその結果をドットプロットで示す。これも、上記と示している情報が同じ。ただし、上記のリバープロットよりはわかりやすい。
# CellChat 23
# dot plot
netAnalysis_dot(cellchat_concat, pattern = "outgoing")次にはpattern=”incoming”にして最適と思われるクラスター数を求める。
# CellChat 24
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_cellchat/concat")
selectK(cellchat_concat, pattern = "incoming")
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/")ヒートマップ。
# CellChat 25
nPatterns = 8
cellchat_concat <- identifyCommunicationPatterns(cellchat_concat, pattern = "incoming", k = nPatterns)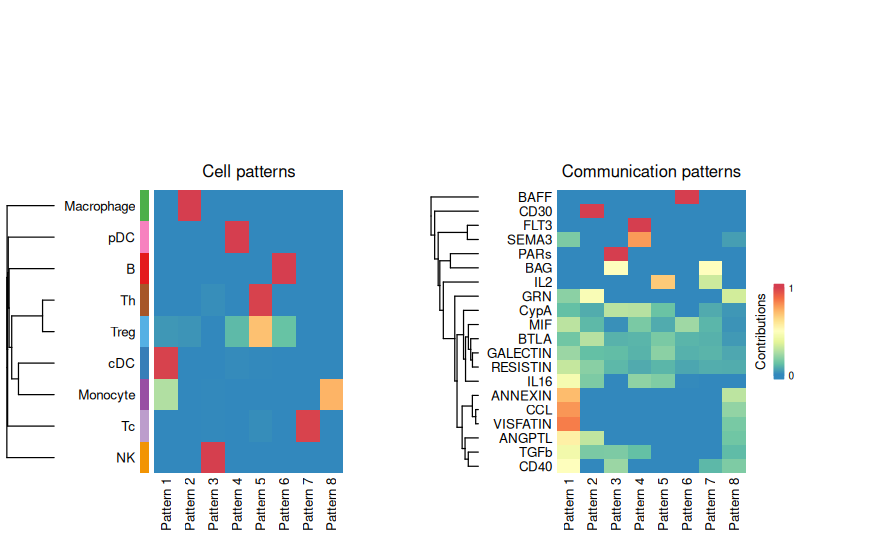
どの細胞がどのシグナル経路(レセプター側)に影響を受けているかを、関連させる。
# CellChat 26
# river plot
netAnalysis_river(cellchat_concat, pattern = "incoming")
#> Please make sure you have load `library(ggalluvial)` when running this function上記をドットプロットで示す。
# CellChat 27
# dot plot
netAnalysis_dot(cellchat_concat, pattern = "incoming")あるシグナル経路について、SenderとRecieverの細胞が似ているかどうかをグラフで求める。細胞が似ているかどうかで、そのシグナル経路が機能的に似た役割を果たしているかどうかを見るらしい。
# CellChat 28
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_cellchat/concat")
cellchat_concat <- computeNetSimilarity(cellchat_concat, type = "functional")
cellchat_concat <- netEmbedding(cellchat_concat, type = "functional", umap.method = "uwot")
#> Manifold learning of the signaling networks for a single dataset
cellchat_concat <- netClustering(cellchat_concat, type = "functional")
#> Classification learning of the signaling networks for a single dataset
# Visualization in 2D-space
netVisual_embedding(cellchat_concat, type = "functional", label.size = 3.5)
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/")「似た役割を果たしている」と思われるシグナリング毎に着目する。
# CellChat 29
netVisual_embeddingZoomIn(cellchat_concat, type = "functional", nCol = 2)# CellChat 28と29では、type = “functional”として細胞に関してクラスタリングを行ったが、ここではtype = “structural”とすることで、シグナリングに関してクラスタリングしてくれるらしい。
# CellChat 30
options(future.globals.maxSize = 4 * 1024^3)
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_cellchat/concat")
cellchat_concat <- computeNetSimilarity(cellchat_concat, type = "structural")
cellchat_concat <- netEmbedding(cellchat_concat, type = "structural", umap.method = "uwot")
#> Manifold learning of the signaling networks for a single dataset
cellchat_concat <- netClustering(cellchat_concat, type = "structural")
#> Classification learning of the signaling networks for a single dataset
# Visualization in 2D-space
setwd("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/")シグナリングでのクラスタリング結果をクラスター毎に着目して表示する。
# CellChat 31
netVisual_embeddingZoomIn(cellchat_concat, type = "structural", nCol = 2)これでひとまずCellChatは終了。データを保存する。
# CellChat 32
## 2026 07 28
save.image("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/PRJNA976204_seurat_pseudobulk_cellchat_nichenetr_slingshot_tradeseq.RData")h5adオブジェクトからSeuratオブジェクト(V3)への変換
次にnichenetrで細胞-細胞間コミュニケーションを解析したいと思う。しかし、またもフォーマット問題である。nichenetrはSeruratオブジェクトを使用するが、そのバージョンがV3である。2026年9月時点のSeuratオブジェクトのバージョンはV5である。なので、一旦、V3にしてからSeuratオブジェクトを作成する必要がある。
取り掛かる前はめちゃくちゃ面倒くさいが、やってみれば簡単である。まず、options()でSeuratオブジェクトのバージョンをV3に設定し、次にCreateAssayObject()でV3のスパースマトリックスを作成する。それをCreateSeuratObject()に入れて、V3のSeuratオブジェクトにする。次に順次、メタデータ、正規化したカウントマトリックス、UMAPの結果などを入れていけば良い。こうしてV3のSeuratオブジェクトconcat_nichenetrを作成する。
# h5ad to SeuratObject V3 1
# seuratObj@version
# class(seuratObj@assays$RNA$counts) # dgCMatrix; this is raw counts
# class(seuratObj@assays$RNA$data) # dgCMatrix; this is normalized counts
# class(seuratObj@meta.data) # data.frame
# class(seuratObj@reductions)
# seuratObj@reductions
# concat
## Seurat Object
#
options(Seurat.object.assay.version = "v3") # V3 is required for Nichenetr.
assay.v3_raw <- CreateAssayObject(counts = concat_raw_t) # Prepare count matrix to set SeuratObject V3.
concat_nichenetr <- CreateSeuratObject(counts = assay.v3_raw) # Put the count matrix into Seurat object.
concat_nichenetr@assays$RNA$data <- as.sparse(concat_normalize_pearson_t) # Then add normaized count matrix into Seurat object.
# concat@assays$Norm <- CreateAssay5Object(counts = as.sparse(concat_normalize_pearson_t))
## DimReduc
concat_nichenetr@reductions$umap <- CreateDimReducObject(embeddings = concat_umap, assay = "RNA", global = TRUE) # Add value of umap.
## Meta data
concat_nichenetr@meta.data$louvain_1.0 <- concat_obs$louvain_1.0
concat_nichenetr@meta.data$celltype_2 <- concat_obs$celltype_2
concat_nichenetr@meta.data$batch <- concat_obs$batch
Idents(concat_nichenetr) <- "celltype_2"
options(Seurat.object.assay.version = "v5")
concat_nichenetr <- UpdateSeuratObject(concat_nichenetr)nichenetrによる細胞-細胞間コミュニケーション解析
Nichenetrはリガンド-レセプター(のペア)に関するシグナル経路について、色々と解析することができる。しかし、このパッケージは基本的にDEG(Differential expressed gene)解析を行う前提である。今回のように2群以上の比較群が無い場合にNichenetrを使うのは、結果はかなり慎重に解釈する必要が有り、かつ、解析がほとんど無意味に終わる可能性もある。「はじめに」で、例えば薬剤投与群と非投与群のように、何らかの群間比較がないシングルセルRNAにシークエンスには意味がない、ということを書いたが、それはこういう事でもある。タイピングだけが必要だったとしても、それだけでこんな高価なシングルセルRNAシークエンスを行うのは、愚かと思う。言うて、DEGはDEGでしかない、というか、それができている時点でもしかしたら細胞-細胞間コミュニケーションの解析なんか必要ないような気もしてくるので、DEGを前提とするのは、考えてみれば非常に微妙な気はする。また、このNichenetは基本的にはヒト用であることをほのめかす記述もあるので、それを考えてマウスのプロファイルを解析すべきと思う。一方、遺伝子名をマウスとヒトとの間で変換するconvert_human_to_mouse_symbols()とconvert_mouse_to_human_symbols()は、なかなかに重宝する。確か、biomart(https://jun2026.archive.ensembl.org/biomart/martview/3d1c911590f358716337dc27bc9405a0)にはこの機能はないから。
Nichenetは、マニュアル(Vignette)のどこに何が書いてあるのか、どのような順番で読んでいけば良いのかかなりわかりにくいのでしっかりと読まなくてはならない。全体的な流れに関しては、ここ(https://github.com/saeyslab/nichenetr/blob/master/vignettes/seurat_steps.md)の最初の方に書いてあるので、それは一度読んだ方が良いのかもしれない。この記事では、ここ(https://github.com/saeyslab/nichenetr/blob/master/vignettes/seurat_steps.md)に書いてあることに従って、基本的な解析を行うことにする。というか、論文を読んでみたけど、そういうことじゃあないねん。どの関数が一体何をやっていて、その結果どんな値が返ってくるのかをしっかり書いてほしい。一行でちょっとだけ書いてあるけど、そんなんでわかるやつおるんか?
コード# nichenetr 1から7では、自分たちの関心のある遺伝子を、nichenetrのデータセット(Nechenetrで使用するリガンド-レセプターペア、それらの相互作用に関する事前確率をまとめたデータセット、可視化に使うための重み付けされた(事前確率の?)データセット)から拾ってくる。
最初にNechenetrで使用する事前確率のデータセットをダウンロードし、その内容を確認する。ダウンロードへのリンクはここ(https://github.com/saeyslab/nichenet_protocol)のinput fileのところ、もしくはここ(https://zenodo.org/records/7074291)にあるので、必要に応じてダウンロードする。マウス用とヒト用があるので、関心のある方を選ぶ必要がある。この記事で用いているデータセットはヒトの細胞なので、ヒト用のデータベースを選ぶ。lr_network_human_21122021.rdsには、列from、列to、列database、 列sourceで構成されている。それぞれ、リガンド、レセプター、その情報源のようだ。
# nichenetr 1
# Load ligand-receptor relationship at nichenetr.
#
lr_network <- readRDS("/home/kats/nichenetr_network/lr_network_human_21122021.rds")
class(lr_network) # This is tibble type data.frame
view(lr_network)
table(lr_network$database)
## nichenet_verschueren omnipath
## 574 5094
table(lr_network$source)
## nichenet_verschueren omnipath
## 574 5094
#
ligand_target_matrix <- readRDS("/home/kats/nichenetr_network/ligand_target_matrix_nsga2r_final.rds")
class(ligand_target_matrix) # This is matrix
view(ligand_target_matrix[1:100,1:100])
dim(ligand_target_matrix) # [1] 22521 1287
#
weighted_networks <- readRDS("/home/kats/nichenetr_network/weighted_networks_nsga2r_final.rds")
class(weighted_networks) # This is listリガンド-レセプターペアをまとめたデータフレームから、リガンドとレセプター名が重複している値を除く。
# nichenetr 2
# Extract ligand-receptor pairs.
lr_network <- lr_network %>% distinct(from, to)
head(lr_network)
ligand_target_matrix[1:5,1:5]
head(weighted_networks$lr_sig)
head(weighted_networks$gr)この解析では、クラスター間の細胞-細胞間コミュニケーションが知りたい。マッピングされた全遺伝子を使っても良いのだが、各クラスターに特徴的な遺伝子を用いた方が、そのクラスターの特徴をより明確に解析できるはずである。なので、関心のある遺伝子として変動のおおきい遺伝子をベクトルinterest_genesとする。
# nichenetr 3
# Extranct highly variable genes of our dataset.
interest_genes <- rownames(concat_hvgs_wo_MT_RIBO_var)コード# nichenetr 2で作成したデータフレームlr_networkには、列fromにSender側(リガンド側。シグナルを送り出す方)のリガンド(というか、タンパク質。ここには実際は、一般的にはレセプターとして機能しているタンパク質も入っている。例えば、データフレームlr_networkの最初の方の行にあるACE2、)、列toにReceptor側(レセプター側。シグナルを受ける方)にそのリガンドのレセプターとなるタンパク質が入っている。
そのデータフレームlr_networkの列toのレセプター側のタンパク質の重複をunique()で解消し、それをベクトルall_receptorsとする。そのベクトルall_receptorsとコード# nichenetr 2で作成した、自分たちの関心がある遺伝子名(各クラスター毎に発現のばらつきの多い遺伝子名をrownames()で拾ってきて作成したベクトル)を入れたベクトルinterest_genesをintersect()に入れて、自分たちの関心のある遺伝子のうち、nichenetrのデータと一致する遺伝子を抽出し、それをベクトルexpressed_receptorsとする。
# nichenetr 4
## Network
### Receptors
all_receptors <- unique(lr_network$to) # Column "to" in Data frame "lr_network" holds genes as receptor.
expressed_receptors <- intersect(all_receptors, interest_genes) # Extract shared genes between our dataset and receptors at NichenetR.コード# nichenetr 4では、レセプター側の遺伝子を、nichenetr側(ベクトルall_receptors)、自分たちの関心のある遺伝子のうち、nichenetrのデータセットに入っている遺伝子(ベクトルexpressed_receptors)をとして抽出してきた。
コード# nichenetr 5では、自分たちの関心のある遺伝子(ベクトルexpressed_receptors)に対応し、かつ、nichnetrのデータセットに入っているリガンド側の遺伝子を抽出する。
データフレームlr_networkの列toにはレセプター側のタンパク質が入っているが、それと、自分たちの関心がある遺伝子のうちnichenerのデータセットにも入っているレセプターexpressed_receptorsが一致する値を抽出してきて、データフレームpotential_ligandsとする。
# nichenetr 5
### Ligands
potential_ligands <- lr_network %>% filter(to %in% expressed_receptors) # Extract genes that is matched genes of vector "expressed_receptors" そして、データセットpotential_ligandsの列fromの値をpull()をベクトルとして抽出し、それをベクトルpotential_ligandsとする。そしてそのベクトルpotential_ligandsの値から、unique()で重複を解消しておく。
上記のデータフレームpotential_ligandsと変数の名前が一緒なので、良くないコードでもある。だからといって、変数の名前が長くなるのも良くないのだが…これは自分がよくやってしまう。しかし、結局、改めてコードを読んだときにすぐにわかるのが、わかりやすい変数名だったりする。
# nichenetr 6
potential_ligands <- potential_ligands %>% pull(from) # Extract genes of ligands that is matched with genes of vector "expressed_receptors" and then the genes stores as vector "potential_ligands".
potential_ligands <- potential_ligands %>% unique() # remove duplicates.次に、解析対象のオブジェクトから、同定した細胞名(クラスター名)を取得し、それをベクトルsender_celltypesとする。
# nichenetr 7
table(concat_hvgs_wo_MT_RIBO_obs$celltype_2)
sender_celltypes <- c("Monocyte", "Macrophage", "cDC", "pDC", "B", "NK", "Th", "Tc", "Treg") # our cell types.解析対象とする自分たちのオブジェクトから、各クラスターで細胞の5%以上に発現している遺伝子をget_expressed_genes()で取得し、をリストlist_expressed_genes_senderに入れる。このリストlist_expressed_genes_senderの各要素は、ベクトルsender_celltypes、すなわち、scanpyの解析で同定した細胞であり、遺伝子名がベクトルとして入っている。
そのリストlist_expressed_genes_senderをunlist()でベクトルにして、さらにunique()で遺伝子の重複を無くし、それをベクトルexpressed_genes_senderとする。
# nichenetr 8
# Use lapply to get the expressed genes of every sender cell type separately here
list_expressed_genes_sender <- sender_celltypes %>% unique() %>% lapply(get_expressed_genes, concat_nichenetr, pct = 0.05)
expressed_genes_sender <- list_expressed_genes_sender %>% unlist() %>% unique()続いて、intersect()を使ってnichenetrのデータセットにある遺伝子のうち、リガンド側になる可能性のある遺伝子(ベクトルpotential_ligands、コード# nichenetr 5と6で作成)と、上記で作成したベクトルexpressed_genes_senderとで共通する遺伝子を抽出し、それをベクトルpotential_ligands_focusedとする。
ここで、各遺伝子数をlength()で確認しておく。
# nichenetr 9
potential_ligands_focused <- intersect(potential_ligands, expressed_genes_sender) # This is ligands that is expressed in our dataset.
# Also check
length(expressed_genes_sender)
## [1] 13763
length(potential_ligands)
## [1] 673
length(potential_ligands_focused)
## [1] 236nichenetrのリガンド-レセプターの相互作用の事前確率は、マトリックスligand_target_matrixに入っている。そこから、自分たちの解析対象のオブジェクトの全遺伝子と共通する遺伝子を共通した遺伝子をintersect()で抽出して、それをこの解析の全遺伝子とする。それをベクトルbackground_expressed_genesとする。
# nichenetr 10
# Decide backgroup genes.
# ligand_target_matrix <- readRDS("/home/kats/nichenetr_network/ligand_target_matrix_nsga2r_final.rds")
view(ligand_target_matrix[1:100, 1:100])
# rownames(concat_var) # check genes in seurat object "concat".
# background_expressed_genes <- expressed_genes_receiver %>% .[. %in% rownames(ligand_target_matrix)]
background_expressed_genes <- intersect(rownames(concat_var), rownames(ligand_target_matrix))
length(background_expressed_genes)
## [1] 16891
これまで抽出してきた関心のある遺伝子のリガンドの活性をpredict_ligand_activity()で求める。自分たちの着目している遺伝子が、nichenetrの事前確率から考えてどのくらい活性があるのかを返す。以下の表の値を使用する。predict_ligand_activities()の結果をデータフレームligand_activitiesとする。
| 項目 | 説明 |
|---|---|
| 関数 | predict_ligand_activities() |
| 説明 | 関心のある遺伝子セットの発現を調整しているリガンドの活性を予測する(意味不明)。リガンドの活性は、得られた転写反応(自分たちのデータセットの遺伝子発現が)、Nichenetのモデルとよく合うかどうかによって定義される。 |
| 使用方法 | predict_ligand_activities(geneset, background_expressed_genes,ligand_target_matrix, potential_ligands, single = TRUE,...) |
| 引数 | geneset; 相互作用する相手型の細胞から出るリガンドによって影響を受ける可能性のある遺伝子からなる文字列ベクトル。 ここでは、ベクトルpotential_ligands_focusedを使用した。potential_ligands_focusedは、ベクトルpotential_ligands(nichenetrに登録のあるリガンド側の遺伝子で、自分たちの解析対象のオブジェクトに含まれている遺伝子)とベクトルexpressed_genes_sender(自分たちの解析対象となるオブジェクトに含まれている遺伝子)で共通する遺伝子のベクトル。 |
| 引数 | background_expressed_genes; 影響を受けないだろう遺伝子(影響を受けるだろ遺伝子も含めることが可能)全部からなる文字列ベクトル。ここではbackground_expressed_genesを使用した。background_expressed_genesは、Nichenetの事前確率のデータligand_target_matrixにある遺伝子と、自分たちのデータconcatの全遺伝子で共通する遺伝子からなるベクトル。 |
| 引数 | ligand_target_matrix; Nichenetのリガンド-ターゲットマトリックス。ここではマトリックスligand_target_matrixを使用した。ligand_target_matrixは、Nichenetrのリガンドとレセプターの活性を示す事前確率のマトリックス。 |
| 引数 | potential_ligands; 自分たちが評価したい遺伝子の文字列ベクトル。ここでは、ベクトルpotential_ligandsを使用した。 potential_ligandsは、自分たちの解析対象のオブジェクトに含まれている、nichenetrに登録のあるリガンド側の遺伝子から成るベクトル。 |
| 引数 | single; ここはデフォルトのTRUEを使用した。全遺伝子について個々にリガンド活性を計算したい場合、これをTRUEにする(これはTRUE推奨。)もしここがFALSEならば、スコアとしてmulti-ligand classification modelのvariable importanceを計算する(何言っとるん?) |
predict_ligand_activities()の結果、AUROC(Area under Reciever Operator Characteristics)、AUPR(Area under Precision Recall)、補正後のAUPR、Pearsonの相関係数が計算される。その中で補正後のAUPRの値の高い順に並べ、列rankにその高い順に1から番号を振る。補正後のAUPRは全体の遺伝子数と解析対象とする遺伝子数の比で補正したAUPRらしい。よくわからん。
# nichenetr 11
ligand_activities <- predict_ligand_activities(geneset = potential_ligands_focused,
background_expressed_genes = background_expressed_genes,
ligand_target_matrix = ligand_target_matrix,
potential_ligands = potential_ligands)
ligand_activities <- ligand_activities %>% arrange(desc(aupr_corrected))
ligand_activities <- ligand_activities %>% mutate(rank = 1:nrow(ligand_activities))
ligand_activities以下で、補正後のAUPRのヒストグラムを表示する。点線は、データフレームligand_activitiesの列aupr_correctedのトップ30の値のうち、最小の値である。これにより、どのくらいのAUPRの値の遺伝子がどのくらいあるのかがわかる。必要に応じて可視化すれば良いと思う。
ちなみに、マニュアルに載っている図の横軸が「ligand activity (PCC)」ってなっているけど、使っているのの列aupr_correctedなんだが。これ、間違ってない??一応、以下ではlabs(x=”aupr_corrected”, y = “count”)にしてある。多分こちらの方が値を反映しているラベルだとお思う。
# nichenetr 12
p_hist_lig_activity <- ggplot(ligand_activities, aes(x=aupr_corrected)) +
geom_histogram(color="black", fill="darkorange") +
geom_vline(aes(xintercept=min(ligand_activities %>% top_n(30, aupr_corrected) %>% pull(aupr_corrected))),
color="red", linetype="dashed", size=1) +
labs(x="aupr_corrected", y = "count") +
theme_classic()
p_hist_lig_activityデータフレームligand_activitiesの列aupr_correctedのトップ30をその値の高い順にならべて、列test_ligandを取り出し、ベクトルbest_upstream_ligandsとする。これが、リガンド-レセプターペアとしての活性が高い遺伝子になる。
# nichenetr 13
best_upstream_ligands <- ligand_activities %>% top_n(30, aupr_corrected) %>% arrange(-aupr_corrected) %>% pull(test_ligand)そのリガンド-レセプターとしての活性が高い遺伝子を取り出し、ベクトルfeaturesとする。それらはどのクラスターもしくは細胞に高く発現しているか、seuratのFeaturePlot()で可視化してみる。現行のSeuratはバージョン5のSeuratオブジェクトを取り扱うので、options(Seurat.object.assay.version = “v5”)でバージョンを5に直してからFeaturePlot()する。
# nichenetr 14
features <- intersect(rownames(concat_var), best_upstream_ligands)
# Check feature plot
options(Seurat.object.assay.version = "v5")
# for (i in 1:length(features)){
# tryCatch(
# {
# FeaturePlot(concat_nichenetr,
# slot = "data",
# features = features[i],
# raster.dpi = c(512, 512))},
# error = function(e) {print("gene was not found")}
# )
#
# }
FeaturePlot(concat_nichenetr, slot = "data", features = "CSF1")
FeaturePlot(concat_nichenetr, slot = "data", features = "CD58")
FeaturePlot(concat_nichenetr, slot = "data", features = "S100A9")
FeaturePlot(concat_nichenetr, slot = "data", features = "S100A12")
FeaturePlot(concat_nichenetr, slot = "data", features = "CD244")
FeaturePlot(concat_nichenetr, slot = "data", features = "ADAM17")
FeaturePlot(concat_nichenetr, slot = "data", features = "IL1B")
FeaturePlot(concat_nichenetr, slot = "data", features = "BTLA")
FeaturePlot(concat_nichenetr, slot = "data", features = "CXCL10")
FeaturePlot(concat_nichenetr, slot = "data", features = "TNF")
FeaturePlot(concat_nichenetr, slot = "data", features = "SERPINE1")
FeaturePlot(concat_nichenetr, slot = "data", features = "NAMPT")
FeaturePlot(concat_nichenetr, slot = "data", features = "C5")
FeaturePlot(concat_nichenetr, slot = "data", features = "SCT")
FeaturePlot(concat_nichenetr, slot = "data", features = "IFNG")
FeaturePlot(concat_nichenetr, slot = "data", features = "TIMP2")
FeaturePlot(concat_nichenetr, slot = "data", features = "FCER2")
FeaturePlot(concat_nichenetr, slot = "data", features = "S100B")
FeaturePlot(concat_nichenetr, slot = "data", features = "CD40LG")それら補正後のAUPRの高いトップ30の遺伝子とそのaupr_correctedの値(列aupr_corrected)を抽出し、それを値の小さい順から並べ、それマトリックスvis_ligand_aupr_matに変換する。
# nichenetr 15
# Focus on top 30 genes.
vis_ligand_aupr <- ligand_activities %>% filter(test_ligand %in% best_upstream_ligands)
vis_ligand_aupr <- vis_ligand_aupr %>% column_to_rownames("test_ligand")
vis_ligand_aupr <- vis_ligand_aupr %>% dplyr::select(aupr_corrected)
vis_ligand_aupr <- vis_ligand_aupr %>% dplyr::arrange(aupr_corrected)
vis_ligand_aupr_mat <- as.matrix(vis_ligand_aupr)
列aupr_correctedの値のトップ30の遺伝子を可視化する。これはデータフレームの数字を見たほうがより詳しくかつ全体的に評価出来きるので、正直不要な気がする。やってもやらなくても、どっちでも良い。
# nichenetr 16
(make_heatmap_ggplot(vis_ligand_aupr_mat,
"Prioritized ligands", "Ligand activity",
legend_title = "AUPR", color = "darkorange") +
theme(axis.text.x.top = element_blank())) predict_ligand_activities()の結果得られた列corrected_auprの値のトップ30の遺伝子(ベクトルbest_upstream_ligands)が相互作用するレセプター側の遺伝子と、それらをグラフで解析するときの重み付の値(たたぶん。論文を読んでもなんかふわっとしかわからんかった)を求める。まず各リガンドが相互作用するレセプター側の遺伝子を抽出し、それをリストget_weighted_ligand_target_linksの各要素のリガンド毎に入れていく。そのリストget_weighted_ligand_target_linksの各要素をbind_rows()で結合してデータフレームとし、欠損値を含む行をdrop_na()で除去し、データフレームactive_ligand_target_links_dfとする。
正直、このnichenetrのインストラクションは、値を色々と抽出してきて、色々とデータを加工するので、一体、どの値を使って何の値を出しているのかよくわからない。なので、参考のために以下にget_weighted_ligand_target_links()の日本語訳を載せておく。これは、推定されるリガンドと結合する標的分子に当たりを付けるって関数だと思う。おそらく標的分子はレセプターである必要はないって感じだと思う。説明と論文を読んでも、いまいちわからんかった….
| 項目 | 説明 |
|---|---|
| 関数 | get_weighted_ligand_target_links() |
| 説明 | 推定されるリガンドと、(自分たちの)関心のある遺伝子との間の結合を推定する。 |
| 使用方法 | get_weighted_ligand_target_links(ligand, geneset,ligand_target_matrix,n = 250) |
| 引数 | ligand;自分たちが見つけたい、活性が高いと推定されるリガンドを入れた文字列ベクトル。ここでは、ベクトルbest_upstream_ligandsを使用した。best_upstream_ligandsは、predict_ligand_activities()の結果得られた列corrected_auprの値のトップ30の遺伝子からなるベクトル。 |
| 引数 | geneset;その発現が相互作用する細胞からのリガンドによって影響を行ける可能性がある遺伝子の文字列ベクトル。ここでは、ベクトルpotential_ligands_focusedを使用した。コードを見ている感じでは、この遺伝子はnichnetrが用意するデータフレームlr_networkの列fromに値がある必要がある(気がする)。potential_ligands_focusedは、ベクトルpotential_ligands(nichenetrに登録のあるリガンド側の遺伝子で、自分たちの解析対象のオブジェクトに含まれている遺伝子)とベクトルexpressed_genes_sender(自分たちの解析対象となるオブジェクトに含まれている遺伝子)で共通する遺伝子から成るベクトル。 |
| 引数 | ligand_target_matrix;Nichenetrのリガンドとレセプターの活性を示す事前確率のマトリックス。 |
| 引数 | n;デフォルトで250。トップn個の遺伝子を検討する。 |
# nichenetr 17
#
active_ligand_target_links_df <- best_upstream_ligands %>%
lapply(get_weighted_ligand_target_links,
geneset = potential_ligands_focused,
ligand_target_matrix = ligand_target_matrix,
n = 100)
#
active_ligand_target_links_df <- active_ligand_target_links_df %>% bind_rows() %>% drop_na()
nrow(active_ligand_target_links_df)
head(active_ligand_target_links_df)コード# nichenetr 17で求めたグラフの重み付けの値と、リガンドとレセプターの活性の強さをまとめたマトリックスligand_target_matrixを使って、ヒートマップのためのマトリックスactive_ligand_target_linksを作成する。
# nichenetr 18
active_ligand_target_links <- prepare_ligand_target_visualization(
ligand_target_df = active_ligand_target_links_df,
ligand_target_matrix = ligand_target_matrix,
cutoff = 0.33)
nrow(active_ligand_target_links)
head(active_ligand_target_links)
マトリックスactive_ligand_target_linksから、補正後のAUPRのトップ30の遺伝子を抽出し、ベクトルorder_ligandsとし、rev()でその並びを逆にする。さらに、それらのトップ30の遺伝子と相互作用しそうなレセプターをデータフレームactive_ligand_target_links_dfの列targetから抽出して、それをベクトルorder_targetsとする。
ベクトルorder_ligandsと、ベクトルorder_targetsを使ってマトリックスactive_ligand_target_linksからヒートマップとして表示する遺伝子を抽出し、それを転置させる。
# nichenetr 19
order_ligands <- intersect(best_upstream_ligands, colnames(active_ligand_target_links)) %>% rev()
order_targets <- active_ligand_target_links_df$target %>% unique() %>% intersect(rownames(active_ligand_target_links))
vis_ligand_target <- t(active_ligand_target_links[order_targets,order_ligands])
活性が高い可能性のあるリガンドとレセプターをヒートマップで表示する。これは見た感じggplot2が使われているので、細かい作図はggplot2を追加していけば良さそう。
# nichenetr 20
make_heatmap_ggplot(vis_ligand_target, "Prioritized ligands", "Predicted target genes",
color = "purple", legend_title = "Regulatory potential") +
scale_fill_gradient2(low = "whitesmoke", high = "purple")活性が高そうなリガンドと、nichenetrのレセプターとの結合の強さを見つける。上記のget_weighted_ligand_target_links()との違いは、相手方の分子が、nichenetrで用意したレセプターなのか、そうでないのかの違い、だと思う。ここもあまり詳しく書いていないので、いまいちわからんけど、コードを見ている限りそうだと思う。
| 項目 | 説明 |
|---|---|
| 関数 | get_weighted_ligand_receptor_links() |
| 説明 | 活性が高いと推定されるリガンドに対するレセプターの重み付けされた関連性・結合の強さ(リンクと言っている)を取得する。 |
| 使用方法 | get_weighted_ligand_receptor_links( best_upstream_ligands, expressed_receptors, lr_network, weighted_networks_lr_sig ) |
| 引数 | best_upstream_ligands;活性が高い可能性のあるリガンドからなる文字列ベクトル。ここでは、ベクトルbest_upstream_ligandsを使用した。ベクトルbest_upstream_ligands;は、predict_ligand_activities()の結果得られた列corrected_auprの値のトップ30の遺伝子からなるベクトル。 |
| 引数 | expressed_receptors;自分たちが関心のある細胞で発現するレセプターからなる文字列ベクトル。ここでは、ベクトルexpressed_receptorsを使用した。ベクトルexpressed_receptorsは、ベクトルall_receptors(データフレームlr_networkの列to、すなわち、nichenetrのレセプター側の遺伝子から、遺伝子名の重複の除いたベクトル)のうち、ベクトルinterest_genes(自分たちの解析対象のマーカー遺伝子からなるベクトル)と共通する遺伝子を抽出したベクトル。つまり、データフレームlr_networkの列toにある、自分たちの解析対象のオブジェクトにある遺伝子のベクトル。重複除去済。 |
| 引数 | lr_network;Nichenetrが用意するリガンドレセプターペア、列fromと列toの2列から成るデータフレーム。ここでは、データフレームlr_networkを使用した。 |
| 引数 | weighted_networks_lr_sig;リガンド-レセプターペアとその重み付けの値の3列(列from、列to、列weight)から成るデータフレーム。ここではリストweighted_networksの要素lr_sigを使用した。 |
# nichenetr 21
ligand_receptor_links_df <- get_weighted_ligand_receptor_links(
best_upstream_ligands, expressed_receptors,
lr_network, weighted_networks$lr_sig) 求めたリガンド-レセプターペアの活性をヒートマップで示すために、マトリックスvis_ligand_receptor_networkを用意する。
# nichenetr 22
vis_ligand_receptor_network <- prepare_ligand_receptor_visualization(
ligand_receptor_links_df,
best_upstream_ligands,
order_hclust = "both") リガンドとレセプターの推定される活性についてヒートマップで示す。
# nichenetr 23
(make_heatmap_ggplot(t(vis_ligand_receptor_network),
y_name = "Ligands", x_name = "Receptors",
color = "mediumvioletred", legend_title = "Prior interaction potential"))ここまでは、どうやらLigand-agnosticな解析だったらしい。Ligand-agnosticとは、どの細胞で発現しているか、などには着目せず、例えば、DEG解析で得られた遺伝子全部に着目して解析する、というアプローチだと思う。インストラクションでは、以降は、リガンドを送る側の細胞に発現しているリガンドのみに着目して解析する、というリガンドを限定した解析方法(Ligand-Focused appoarch)が書かれていた。今回は特にDEGなどは行っていないし、上記で大体の解析方法はわかったので、このLigand-Focused appoarchは行わない。コード# nichenetr 24は、それ以降でLigand-Focused appoarchを行っていく前に、Ligand-agnostic appoarchのときに得たリガンドとレセプターの活性に関するデータセットを残しておくためのコードである。データフレームligand_activitiesとベクトルbest_upstream_ligandsを、それぞれ、データフレームligand_activities_allと、ベクトルbest_upstream_ligands_allにコピーしておく。というか、Ligand-Focused Appoarchを行うなら、全部同じ変数名を使わずに、それ用に変えろよ、と作者に言いたい。
# nichenetr 24
# 2026 09 11 need to check. ligand_activities_all or ligand_activities
ligand_activities_all <- ligand_activities
best_upstream_ligands_all <- best_upstream_ligandsここで、得られた活性の高そうなリガンドはどの細胞に発現しているのか、ドットプロットで可視化する。もっとわかりやすい方法があれば、別の方法でも一向に構わん。
# niehenetr 25
# Dotplot of sender-focused approach
# p_dotplot <-
# DotPlot(subset(concat_nichenetr, celltype_2 %in% sender_celltypes),
# features = rev(best_upstream_ligands), cols = "RdYlBu") +
# coord_flip() +
# scale_y_discrete(position = "right")
p_dotplot <-
DotPlot(concat_nichenetr,
features = rev(best_upstream_ligands), cols = "RdYlBu") +
coord_flip() +
scale_y_discrete(position = "right")
p_dotplot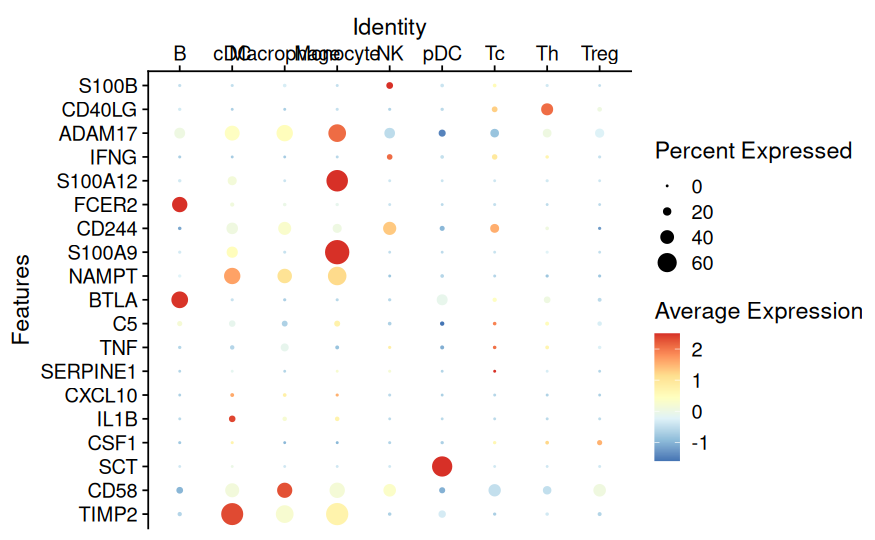
assign_ligands_to_celltype()で、ベクトルbest_upstream_ligandsにある遺伝子が、自分たちのオブジェクトconcat_nichenetrのどの細胞に発現しているかを取得し、その結果をデータフレームligand_type_indication_dfに入れる。
ここで、本来ならばScanpyで同定した細胞名を入れたベクトルcelltype_2(と言うか、データフレームobsの列celltype_2)を使いたいが、これにはFactorが設定されており、assign_ligands_to_celltype()に入れるとエラーが出てしまった。なので、列celltype_2を文字列ベクトルとして新たにcelltype_3に入れて、それをassign_ligands_to_celltype()に入れている。
# nichenetr 26
## "nichenet_output$top_ligands" is same as "best_upstream_ligands"
# class(seuratObj@meta.data$celltype) # "celltype" is charactor vector
class(concat_nichenetr@meta.data$celltype_2) # "celltype_2" is vector with factor
concat_nichenetr@meta.data$celltype_3 <- as.character(concat_nichenetr@meta.data$celltype_2) # Remove factors
ligand_type_indication_df <- assign_ligands_to_celltype(concat_nichenetr,
best_upstream_ligands,
celltype_col = "celltype_3")
ligand_type_indication_df %>% head()
ligand_type_indication_df$ligand_type %>% table()
コード# nichenetr 26で作成したデータフレームligand_type_indication_dfに、値Treatedが入った列target_typeを新しく追加する。ここは、本来ならばどの細胞がどの薬剤を投与されたかを入れる。しかし、この解析では、残念ながらどの検体が何の免疫チェックポイント阻害剤を入れたのかわからないので、ここは値Treatedのみにした。
次に、get_ligand_target_links_oi()で、サーカスプロットのためのデータフレームを作成する。これは入れる引数がすでに決まっている。以下の表にまとめる。サーカスプロットを作成するには、素直にこれを使用する方が良いかと思う。難しいから。
| 項目 | 説明 |
|---|---|
| 関数 | get_weighted_ligand_receptor_links() |
| 説明 | 一定のカットオフでリガンド-レセプターのリンク(要はペアってことだと思う)をフィルターする。 |
| 使用方法 | get_ligand_target_links_oi(ligand_type_indication_df, active_ligand_target_links_df, cutoff = 0.40) |
| 引数 | ligand_type_indication_df;assign_ligand_to_celltype()で得られたデータフレーム。ここでは、データフレームligand_type_indication_df、ベクトルbest_upstream_ligandsにある遺伝子が、自分たちのオブジェクトconcat_nichenetrのどの細胞に発現しているかを入れたデータフレームを使用した。 |
| 引数 | active_ligand_target_links_df;get_ligand_target_links()で得られたデータフレーム。ここでは、データフレームactive_ligand_target_links_dfを使用した。このデータフレームは、ベクトルbest_upstream_ligandsが相互作用するレセプターと、それをグラフ解析するときの重みの値を入れたデータフレーム。これはコード# nichenetr 17で作成した。マニュアルでは「get_ligand_target_links()で得られたデータフレーム」と書かれているが、ここで使ったのはget_weighted_ligand_target_links()で得られたデータフレームだった。 そのデータフレームに列 target_type、すなわち、どの細胞がどの薬剤を投与されたかを示す列を付ける必要らしい。ここでは値Treatedのみを入れた列target_typeを使用した。 |
| 引数 | cutoff;リガンドとターゲットの結合の強さ(リンクと言ってる)がある一定以下のものを除去する。 これはある一定の分位数以下の強さのものを除くということらしい。0.40がデフォルトで、これだと40%以下のものを除去、ということのようだ。 |
# nichenetr 27
# head(nichenet_output$ligand_target_df)
# active_ligand_target_links_df <- nichenet_output$ligand_target_df
active_ligand_target_links_df$target_type <- "Treated" # needed for joining tables
circos_links <- get_ligand_target_links_oi(ligand_type_indication_df,
active_ligand_target_links_df,
cutoff = 0.40)
head(circos_links)
# # A tibble: 6 × 5
# ligand target weight target_type ligand_type
# <chr> <chr> <dbl> <chr> <chr>
# 1 S100B APP 0.0163 Treated NK
# 2 S100B BACE1 0.0439 Treated NK
# 3 S100B CDH1 0.0164 Treated NK
# 4 S100B CFH 0.0653 Treated NK
# 5 S100B ICAM1 0.0210 Treated NK
# 6 S100B IFNG 0.0168 Treated NK 続いて、サーカスプロットの色だの凡例などを準備する。
# nichenetr 28
table(concat_nichenetr$celltype_2)
# c("Monocyte", "Macrophage", "cDC", "pDC", "B", "NK", "Th", "Tc", "Treg")
table(circos_links$ligand_type)
ligand_colors <- c("General" = "black", "Monocyte" = "#1f77b4", "Macrophage" = "#ff7f0e", "cDC" = "#2ca02c",
"pDC" = "#d62728", "B" = "#9467bd", "NK" = "#8c564b",
"Th"= "#e377c2", "Tc" = "gold4", "Treg" = "yellow")
target_colors <- c("Treated" = "gray")
vis_circos_obj <- prepare_circos_visualization(circos_links,
ligand_colors = ligand_colors,
target_colors = target_colors,
celltype_order = NULL) 自分のオブジェクトにある遺伝子を使って、サーカスプロットを描く。色が細胞、グレーの遺伝子がレセプターとして機能しているだろう遺伝子。
# nichenetr 29
make_circos_plot(vis_circos_obj, transparency = FALSE, args.circos.text = list(cex = 0.5))サーカスプロット別バージョン。
# nichenetr 30
make_circos_plot(vis_circos_obj, transparency = TRUE, args.circos.text = list(cex = 0.5)) サーカスプロット別バージョン。背景を変えたり、サイズを変えたり。
# nichenetr 31
par(bg = "white")
# Default celltype order
celltype_order <- unique(circos_links$ligand_type) %>% sort() %>% .[. != "General"] %>% c(., "General")
# Create legend
circos_legend <- ComplexHeatmap::Legend(
labels = celltype_order,
background = ligand_colors[celltype_order],
type = "point",
grid_height = unit(3, "mm"),
grid_width = unit(3, "mm"),
labels_gp = grid::gpar(fontsize = 8)
)
circos_legend_grob <- grid::grid.grabExpr(ComplexHeatmap::draw(circos_legend))
make_circos_plot(vis_circos_obj, transparency = TRUE, args.circos.text = list(cex = 0.5))
p_circos_no_legend <- recordPlot()これも別バージョン。細胞の凡例付き。
# nichenetr 32
cowplot::plot_grid(p_circos_no_legend, circos_legend_grob, rel_widths = c(1, 0.1))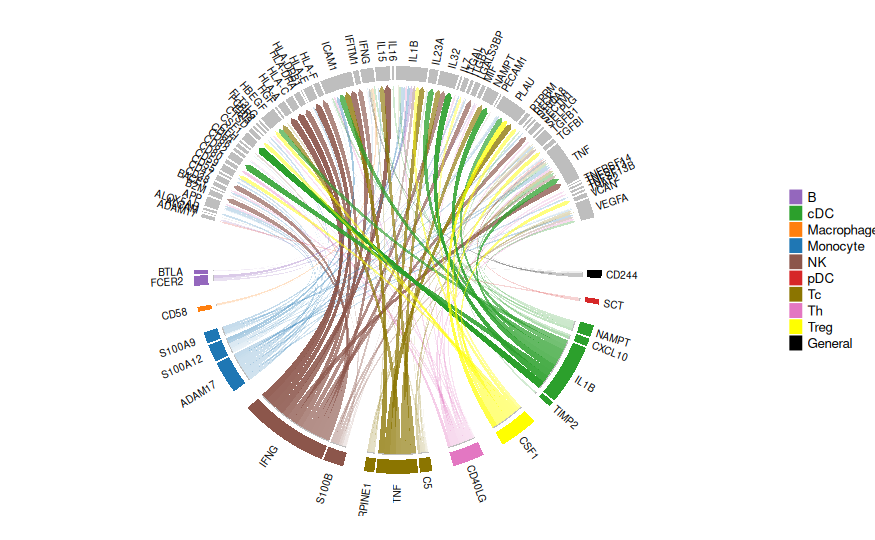
どの細胞から出るどのリガンド(各色)が、どのレセプター(赤)と相互作用しているのかを示すサーカスプロットを出すための準備ということはわかるが、もうクソわかりにくい。完全にスパゲッティーコードである。なんやこの簡潔性の欠片もないパッケージ、というか、このインストラクションは、もうちょっとわかりやすくならんのか。ということで、以下に使用したデータフレームをまとめる。これらをprepare_circos_visualization()に入れ、レセプターの活性をサーカスプロットで可視化するためのリストvis_circos_receptor_objを作成する。
| データフレーム | 説明 |
|---|---|
| ligand_receptor_links_df | データフレームligand_receptor_links_dfは、コード#nichenetr 21で、get_weighted_ligand_receptor_links()の結果として作成した。get_weighted_ligand_receptor_links()は引数としてベクトルbest_upstream_ligands(predict_ligand_activities()の結果得られた列corrected_auprの値のトップ30の遺伝子からなるベクトル)、ベクトルexpressed_receptors(データフレームlr_networkの列to、すなわちNichenetが用意したレセプターの遺伝子に共通している、自分たちの解析対象のオブジェクトにある遺伝子から成るベクトル)、データフレームlr_network(Nichenetが用意したリガンドとレセプターを列from、列toとしたデータフレーム)、可視化のときの重み付けされた値を入れたリストweighted_networksの要素lr_sig)を使って、活性の高いとされたリガンドに対する、重み付けされたレセプターの活性を示す値を取得する関数である。データフレームligand_receptor_links_dfは、活性が高いと考えられるリガンドに対する、自分たちが関心のあるレセプターの活性を示す値を入れたデータフレームである。 |
| ligand_receptor_links_df_2 | ligand_receptor_links_dfの列from、列toをそれぞれ列ligand、列receptorに変更して作成したデータフレーム。 |
| lr_network_top_df | データフレームligand_receptor_links_df_2に”receptor”を入れた列target_typeを追加したデータフレーム。 |
| ligand_type_indication_df | 自分たちのオブジェクトconcat_nichenetrにある遺伝子のうち、活性の高そうなリガンドのトップ30位からなるベクトルbest_upstream_ligands_sender_agnostic(コード# nichenetr 26で作成)と共通する遺伝子が、どの細胞に発現しているかを入れたデータフレームである。 |
# nichenetr 33
# "ligand_receptor_links_df" is same as "nichenet_output$ligand_receptor_df", but column name is a little bit different.
ligand_receptor_links_df_2 <- ligand_receptor_links_df %>% rename(
"ligand" = "from", "receptor" = "to")
lr_network_top_df <- ligand_receptor_links_df_2 %>% mutate(target_type = "receptor")
lr_network_top_df <- lr_network_top_df %>% rename(target=receptor)
lr_network_top_df <- lr_network_top_df %>% inner_join(ligand_type_indication_df)
receptor_colors <- c("receptor" = "#E41A1C")
vis_circos_receptor_obj <- prepare_circos_visualization(lr_network_top_df,
ligand_colors = ligand_colors,
target_colors = receptor_colors) 作成したリストvis_circos_receptor_objを使って、自分たちのオブジェクトにある、活性が高い可能性のあるリガンドと、それに対するレセプターの関連性をサーカスプロットで可視化する。レセプターが赤、各細胞から出るリガンドが、その細胞の色(コード# nichenetr 28で作成)で示されている。これが、リガンド-レセプターペアの活性を最もクリアに説明している図な気がする。
# nichenetr 34
make_circos_plot(vis_circos_receptor_obj, transparency = FALSE,
link.visible = TRUE, args.circos.text = list(cex = 0.8)) 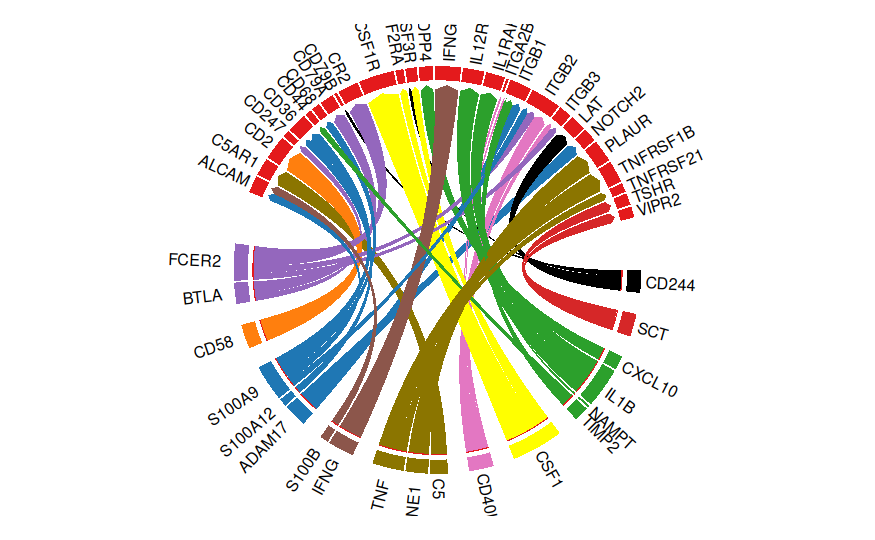
CellphoneDBによる細胞-細胞間コミュニケーション解析
次に、CellPhoneDBで解析する。これもマニュアル通りに進める。ここで、CellphoneDBのリガンド‐レセプターペアを入れたデータセットをダウンロードする必要がある。
## Database
# https://github.com/ventolab/cellphonedb-data
git clone https://github.com/ventolab/cellphonedb-data.git
git clone https://github.com/ventolab/cellphonedbviz.gitCellPhoneDBはPythonである。以下のパッケージを使用する。以下は、データベースに登録のあるリガンド-レセプターの相互作用を計算する。これに必要なデータベースやオブジェクトへのパスなどをそれぞれ設定していく。
cpdb_analysis_method.call()は、ある細胞に発現するリガンドと、別の細胞に発現している、そのリガンドに対するレセプターの発現の平均と割合(発現している細胞の割合だと思う)を計算する。特に統計的な解析はやらんらしい。
# cellphonedb 1
# https://cellphonedb.readthedocs.io/en/latest/RESULTS-DOCUMENTATION.html#input-files
from cellphonedb.src.core.methods import cpdb_analysis_method
cpdb_results = cpdb_analysis_method.call(
cpdb_file_path = '/home/kats/cellphonedb-data/cellphonedb.zip',
meta_file_path = '/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_metadata.tsv',
counts_file_path = '/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad',
counts_data = 'hgnc_symbol',
output_path = '/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_cellphonedb/')cpdb_statistical_analysis_method.call()では、読んでいると、対象となる細胞間のリガンドとレセプターに関して、パーミューテーション検定(だと思う)を行うらしい。またデフォルトで細胞の10%以上で発現している遺伝子を解析の対象とするようだ。この値は引数thresholdで変えることが出来る。もちろん、上記のシャッフルする回数やp値もiterationsやpvalueで指定することが出来る。以下は全部デフォルトで使用した。
他にも、例えば薬剤投与群と非投与群などの区別があれば、その群間で発現量の比較も可能であるが、今回用いたデータセットは残念ながらその群間の区別ができないので、DEG解析を行うことは出来なかった。
# cellphonedb 2
from cellphonedb.src.core.methods import cpdb_statistical_analysis_method
cpdb_results = cpdb_statistical_analysis_method.call(
cpdb_file_path = '/home/kats/cellphonedb-data/cellphonedb.zip',
meta_file_path = '/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat_metadata.tsv',
counts_file_path = '/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad',
counts_data = 'hgnc_symbol',
output_path = '/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_cellphonedb/')コード#cellphonedb 1と#cellphonedb 2が終わると、output_pathに指定したディレクトリ、ここでは/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/output_cellphonedb/に以下のように結果が入る。
次に、CellPhoneDBの計算結果を可視化する。このためにはCellPhoneDBVizを使用する。CellPhoneDB VIZはgit clone https://github.com/ventolab/cellphonedbviz.gitしたら、その中のdataディレクトリに、上記で得られた結果を入れる。以下の画像のディレクトリPRJNA976204_statisticsがそれである。
その中に、得られた結果、cellphonedbのデータベース、そして設定を記載したymlファイルconfig.ymlを入れる。
config.ymlは以下の画像の用に設定する。
次にbashでCellPhoneDB Vizを実行する。
# # bash
# # See how to prepare visialization of cellphonedb; /mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/2026 06 03 scanpy install.md
# # The files and the configuration for visualization is here; /home/kats/cellphonedbviz/data/PRJNA976204_statistics
# # After the preparation, run following command.
conda activate cellphonedb
cd /home/kats/cellphonedbviz
./run.sh実行すると、使用しているウェブブラウザで以下のアドレスに行けばCellPhoneDBの解析結果の図を見ることが出来る。自分はChromeを使った。VScodeでもみることが出来る。
# Run the bellow on the web browser (e.g. google-chrome). VS code can also show the result. Click "http://localhost:8001/" below.
http://localhost:8001/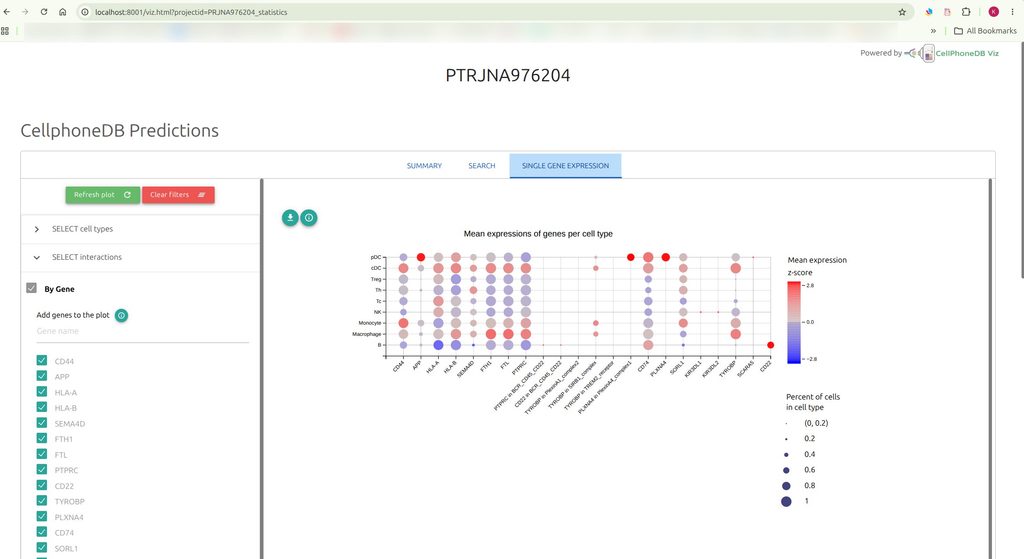
Liana+による細胞-細胞間コミュニケーション解析
次は、Liana+を使用する。LianaはRで実装されていたんだけど、Liana+になったらPythonになっていた。Pythonのほうが早いからな。使用するパッケージである。
# import liana
import liana as li
from liana.mt import rank_aggregate
from liana.method import singlecellsignalr, connectome, cellphonedb, natmi, logfc, cellchat, geometric_mean
import pandas as pd
import scanpy as sc
import anndata最初にscanpyで作成したオブジェクトを読み込んでくる。
# liana plus 1
concat = anndata.read_h5ad('/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/concat.h5ad')それをUMAPで可視化する。当然、これまでと同じ図を得ることが出来るはず。
# liana plus 2
sc.pl.umap(concat, color='celltype_2', title='celltype_2', frameon=False)
Liana+は、色々な細胞-細胞間コミュニケーション解析のデータベースを利用出来る。どんなデータが利用できるか、以下で確認する。ベンチマークとして良さげなパッケージを見ることが出来る。
# liana plus 3
li.mt.show_methods()まず、cellphoneDBで計算してみる。結果はオブジェクトconcatに入る。
# liana plus 4
# liana typically works with the "log1p-trasformed counts matrix", in this object "the normalized counts" are stored in raw:
cellphonedb(concat,
use_raw=False,
layer='log1p_normalize_total',
groupby='celltype_2',
resource_name='consensus',
expr_prop=0.1,
verbose=True, key_added='cpdb_res')その結果をドットプロットで表示する。
# liana plus 5
li.pl.dotplot(adata = concat,
colour='lr_means',
size='cellphone_pvals',
inverse_size=True, # we inverse sign since we want small p-values to have large sizes
source_labels=['Monocyte', 'Macrophage', 'cDC', 'pDC', 'B','Th', 'Tc', 'NK', 'Treg'],
target_labels=['Monocyte', 'Macrophage', 'cDC', 'pDC', 'B','Th', 'Tc', 'NK', 'Treg'],
figure_size=(25, 20),
# finally, since cpdbv2 suggests using a filter to FPs
# we filter the pvals column to <= 0.05
filter_fun=lambda x: x['cellphone_pvals'] <= 0.01,
uns_key='cpdb_res' # uns_key to use, default is 'liana_res'
)次は結果をヒートマップで表示する。
# liana plus 6
my_plot = li.pl.tileplot(adata = concat,
# NOTE: fill & label need to exist for both
# ligand_ and receptor_ columns
fill='means',
label='props',
label_fun=lambda x: f'{x:.2f}',
top_n=10,
orderby='cellphone_pvals',
orderby_ascending=True,
source_labels=['Monocyte', 'Macrophage', 'cDC', 'pDC', 'B','Th', 'Tc', 'NK', 'Treg'],
target_labels=['Monocyte', 'Macrophage', 'cDC', 'pDC', 'B','Th', 'Tc', 'NK', 'Treg'],
uns_key='cpdb_res', # NOTE: default is 'liana_res'
source_title='Ligand',
target_title='Receptor',
figure_size=(20, 7)
)
my_plot正直、各パッケージのデータベースをそれぞれ使うのは効率が良くないので、利用できるデータベースの結果を全部集計してしまう。これが最も有効と思われる。
# liana plus 7
li.mt.rank_aggregate(concat,
use_raw=False,
layer='log1p_normalize_total',
groupby='celltype_2',
resource_name='consensus',
expr_prop=0.1,
verbose=True)その結果をドットプロットで示す。これはトップ50のリガンドレセプターペアを可視化した結果である。
# liana plus 8
li.pl.dotplot(adata = concat,
colour='magnitude_rank',
size='specificity_rank',
inverse_size=True,
inverse_colour=True,
source_labels=['Monocyte', 'Macrophage', 'cDC', 'pDC', 'B','Th', 'Tc', 'NK', 'Treg'],
target_labels=['Monocyte', 'Macrophage', 'cDC', 'pDC', 'B','Th', 'Tc', 'NK', 'Treg'],
top_n=50,
orderby='magnitude_rank',
orderby_ascending=True,
figure_size=(20, 15)
)これはp値が0.01以下のリガンド-レセプターペアを可視化した結果である。
# liana plus 9
li.pl.dotplot(adata = concat,
colour='magnitude_rank',
size='specificity_rank',
inverse_size=True,
inverse_colour=True,
source_labels=['Monocyte', 'Macrophage', 'cDC', 'pDC', 'B','Th', 'Tc', 'NK', 'Treg'],
target_labels=['Monocyte', 'Macrophage', 'cDC', 'pDC', 'B','Th', 'Tc', 'NK', 'Treg'],
filter_fun=lambda x: x['cellphone_pvals'] <= 0.01,
orderby='magnitude_rank',
orderby_ascending=True,
figure_size=(20, 15)
)次に、細胞毎にサークルプロットでだす。CellChatのあれみたいなヤツである。個人的に思うのは、この図はインパクトはあれど、意味はあまり無い。他にも色々な機能がありそうだが、このデータセットでは薬剤投与群と非投与群の区別がないので、DEGなんかは出来ない。
# liana plus 10
for celltype in ['Monocyte', 'Macrophage', 'cDC', 'pDC', 'B','Th', 'Tc', 'NK', 'Treg']:
li.pl.circle_plot(concat,
groupby='celltype_2',
score_key='magnitude_rank',
inverse_score=True,
source_labels=celltype,
filter_fun=lambda x: x['specificity_rank'] <= 0.05,
pivot_mode='counts', # NOTE: this will simply count the interactions, 'mean' is also available
figure_size=(5, 5),
)SlingshotとtradeSeqによるpseudotime analysis(疑似時間解析)
ここで、またRに行ってPeudotime Analysisを行う。まずSlingshotで疑似系譜を求め、次にtradeSeqでその疑似系譜に沿った遺伝子発現量の変化を解析する。
h5adからSingleCellExperimentオブジェクトへの変換
slingshotはSingleCellExperimentオブジェクトを使って解析していく。よって、手持ちのデータをSingleCellExperimentオブジェクトに変換する必要がある。CellChatの手順が書かれた論文を読んでいてわかったのだが、このためにはzellkonverterというRパッケージが使えるかもしれない。知らなかったので試していないが。しかし、ここではこれまでと同様にマニュアルでSingleCellExperimentオブジェクトを作成していく。これならば、余計なパッケージのエラーなどに振り回される必要がない。
ここでは、CellChatオブジェクトを作成するときに用いた、SCtransformにより正規化したカウントマトリックスを使用する。それはassaysスロットのSCTに入っている。さらに、細胞と遺伝子に関するメタデータ(obs、vars)、バッチ効果の補正に用いた値、PCAでの結果、UMAPの位置をTh_obsmから抽出してきて、それぞれでマトリックスを作成する。それらをSingleCellExperiment()に入れて、SingleCellExperimentオブジェクトを作成する。
# SingleCellExperiment object 1
# https://bioconductor.org/books/3.13/OSCA.intro/the-singlecellexperiment-class.html
## Th
colnames(Th_raw_t) # cells
rownames(Th_raw_t) # genes
concat_sctransform@assays$SCT@data[1:100, 1:100]
Th_raw_t_mat <- as.matrix(Th_raw_t)
Th_obs_sce <- Th_obs
rownames(Th_obs_sce) <- NULL
Th_var_sce <- Th_var
rownames(Th_var_sce) <- NULL
Th_sce_pca <- as.matrix(Th_obsm[,1:20])
Th_sce_harmony <- as.matrix(Th_obsm[,21:40])
Th_sce_umap <- as.matrix(Th_obsm[,61:62])
Th_sce <- SingleCellExperiment(assays = List(counts = Th_raw_t_mat),
colData = Th_obs_sce,
rowData = Th_var_sce)
Th_sce@int_colData$reducedDims$PCA <- Th_sce_pca
Th_sce@int_colData$reducedDims$HARMONY <- Th_sce_harmony
Th_sce@int_colData$reducedDims$UMAP <- Th_sce_umap
## Tc
colnames(Tc_normalize_pearson_t) # cells
rownames(Tc_normalize_pearson_t) # genes
Tc_raw_t_mat <- as.matrix(Tc_raw_t)
Tc_obs_sce <- Tc_obs
rownames(Tc_obs_sce) <- NULL
Tc_var_sce <- Tc_var
rownames(Tc_var_sce) <- NULL
Tc_sce_pca <- as.matrix(Tc_obsm[,1:20])
Tc_sce_harmony <- as.matrix(Tc_obsm[,21:40])
Tc_sce_umap <- as.matrix(Tc_obsm[,61:62])
Tc_sce <- SingleCellExperiment(assays = List(counts = Tc_raw_t_mat),
colData = Tc_obs_sce,
rowData = Tc_var_sce)
Tc_sce@int_colData$reducedDims$PCA <- Tc_sce_pca
Tc_sce@int_colData$reducedDims$HARMONY <- Tc_sce_harmony
Tc_sce@int_colData$reducedDims$UMAP <- Tc_sce_umap作成したSingleCellExperimentオブジェクトから各クラスタ毎に個数が均一になるように合計1000個細胞を抽出してくる。slingshotはこの必要はないが、tradeSeqではダウンサンプリングしないと計算が終わらなくなってしまう。大学とかで大きなサーバーを使えるヒトならば、ここはダウンサンプルせずとも大丈夫だろうと思う。
以降はこのダウンサンプルしたSigleCellExperimentオブジェクトを使用して解析していく。
# SingleCellExperiment object 2
## downsample the cell number using scrabbitr
Tc_downsample_sce <- downsampleSCE(Tc_sce, ncells = 1000)
Th_downsample_sce <- downsampleSCE(Th_sce, ncells = 1000)Slingshot
最初に、クラスター名を確認しておく。如何せん# SingleCellExperiment object 2のところでダウンサンプリングしているわけなので、ここで各クラスター毎に細胞数を確認しておいた方が良いだろう。
# slingshot 1
table(Tc_downsample_sce@colData$louvain_1.0)slingshot()でクラスターからtrajectoryを推定する。せっかくなので、引数reducedDim=”UMAP”として、Scanpyで求めたUMAPを使う。また、これまで行ってきた細胞のタイピングなどの結果から疑似系譜の開始点と終点を指定する。ここで、ダウンサンプリングした細胞障害性T細胞のSingleCellExperimentオブジェクトTc_downsample_sceを使うが、エフェクターT細胞っぽいクラスターを開始点、メモリーT細胞っぽいクラスターを終点としている。あとはデフォルトだったりインストラクションに従うだけ。
# slingshot 2
Tc_pto <- slingshot(Tc_downsample_sce,
reducedDim = "UMAP",
clusterLabels = "louvain_1.0",
start.clus = 3,
end.clus = 4,
omega = TRUE,
omega_scale = 1.5,
thresh = 0.15) # start.clus = '7' '4' .... or NULL
# clusterLabels = colData(Th_sce)$louvain_1.0_2, can be used for the calculation.得られたTrajectoryを表示する。ここではRのplot()で散布図を、lines()のtype = ‘lineages’でtrajectoryを折れ線で表示する。散布図の色としては、せっかくなのでmatplotlibっぽい色にしておいた。
# slingshot 3
custom_colors <- c(
"#1f77b4", "#ff7f0e", "#2ca02c", "#d62728",
"#9467bd", "#8c564b", "#e377c2", "#7f7f7f")
plot(
as.matrix(reducedDims(Tc_pto)$UMAP),
col = custom_colors[factor(Tc_pto$louvain_1.0)]
)
lines(SlingshotDataSet(Tc_pto), type = 'lineages', lwd=2, col = 'black') # type = 'lineages', "curves"同様に、lines()のtype = ‘curves’で、曲線で表示する。わかりやすい方を選択すれば良いと思う。
# slingshot 4
custom_colors <- c(
"#1f77b4", "#ff7f0e", "#2ca02c", "#d62728",
"#9467bd", "#8c564b", "#e377c2", "#7f7f7f")
plot(
as.matrix(reducedDims(Tc_pto)$UMAP),
col = custom_colors[factor(Tc_pto$louvain_1.0)]
)
lines(SlingshotDataSet(Tc_pto), type = 'curves', lwd=2, col = 'black') # type = 'lineages', "curves"同様の解析をダウンサンプリングしたヘルパーT細胞のSingleCelExperimentオブジェクトTh_downsample_sceで行っていく。まずはクラスターの確認。
# slingshot 5
table(Th_downsample_sce@colData$louvain_1.0)次に、slingshot()によりtrajectoryを求める。
# slingshot 6
Th_pto <- slingshot(Th_downsample_sce,
reducedDim = "UMAP",
clusterLabels = "louvain_1.0",
start.clus = 11,
end.clus = 7,
omega = TRUE,
omega_scale = 1.5,
thresh = 0.15) # start.clus = '7' '4' .... or NULL
# clusterLabels = colData(Th_sce)$louvain_1.0_2, can be used for the calculation.
# clusterLabels = colData(Th_downsample_sce)$louvain_1.0,
trajectoryを折れ線で表示する。
# slingshot 7
custom_colors <- c(
"#1f77b4", "#ff7f0e", "#2ca02c", "#d62728",
"#9467bd", "#8c564b", "#e377c2", "#7f7f7f")
plot(
as.matrix(reducedDims(Th_pto)$UMAP),
col = custom_colors[factor(Th_pto$louvain_1.0)]
)
lines(SlingshotDataSet(Th_pto), type = 'lineages', lwd=2, col = 'black') # type = 'lineages', "curves"trajectoryを曲線で表示する。
# slingshot 8
custom_colors <- c(
"#1f77b4", "#ff7f0e", "#2ca02c", "#d62728",
"#9467bd", "#8c564b", "#e377c2", "#7f7f7f")
plot(
as.matrix(reducedDims(Th_pto)$UMAP),
col = custom_colors[factor(Th_pto$louvain_1.0)]
)
lines(SlingshotDataSet(Th_pto), type = 'curves', lwd=2, col = 'black') # type = 'lineages', "curves"tradeSeq
slingshotで求めたtrajectoryはSingleCellExerimentオブジェクトに入っている。それをslingshotオブジェクトに変換する。
# tradeseq 1
Tc_pto_sds <- as.SlingshotDataSet(Tc_pto)tradeSeqの論文(https://www.nature.com/articles/s41467-020-14766-3)を読めばこの解析でどんな計算をしているのかがわかりやすい。やっていることは、Slignshotで求めたpseudotimeに沿って遺伝子発現量をプロットし、それをfigGAM()を使ってNB-GAM(Negative Binomical Generalized Additive Model)というものにフィットさせ、それに従って遺伝子発現量を解析する。
まず、遺伝子発現量をフィッティングするためには、そのフィッティングに用いる点を求める必要がある。フィッティングに用いる最適な点の数を求めるために、evaluateK()用いて、使用する点(knot)の数に対するAIC(Akaike Information Criterion; AIC)を計算しする。AICは、モデルへのフィッティングの良さを示す指標で、数値が少ないほどフィットが良いということらしい。以下のコード# tradeseq 2では、点(knot)の数を3から20まで増やしていき、そこで、AICが低く、かつ、遺伝子の数が多い点を最適とすれば良い。一般的に10以内に収まるらしい。個人的には広い範囲で見るのも有りだと思う。インストラクション(https://statomics.github.io/tradeSeq/articles/tradeSeq.html)でも3から20の範囲で計算しているわけだし。なので、ここでも20まで計算する。
# tradeseq 2
Tc_icMat <- evaluateK(counts = as.matrix(assays(Tc_pto)$counts),
sds = Tc_pto_sds,
parallel = TRUE,
nGenes = 500,
k= 3:20)
# cluster number is 4 therefore knots = 8 looks good.点の数が5くらいのとき、AICが低く、かつ点あたりの遺伝子数も多そうなので、fitGAM()をnknots=5を実行する。これも計算に時間がかかるので、CPUを使えるだけ使ったほう通い。自分のコンピューターではworkers = 16にするとおそらくメモリリークでRがクラッシュしたので、workers = 5で計算した。
非常に重要なのが引数conditionsである。もし薬剤投与群と非投与群がある場合、その群をここに設定しなければならない。この例の用に、scanpyで求めたクラスターを設定すると、その群での比較になってしまう。この例ではクラスターの番号として0、3、4の3群が設定されており、これだと以下のconditionTest()などの発現解析のときに、3群での比較になってしまい、非常にややこしいことになる。今回使ったデータセットは、免疫チェックポイント阻害剤に対する奏功群と非奏功群のはずだが、論文やデータの説明にこの点が全く書いていなかったという駄目論文だったので、ここは設定していない。
ちなみに、evaluateK()もこのfitGAM()も、コンピューターリソースに合わせてダウンサンプリングしなければ、計算が一生終わらないので注意が必要である。
# tradeseq 3
Tc_pto_DEG <- fitGAM(as.matrix(assays(Tc_pto)$counts),
sds = Tc_pto_sds,
conditions = factor(colData(Tc_pto)$louvain_1.0),
parallel = TRUE,
BPPARAM = MulticoreParam(workers = 5,
force.GC = TRUE,
progressbar = TRUE),
nknots = 5)発現量を解析する。conditionTest()は、デフォルトでglobal = TRUEになっており、この場合、クラスター間全体で差がある遺伝子を検出する。もし、例えば、薬剤投与群と非投与群の検定を行いたいときは、colData(Tc_pto_DEG)$tradeSeq$conditionsにそれらの群が入っているか確認し、global = FALSEにして実行しなければならない。また、各クラスターをそれぞれ比較したいときはpairwise=TRUE、Lineage = TRUEにしなければならない。引数knotsもあるので、ここも設定したほうが良さそうである。
こういうのって、マニュアルにサラッと書いてあるだけだし、インストラクションにはしっかり書かれていないので、非常に困る。ちなみに、こういうのをしっかり書くだけで、ユーザー数は増えるように思う。
associationTest()はそのtrajectroyに違いがあるか、startVsEndTest()は、文字通り開始点と終点のクラスターで発現に差があるかを見る。
# tradeseq 4
Tc_DEG <- conditionTest(Tc_pto_DEG, l2fc = log2(1.5))
Tc_association <- associationTest(Tc_pto_DEG, l2fc = log2(1.5))
Tc_startVsEnd <- startVsEndTest(Tc_pto_DEG, l2fc = log2(1.5))ここでは、IL17Rに着目し、trajectoryに沿って差があるのかどうかをplotSmoothers()とplotGeneCount()で表示してみる。着目する遺伝子は、コード# tradeseq 4で行った発現解析を見て拾ってくるのが良いと思う。plotSmoothers()はfitGAM()で設定した群間の比較、plotGeneCount()はtrajectoryに沿った遺伝子発現量をヒートマップで表示する。
# tradeseq 5
gene_of_interest_Tc <- "IL7R" # GNLY # VPS13C # CCL5
plotSmoothers(Tc_pto_DEG, assays(Tc_pto_DEG)$counts, gene = gene_of_interest_Tc, alpha = 1, border = TRUE)
plotGeneCount(curve = Tc_pto, counts = assays(Tc_pto)$counts, gene = gene_of_interest_Tc)
コード# tradeseq 4の結果得られたp値の検定の多重性を補正し、補正後のp値が0.05以下の遺伝子を抽出して来て、それをデータフレームとしてまとめる。
# tradeseq 6
## Tc
Tc_DEG$padj <- p.adjust(Tc_DEG$pvalue, "BH")
Tc_DEG <- Tc_DEG %>% dplyr::mutate(conditionTest =
case_when(
padj < 0.05 ~ "significant",
padj >= 0.05 ~ "not_significant",
TRUE ~ "unknown"
))
Tc_DEG <- rownames_to_column(Tc_DEG, var = "genes")
Tc_DEG_rowname_mtx <- rownames(assays(Tc_pto_DEG)$counts)
Tc_association$padj <- p.adjust(Tc_association$pvalue, "BH")
Tc_association <- Tc_association %>% dplyr::mutate(associateionTest =
case_when(
padj < 0.05 ~ "significant",
padj >= 0.05 ~ "not significant",
TRUE ~ "unknown"
))
Tc_association <- rownames_to_column(Tc_association, var = "genes")
Tc_startVsEnd$padj <- p.adjust(Tc_startVsEnd$pvalue, "BH")
Tc_startVsEnd <- Tc_startVsEnd %>% dplyr::mutate(startVsEndTest =
case_when(
padj < 0.05 ~ "significant",
padj >= 0.05 ~ "not significant",
TRUE ~ "unknown"
))
Tc_startVsEnd <- rownames_to_column(Tc_startVsEnd, var = "genes")
続いて、細胞障害性T細胞(Tc)の解析で行ったことを、ヘルパーT細胞(Th)のオブジェクトでも行う。まずはslingshotの結果をas.SlingshotDataSet()によりslingshotオブジェクトに変換する。
# tradeseq 7
Th_pto_sds <- as.SlingshotDataSet(Th_pto)次に、evaluateK()で、フィッティングするための最適な点(knot)の数をAICの低下とそのときの遺伝子数から判断する。以下は全体を見るためにknotを3から20までの場合の値を求める。
# tradeseq 8
Th_icMat <- evaluateK(counts = as.matrix(assays(Th_pto)$counts),
sds = Th_pto_sds,
parallel = TRUE,
nGenes = 500,
k= 3:20)
# cluster number is 4 therefore knots = 8 looks good.フィッティングに用いる点は6点が良さげだったので、nknots=6でフィッティングする。着目したい群がある場合、引数conditionsに指定する。この例のように、scanpyで得られたクラスターを指定するのは、あまり意味がない。
# tradeseq 9
Th_pto_DEG <- fitGAM(as.matrix(assays(Th_pto)$counts),
sds = Th_pto_sds,
conditions = factor(colData(Th_pto)$louvain_1.0),
parallel = TRUE,
BPPARAM = MulticoreParam(workers = 5,
force.GC = TRUE,
progressbar = TRUE),
nknots = 6)その結果を用いて発現量に統計的有意差のある遺伝子を抽出してくる。もし薬剤投与群と非投与群の群間の比較を行う場合、引数globalを変える必要がある。
# tradeseq 10
Th_DEG <- conditionTest(Th_pto_DEG, l2fc = log2(1.5))
Th_association <- associationTest(Th_pto_DEG, l2fc = log2(1.5))
Th_startVsEnd <- startVsEndTest(Th_pto_DEG, l2fc = log2(1.5))ここではCCL5に着目して、trajectoryに沿ったその発現量をplotSmoothers()とplotGeneCount()で可視化する。plotSmoothers()はfitGAM()で設定した群間の比較、plotGeneCount()はtrajectoryに沿った遺伝子発現量をヒートマップで表示する。
# tradeseq 11
gene_of_interest_Th <- "CCL5" # GNLY # VPS13C # CCL5
plotSmoothers(Th_pto_DEG, assays(Th_pto_DEG)$counts, gene = gene_of_interest_Th, alpha = 1, border = TRUE)
plotGeneCount(curve = Th_pto, counts = assays(Th_pto)$counts, gene = gene_of_interest_Th)
コード#tradeseq 10の結果得られるp値に対し検定の多重性の補正を行い、補正後のp値が0.05以下の遺伝子を抽出してまとめる。
# tradeseq 12
## Th
Th_DEG$padj <- p.adjust(Th_DEG$pvalue, "BH")
Th_DEG <- Th_DEG %>% dplyr::mutate(conditionTest =
case_when(
padj < 0.05 ~ "significant",
padj >= 0.05 ~ "not_significant",
TRUE ~ "unknown"
))
Th_DEG <- rownames_to_column(Th_DEG, var = "genes")
Th_DEG_rowname_mtx <- rownames(assays(Th_pto_DEG)$counts)
Th_association$padj <- p.adjust(Th_association$pvalue, "BH")
Th_association <- Th_association %>% dplyr::mutate(associateionTest =
case_when(
padj < 0.05 ~ "significant",
padj >= 0.05 ~ "not significant",
TRUE ~ "unknown"
))
Th_association <- rownames_to_column(Th_association, var = "genes")
Th_startVsEnd$padj <- p.adjust(Th_startVsEnd$pvalue, "BH")
Th_startVsEnd <- Th_startVsEnd %>% dplyr::mutate(startVsEndTest =
case_when(
padj < 0.05 ~ "significant",
padj >= 0.05 ~ "not significant",
TRUE ~ "unknown"
))
Th_startVsEnd <- rownames_to_column(Th_startVsEnd, var = "genes")
以上がtradeSeqである。色々調べたが、trajectoryに沿った遺伝子発現を解析するのはこのslingshotとtradeSeqが一番良いような気がする。ただし、ダウンサンプリングしたり、明確なtrajectoryにこそ効果があったり、逆に複雑すぎるtrajectoryでは解析が難しかったりと、欠点も多々あるような気がするので、その場合はmonocle3とか、別のパッケージを試すのも良いと思う。
ここまで終わったら保存する。
# tradeseq 13
## 2026 08 01
save.image("/mnt/team4tb/Dropbox/Blog/2026 05 11 blog scRNAseq 1/PRJNA976204_seurat_pseudobulk_cellchat_nichenetr_slingshot_tradeseq.RData")まとめ
はじめにで述べたようにシングルセルRNAシークエンスの解析方法も最近では安定してきており、スタンダードな方法が確率されてきたように感じている。また、公開データも充実してきており、実際のシークエンスなんかやらなくてもある程度解析できてしまうように思う。
この解析にはDEG解析は含んでいないけど、大体はこれが一連の流れになると思う。個人的にはDEG解析にはMASTというパッケージを使用している。CellChatでもなんでも、DEG解析に対応しているものも多いので、これは他の記事に改めてまとめようと思う。DEG解析を行わないシングルセルRNAシークエンスはほぼゴミ、DEG解析まで行ってようやくスタート地点と言える。だからこの論文も結局はFrontiers止まり、読んでも何にも使えんって感じの論文である。シングルセルRNAシークエンスは未だ高価ではあるので、こんなFrontiersなんかに投稿するのはもっての他で、大金と労力をドブに捨てるようなものである。
もう一つ思うことは、シングルセルRNAシークエンスの解析ってあんまり面白くないということである。まず、基本となる解析方法が高度過ぎる。PCAなどで次元削減を行い、何らかの方法によりバッチエフェクトを補正し、さらにUMAPで表示して、細胞を同定し、RNA velocity解析により…..である。こんなこと素で出来るのは天才であり、凡人はデータを整えてこれらを行ってくれる関数にデータセットを入れるだけである。数年前、この手の解析は、解析するだけで論文になっている感があったが、やっただけでは全く論文にならないし、下手するとこの論文のようにFigureひとつにしか、もしかしたら一つにさえにならない。オルガノイドとかもそうだったけど、研究の進展は思っているよりも大分と早い。どれだけ有望な最新技術でも3年経ったらすでに一般的である。結局、手法ではなく、研究のネタが重要である。
不安というか、ちょっと面倒くさいと思うこともある。まず、シングルセルRNAシークエンスでは複雑で難しい解析をやっており、こんなことを素で出来るのは天才しかいないため、パッケージや解析手法の開発に時間がかかる。その間、コンピューターの性能だけがどんどん進歩していき、それに対してパッケージが随分古くなっているような気がする。ScanpyとはSeuratも進歩が早いが、一方、その他の有用なパッケージがだんだんと古くなってきている。これの問題なところは、新しいシステムなのに、結構古いパッケージを使用しなくてはならなくなることであり、パッケージ間の依存関係を満たすのがきつくなっていくような気がする。今はSeuratObjectがV5なのに、あるパッケージではV3しか使えないとか、Pythonのバージョンが3.8以上だと他の依存関係を満たせなくなる、とかが良い例である。なので、RでもPythonでも、コンテナや仮想環境を使うことで現行のシステムから切り離して解析環境を作っていく必要がある。
まとめ2
pyhonって、やっていることがエクセルっぽい。だから、あんまり面白くない。まぁ、面白さでやってるんじゃあないんだけど…あ、だから最近Python in Excelってあるのか。
あのPython in Excelって使うひといるのか?それなら、はじめからPython使ったほうが良くないか?しかも、使えるパッケージはMicrosoftがエクセルに入れているものしか使えないという…それならなおさらPython使うやん。
しかも、イキってseabornとか使ってグラフ作っても、同じように他人のエクセルで動くん?絶対何か起こるやん。
Microsoftは、そういうことも考えてから実装してほしい。環境が複雑になるだけだし、逆に、「だれも使わないからやめた!」みたいなことを、平気でやりそうだし。いや、誰も使わないのわかるやん。もしPython in Excelを使っている人がいるとしたら、その人は先ず間違いなくPythonを使えるわけなので、そういうのが目的だとしたら、最初からPythonでやってるわけである。間抜けかよ。
